0.8相似度阈值失效:Embedding各向异性如何搞垮RAG
余弦相似度0.8没有通用含义,每次换Embedding模型必须重新校准阈值。
本文以一个RAG机器人的真实故障为引子:更换Embedding模型后,硬编码的0.8余弦相似度阈值导致机器人对所有问题都回答"我不知道",而系统没有任何报错。作者深入剖析了两个根本原因:一是Embedding模型的各向异性,使无关文本也能得到偏高的余弦相似度,形成因模型而异的"噪声地板";二是对比训练目标只优化排序而非绝对分数,使得0.8这个数字在不同模型间毫无可比性。文章给出了可操作的校准方法——测量随机配对的噪声地板、在带标注样本上拟合阈值——并推荐用相对信号(Top-1边际、分数vs噪声地板百分位)或交叉编码器重排序器作为更稳健的相关性判定方式,同时列出了每次更换Embedding模型时必须执行的检查清单。
一个RAG机器人只有一条安全规则:若最佳文档块的余弦相似度低于0.8,就回答"我不知道"。这条阈值规则稳定运行了数月,直到作者更换了Embedding模型并重新部署——机器人开始对所有问题都回答"我不知道",连"如何重置密码"这种有专门文档页的问题也不例外。
没有崩溃,没有报错。检索依然在第一位返回了正确的文档块,只是那道"安全闸门"每次都把它扔掉了。更糟的是,深挖之后作者发现,旧系统其实也是坏的——只是坏在了另一个方向。
换模型后到底发生了什么
模型迁移后,排序结果保留了下来,但分数的量纲彻底崩塌。所有相关匹配都远低于0.8阈值,于是闸门拒绝了全部结果。
作者在同一份内部文档语料上记录的日志大致如下:
| 指标 | 旧模型 (ada-002) | 新模型 (text-embedding-3-small) |
|---|---|---|
| 有真实答案问题的 Top-1 分数 | 中位数约 0.84 | 中位数约 0.55 |
| 两个随机无关块之间的分数 | 中位数约 0.72 | 中位数约 0.18 |
先看右列:新模型其实更擅长区分相关与无关内容,"真实答案"与"噪声"之间的差距变得更大。只是阈值本身卡在了整个分布之上。
再看左列:旧模型下随机垃圾得分0.72,真实答案得分0.84。所谓0.8的"安全"阈值,不过是夹在垃圾与黄金之间那0.12宽的狭缝里。作者拿一个关于那不勒斯披萨的离题测试问题,去匹配一份Kubernetes运维手册,竟然得到了0.77的分数——护栏仅靠三百分之一的差距勉强撑着。
换句话说,这道阈值从来不是护栏,只是对某一个模型恰好生效的巧合。
为什么无关文本的余弦相似度如此之高
根源在于绝大多数Embedding模型是**各向异性(anisotropic)**的:它们的向量并不均匀铺满整个球面,而是挤在一个狭窄的圆锥里。狭锥内任意两个向量之间的夹角都很小,于是无论文本内容是什么,余弦相似度都偏高。
这不是某家厂商的个别现象。早在对BERT和GPT-2表示的研究中就有记录(Ethayarajh, 2019 发现上下文Embedding占据一个狭窄圆锥),"表示退化(representation degeneration)"也在语言模型中被研究多年。
用十秒钟的数学就能看明白。把每个Embedding建模为共享分量加独特分量:
v = m + r
|m|^2 = a^2   (所有文本共享的方向)
|r|^2 = b^2   (使该文本独一无二的部分)
若各文本的独特分量彼此以及与 m 近似正交,则两段无关文本的余弦为:
cos(v1, v2) ≈ a^2 / (a^2 + b^2)
如果共享方向占据了每个向量平方长度的70%,那么两段毫无关联的文本得分约为0.7,真正的语义只能挤在剩下0.3的区间里。这正是 ada-002 的数据表现。不同模型的 a^2 / (a^2 + b^2) 比值各异——这个比值就是你的噪声地板(noise floor),而它不会印在包装盒上。
**各向异性(Anisotropy)**是指向量空间中方向分布不均匀的现象。理想情况下,Embedding模型应将不同语义的文本映射到高维球面上均匀分散的方向,这样任意两个无关文本的余弦相似度期望值接近0。但实际训练出来的语言模型并非如此——由于语言本身的统计规律(高频词、句法结构、话题分布),所有文本的Embedding向量会向某几个"公共方向"偏移,形成一个狭窄的圆锥区域。这意味着即便两段文本内容毫无关联,它们的向量也指向大致相同的方向,夹角很小,余弦相似度自然偏高。
这一问题在静态词向量时代就已存在(GloVe词向量的各向异性尤为严重),进入Transformer时代后因为上下文建模反而有所缓解,但未曾消失。不同的训练数据规模、训练目标和后处理方式都会影响最终的各向异性程度,这也是为什么两个看似同类的Embedding模型会有截然不同的"噪声地板"。
为什么分数量纲会随模型变化
因为训练目标从未要求过某个具体分数。多数Embedding模型用对比损失(InfoNCE 或其变体)训练,它只关心正确配对是否打败了错误配对。
单个查询的损失形如:
loss = -log( exp(s_pos / τ) / Σ_i exp(s_i / τ) )
给每个相似度 s_i 加上同一个常数 c,softmax 并不会改变——exp(c / τ) 这个因子在分子分母上下相消。因此模型完全可以把"无关"放在0.1,也可以放在0.7,训练过程对此毫不在意。
温度 τ 和训练数据决定了分数最终的分散程度。换个模型,就是换一套配方、换一套量纲,你那个0.8根本撑不过这趟迁移。
还有一个陷阱:如果你自己截短Embedding(把Matryoshka风格的向量切到更少维度),向量就不再是单位长度了。切完务必重新归一化,否则你算的"余弦"其实是一个范数在漂移的点积。
对比损失(Contrastive Loss),尤其是InfoNCE(Info Noise-Contrastive Estimation),是当前主流文本Embedding模型的核心训练目标。其基本思路是:给定一个查询,模型需要从一批候选中识别出真正匹配的正样本,同时压低其他负样本的分数。这本质上是一个多分类问题,损失函数只关心正样本的相对排名,而不关心任何分数的绝对值。
批次大小和负样本采样策略对最终分数分布影响很大。用"批内负样本(in-batch negatives)"训练时,模型从未见过"困难负样本"与正样本之间的绝对分数差应该是多少,它只学会了"正样本要比本批次其他样本得分更高"。这导致不同模型在分数绝对值上缺乏可比性——有的模型把正负对比压缩在0.7到0.9之间,有的则展开到0.1到0.9,全由训练配方决定,而这些细节通常不会出现在模型文档里。
余弦相似度阈值到底能不能用
能,但前提是它在你的语料上、用你确切的模型测量过,并且每当两者之一发生变化就重新测量。从博客、教程默认值或上一个模型照搬来的阈值,本质都是瞎猜。
向量检索给出的排序通常是可信的,但旁边那个绝对数值不可信——直到你校准它为止。
如何校准余弦相似度阈值
两步走:先测噪声地板,再在带标注的样本上拟合阈值。
第一步:噪声地板。 从自己的索引里随机抽样文档块配对,看它们的分布。这花不了一分钟,却能告诉你"无关"对这个模型意味着什么:
import numpy as np

def noise_floor(E, n=5000, seed=0):
    """E: (N, d) 单位归一化的块Embedding数组。"""
    rng = np.random.default_rng(seed)
    i = rng.integers(0, len(E), n)
    j = rng.integers(0, len(E), n)
    keep = i != j
    sims = np.einsum("nd,nd->n", E[i[keep]], E[j[keep]])
    return np.percentile(sims, [5, 50, 95, 99])
同一语料的随机配对会稍微高估"无关"(毕竟块之间共享主题和术语),但这没关系,你要的本就是一个保守的地板。
第二步:带标注样本集。 写40-50个文档能回答的问题,再写40-50个文档回答不了的问题,记录每个问题的 Top-1 分数,然后挑出能达到你所需精确率的阈值:
def pick_threshold(pos_scores, neg_scores, min_precision=0.95):
    candidates = sorted(set(pos_scores) | set(neg_scores))
    for t in candidates:
        tp = sum(s >= t for s in pos_scores)
        fp = sum(s >= t for s in neg_scores)
        if tp and tp / (tp + fp) >= min_precision:
            return t, tp / len(pos_scores)  # 阈值, 召回率
    return None, 0.0
如果没有任何阈值能在合理召回下达到目标精确率,那问题就不在阈值了——你的Embedding压根无法区分这些问题,你需要的是重排序器或更好的分块。
把模型名和版本号和阈值一起存进配置里。当有人升级模型时,过期的阈值应该吵闹地报错,而不是悄无声息地继续用。
均值中心化能否修复各向异性
对于共享方向很强的模型,它帮助很大。减去语料均值向量、重新归一化,圆锥就会张开。这正是"all-but-the-top"后处理(Mu and Viswanath, 2018)的思路,它还会移除少数几个主成分。
mu = E.mean(axis=0)

def center(x):
    x = x - mu
    return x / np.linalg.norm(x, axis=-1, keepdims=True)

E_c = center(E)
q_c = center(q)  # 查询永远用相同的 mu
它的坑是运维层面而非数学层面的:
- 查询必须用与语料完全相同的
mu做中心化。 mu会随语料增长而漂移,需定期重算并重新Embedding或重新中心化索引。- 你的向量索引(pgvector、FAISS 等)必须存储中心化后的向量,这意味着这是一次重建索引,而不是改个开关。
中心化让分数更易读,但不等于让它校准了。你仍然得跑第二步。
"all-but-the-top"后处理(Mu & Viswanath, 2018)是专门针对各向异性提出的轻量级修复方案。其完整版本分两步:第一步减去整个语料的均值向量(消除公共偏移方向),第二步识别出协方差矩阵的前D个主成分方向并从每个向量中投影去除(D通常取1到5)。仅做第一步(减均值)即为"均值中心化",已能覆盖大部分收益。
该方法之所以有效,是因为各向异性的根源正是少数几个主方向支配了向量空间——减去均值并移除主成分,相当于强制把向量推离那个狭窄圆锥,让剩余方向更均匀地承载语义差异。在词向量和部分句子Embedding上,这一后处理能将词类比任务的准确率提升数个百分点,并显著降低随机配对的余弦相似度基线。但如文中所述,它解决的是"分数可读性"问题,并不自动提供一个校准好的阈值,两者需要结合使用。
不用原始分数,该用什么作为闸门
应该用那些能挺过模型更换的信号。作者亲测有效的三种:
- 分数 vs. 噪声地板。 只有当 Top-1 命中超过随机配对相似度的第99百分位时才接受它。模型一变,重算地板,闸门随之移动。
- Top-1 边际。 当查询真的匹配到某个内容时,Top-1 命中通常会从后几名中脱颖而出;匹配不到任何东西时,分数会扁平化。
top1 - median(top2..top10)是一个廉价、与量纲无关的相对信号。 - 交叉编码器重排序器负责最终的相关性判定。它同时读取查询和文档块,直接判断相关性,而不是比较两个独立向量。它的分数同样需要校准(很多输出原始 logits),但它区分相关与无关要干净得多。
交叉编码器(Cross-Encoder)重排序器与双塔式Embedding模型在架构上有根本区别。Embedding模型是"双编码器":查询和文档分别独立编码为向量,相似度通过向量点积/余弦计算,检索时可预先建索引,速度极快。交叉编码器则将查询和文档拼接后一起输入模型,通过完整的注意力交互直接输出相关性分数,无法预计算,延迟较高,但判断质量远优于向量相似度。
在RAG系统中,常见的做法是"粗排+精排"两阶段:先用Embedding向量检索出Top-20至Top-100候选(召回阶段),再用交叉编码器对这些候选重新打分并取Top-3(重排阶段),最终只把重排后的结果送入LLM生成答案。这样既保留了向量检索的速度优势,又获得了交叉编码器的语义理解精度。开源社区常用的交叉编码器包括 cross-encoder/ms-marco-MiniLM 系列,也可使用托管API(如Cohere Rerank)。其输出的相关性分数同样需要根据自身任务校准阈值,但因为模型直接建模"相关vs不相关",分数含义比余弦相似度稳定得多。
每次换Embedding都要跑的检查清单
- 重新Embedding一个样本,画出随机配对分布,记下 p50 和 p99。
- 重新给标注集打分,重新挑选阈值,连同模型名一起提交。
- 检查向量范数。若不接近1.0,就归一化,或有意识地切换到点积。
- 对标注集做新旧 Top-1 结果的 diff。排序的变化才是迁移真正的风险。
- 当"我不知道"的比率飙升时发出告警。这个指标本可以在一小时内就发现那次故障,而不是拖一天。
那么余弦相似度0.8究竟意味着什么
单独看,什么也不意味。像0.8这样的余弦阈值只在某个特定Embedding模型、某份特定语料的相对意义下才有价值——因为各向异性和对比训练让每个模型都带着自己的分数量纲和噪声地板。无关文本在一个模型里可能得0.7,在另一个模型里可能只有0.15。
相信向量检索给你的排序,把那个数字视作未校准的,直到你在自己的索引里测过随机配对相似度、从标注样本中选出阈值为止。然后,每次换模型都把这两件事重做一遍。
相关推荐
Gemini 4 维护 Chromium:两周完成数月代码量
开发者利用 Gemini 4 Argon 维护 Chromium 代码库,两周完成过去数月工作。AI 代理同时发起 20 个变更,全部通过数十万次测试,突破大型代码库的维护瓶颈。
Codex保姆级攻略:从安装到实战,一期精通AI桌面助手
基于B站热门教程,详解Codex从安装到实战的完整流程:与豆包的本质区别、项目概念、文件整理与仪表板生成两大实战案例,以及计划模式和桌面宠物等特色功能,帮你快速上手这款能直接操作电脑的AI助手。
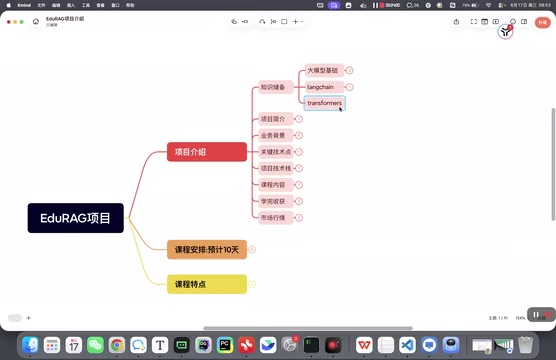
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。