深度
AI 领域长篇解读、行业观察、技术分析 —— 慢下来读一篇。

用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。

GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。
dSpark:用调度蒸馏让扩散语言模型学会"先解锁谁"
扩散语言模型常因解码轮次过多而变慢。VILA-Lab 提出 dSpark,用调度蒸馏学习"先解锁哪个 token",在 GSM8K 上于 LLaDA-8B-Instruct 和 Dream-7B-Instruct 分别实现 10.12 倍和 5.12 倍加速,并保持任务表现。
选择性平局学习:偏好优化中伪相关的新解法
本文介绍Selective Tie Learning:通过理论分析选择影响最大的平局数据,以更少数据减少偏好优化中的伪相关,实验覆盖对数线性策略、神经网络和大型语言模型,并探讨其实际应用与局限。

FOCUS:主动评论家学习破解长程智能体信用分配难题
FOCUS 提出选择性分支与主动评论家学习,缓解长程语言模型智能体的信用分配难题,在 BrowseComp-Plus 等基准上以匹配预算超越 GRPO 和 VinePPO。
预训练知“什么”,仿真教“如何”:ZAP让机器人零真实数据达96.7%成功率
ZAP提出零真实数据机器人训练方案:用27B预训练视觉语言模型提供世界理解,用仿真教会动作技能,真实任务成功率达96.7%,追平GPT-6 Astra且快3倍、省17倍,并展现组合泛化与跨embodiment迁移能力。
VGGT的自我认知:冻结特征预判位姿失败,ROC-AUC 93.5%
研究发现VGGT冻结特征中的线性探针能以ROC-AUC 93.5%预判位姿失败,优于模型自带置信度,且可迁移至其他数据集,为前馈三维重建的不确定性估计提供新思路。
信息论安全聚合:异构量化下的联邦学习隐私新方案
本文介绍一种信息论安全聚合方案,解决联邦学习中客户端异构量化带来的隐私泄露问题。该方案利用阈值秘密共享,容忍掉线和共谋,确保服务器仅获得聚合总和而不泄露单个更新。
Work Agents:从模型到系统,智能体如何可靠完成数字工作
论文提出以工作为中心的系统级视角,将工作智能体定义为基础模型与运行时harness的组合,用工作持续性与开放性刻画条件,梳理五类核心能力、三层优化路径与以工作成果为导向的评估方法。

当学习信号不再连续:不稳定性新解
新研究揭示:当梯度信号稀疏、间歇且嘈杂时,学习可能不稳定,即使平均动态收敛,方差也可能渐近无穷。文章分析稳定学习的显式条件及其对生物合理学习模型的启示。
FLORE:让机器人学会「用力」的人形机器人操作框架
FLORE是一个学习力反应式人形机器人移动操作的框架,通过无机器人演示采集、力反应扩散策略和混合柔顺控制器,在接触密集任务中实现80%成功率,远超位置策略的26.7%。
美光台湾工厂加薪2.7倍:AI芯片热潮下的用工争夺
美光台湾工厂计划将产线工人薪资提升至2.7倍,反映AI芯片热潮下存储厂商对熟练人力的争夺。本文分析加薪背后的产能压力、台湾半导体人力紧张格局及对行业用工成本的潜在影响。
Auto-Research Arena:自动研究系统的基准测试与前沿探索
Auto-Research Arena 是一个多目标基准,用于评估自动研究系统并在语言建模中发现新想法。它通过分离可采纳性与改进性,支持多样化的研究目标,并在语言模型预训练中实例化了九个目标。评估显示简单基线超越复杂方法,揭示了系统的提升空间。
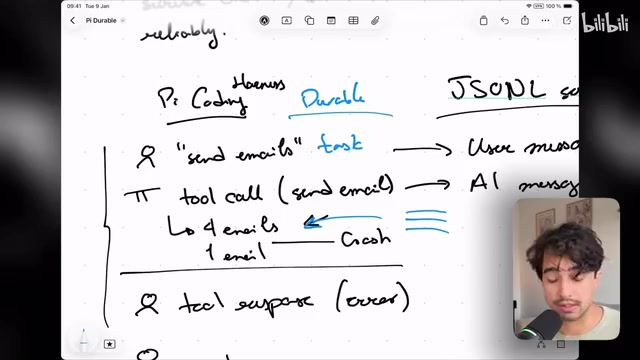
Pi Durable详解:为始终在线Agent构建持久化运行框架
深入解析Pi Durable智能体运行框架:如何通过检查点和SQLite持久化让Agent在崩溃后自动恢复,与Pi Coding Agent的核心差异,Harness层架构定位,以及用本地小模型搭建始终在线智能体的完整实战演示。
BriLLM-MetaPred:首个从AGI数学理论推导的语言模型
BriLLM-MetaPred 是首个由 AGI 数学理论推导的机器学习原语工程实现:用单一动力学状态统一表示与预测,通过自我测量提供内生自监督信号,训练推理对称耦合,预测性能与同规模 GPT 基线相当。

GEPA合并为何不稳定?机制级诊断揭示配置敏感与行为探针
GEPA合并算子跨模型不稳定?机制级诊断发现配置敏感性是主因,静态特征无法预测合并决策,行为探针可规避高风险失败但未超越NoMerge。

模型也会好奇?新研究量化LLM提问中的好奇心
一项研究提出「模型好奇心」概念,构建理论分类体系区分好奇心导向提问与一般提问。分析四个对话数据集发现,好奇心提问仅占17%-28%,但与更富探索性的用户回应相关,人类研究显示其在建议、创意和研究场景中尤其有用。

CLE基准发布:LLM智能体持续学习能力仅47.7%
CLE持续学习基准由50余位专家构建,含120个任务、600个层级,覆盖89种职业角色。评测显示前沿LLM最佳仅通过47.7%层级,反馈修订带来5.3个百分点提升,持续学习仍是智能体短板。

无模式Text-to-SQL:从查询日志学习企业数据库结构
新研究提出首个无需模式文档的Text-to-SQL框架,从历史查询日志构建知识图谱并引入实体驱动GraphRAG检索,在Beaver基准上执行有效性达95.7%,远超嵌入检索的60.8%,为模式模糊的企业数据库提供自然语言接口新路径。