1.2万仓库数据揭示:MCP生态没有中产,赢家通吃

1.2万仓库数据显示MCP生态极端头部化,中位服务器仅64星且七成安装路径断裂。
基于 GitHub 上 5,945 个 MCP 服务器与 6,589 个 Agent Skill 仓库的全量分析显示,MCP 生态呈极端赢家通吃结构:头部 1% 拿走服务器侧 47.5%、Skill 侧 41.7% 的 Star,Gini 系数分别达 0.867 与 0.882。62.8% 的服务器不足 100 星,中位数仅 64,但零星仓库只有 3.9%,典型状态是“在用但无人点星”。Skill 整体比 Server 更活跃,中位星数 160 对 64,近半年有 push 的比例 84.6% 对 64.2%。许可证以宽松型为主,真正的风险是两到三成仓库许可证缺失。最实用的发现是:仅 28.7% 的服务器能从 README 提取可执行安装命令,而 Skill 侧因统一约定达到 100%,修好安装说明是这个生态里杠杆最高的动作。
1.2万仓库数据揭示:MCP生态没有中产,赢家通吃
如果你以为MCP(Model Context Protocol)生态是一个健康的"长尾市场"——头部几个明星项目,中间一批中坚力量,底部大量小而美的工具——那这份基于12,534个去重仓库的全量数据会直接推翻这个假设。
MCPMarkets团队抓取了GitHub上5,945个MCP服务器和6,589个Agent Skill仓库(约92%覆盖率),做了一次完整的分布分析。结论可以用一句话概括:这是一个极高的头部、一片温吞的平原,以及中间一道深渊。
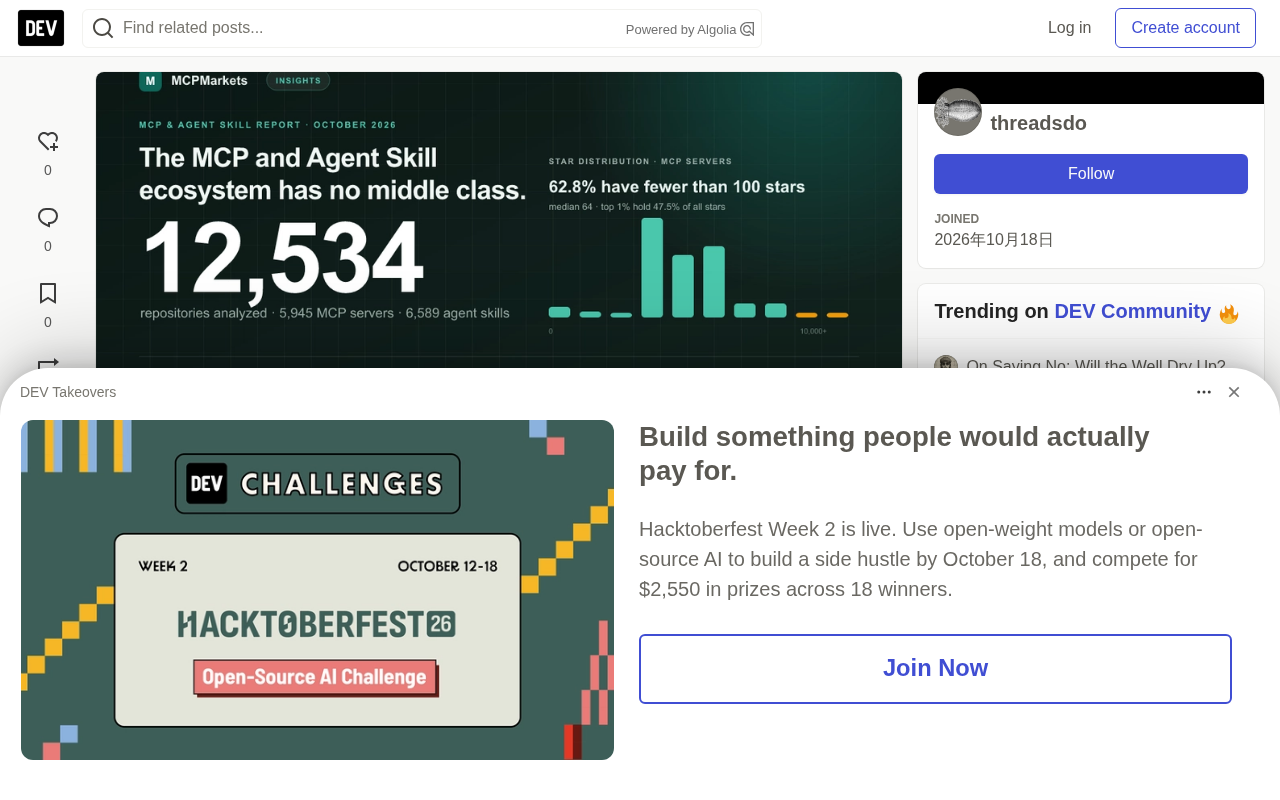
核心数字先摆在这里:头部1%的仓库拿走了服务器侧47.5%的Star(Skill侧41.7%),前10%合计约83%;62.8%的MCP服务器Star数不足100,中位数只有64;Gini系数服务器侧0.867、Skill侧0.882——贫富差距接近极端值。
头部比你想象的更窄
大多数人对生态的直觉是"二八分布",但实际数据比这更残酷。
服务器侧5,945个仓库共积累321万Star。分位数是这样的:p25只有36星,中位数64星,p75是166星,p90勉强到631星。但到了p99,数字直接跳到8,841——这是63倍的断层。均值与中位数之比达到8.4倍,几乎必然意味着极少数极端值在主导全局。
Skill侧的头部更夸张。全目录最大的仓库是一个Skill项目——openclaw广告/openclaw,392,124星,是服务器侧第一名(punkpeye/awesome-mcp-servers,96,415星)的四倍。前十大Skill仓库合计占全部Skill Star的15.6%。
这里有一个值得警惕的细节:榜首的awesome-mcp-servers本质上是一个"awesome清单",并不是真正的服务器实现,却被关键词规则归类为server。另一侧的vinta/awesome-python(327,970星)同样如此。头部很大程度是“注意力聚合器”,而不是“可用软件”。
还有一个耐人寻味的发现:anthropics/skills有181,394星,但license字段为空——创建协议的公司,从未为自己官方的示例仓库设置过许可证。
Gini系数是衡量分布不平等程度的常用指标,取值 0 到 1:0 表示绝对平均(每个仓库星数相同),1 表示绝对集中(所有星数集中在一个仓库)。经济学中常把 0.4 以上视为不平等偏高,0.6 以上属于警戒区间,而本文测得的 0.867 与 0.882 已接近理论极端值。换算成直觉:随机抽两个仓库,星数差距极大的概率接近九成。这也是为什么分位数在 p90 之前增长平缓、到 p99 突然跃升——均值被极少数超级仓库拉高,而中位数几乎不受影响,两者的比值(此处为 8.4 倍)正是这种长尾重尾结构的典型体征。
中位数64星才是常态,不是失败
把Star直方图摊开,你会看到一道不规则的"阶梯":11–50星区间塞了34.8%的仓库,101–500星区间聚集了25.1%,而中间的51–100星区间反而出现一个明显的凹槽(21.9%),再往上就是四位数的深沟。
93.1%的服务器不到1000星。但注意一个反直觉的数字:只有3.9%的仓库是零Star。也就是说,"完全没人看"是少数情况。典型的MCP服务器是**“在用,但几乎没人点星”**——它是某个团队的线上依赖,对其他人完全隐形。
Skill侧的分布形状相同,整体上移一个档位:37.1%低于100星,78.1%低于1000星,中位数160。
对开发者而言,40星的项目不是失败,它就是中位数的邻居。把Star当作目标函数,在这个生态里会持续自我怀疑。
分位数(percentile) 是把所有仓库按 Star 从低到高排序后,处于某个百分比位置的取值。p25=36 表示有 25% 的仓库星数不超过 36;p50 即中位数 64;p90=631 表示九成仓库不到 631 星;p99=8,841 则是只有前 1% 才达到的门槛。与均值不同,分位数不会被少数极端值扭曲,因此更适合描述这种重尾分布。文中反复引用分位数而非平均值,正是因为在这个生态里“平均星数”是一个几乎不存在的概念——它被少数头部仓库拉到了一个没有代表性的高度。
Skill比Server更热,而且差距不小
这是分析中原本没有预料到的方向:Skill仓库明显比Server仓库更"热"。
- 中位Star:160 vs 64,2.5倍差距
- 总Star:1417万 vs 321万,4.4倍
- 近六个月有push:84.6% vs 64.2%
- 休眠1–2年:Server侧20.4%,Skill侧几乎为零
- 万星俱乐部:256个Skill vs 54个Server
两个解释大概率同时成立。写一个Skill的门槛更低——一份SKILL.md本身就是交付物,没有协议层要实现;而Skill出现得更晚,正好赶上了Agent的叙事周期。
这个结论的实操含义有点反直觉:**Server侧看起来没那么拥挤,但它的中位生存环境更冷。**如果你要发布一个Server,“持续维护”本身就已经构成差异化——这一点在后面的维护数据里会更明显。
许可证不是问题,没有许可证才是
许可证分布出乎意料地干净。服务器侧58.4%是MIT,13.5%是Apache-2.0,宽松型许可证(MIT/Apache/BSD/ISC/CC0/Unlicense等)合计73.2%。带强传染性的AGPL加GPL一共只有5.0%。Skill侧类似:MIT 53.5%,宽松型合计66.4%,copyleft仅2.9%。
对使用者来说这是好消息——闭源使用、商业嵌入、二次分发,基本不会撞上许可证墙。
真正的风险在于模糊地带:未标注(unlabeled)加NOASSERTION,在服务器侧覆盖21.8%,Skill侧高达30.4%。"没有许可证"意味着每一个使用者都得自己回答一个法律问题,而大多数人会答错。
宽松型许可证(MIT、Apache-2.0、BSD、ISC 等)允许使用者自由使用、修改、闭源分发和商业集成,通常只要求保留版权声明;Apache-2.0 还额外包含专利授权条款。copyleft 许可证(GPL、AGPL)则要求衍生作品以同等许可开源,AGPL 的约束甚至延伸到通过网络提供服务的情形,因此对企业嵌入最不友好。NOASSERTION 是 GitHub 在对仓库文件做自动识别时给出的标记,意思是“检测到了许可证相关文件,但无法匹配到标准许可证”,其法律含义与“未标注”一样模糊——使用者无法据此判断自己是否被授权,这比明确禁止更棘手。
七成服务器的安装路径是断的
这项发现来自对README的解析。团队尝试为每个服务器提取一条可执行的安装命令(形如npx -y @modelcontextprotocol/server-xxx)和一段可直接粘贴的mcpServers JSON配置:
- 只有28.7%的服务器能提取出可执行安装命令
- 只有34.5%包含可用的配置片段
说白了,**超过七成的MCP服务器,安装路径是断的。**读者翻完README,仍然不知道该跑哪一条命令——要么外链回源码仓库,要么把配置埋进三百行散文里,要么提一句npm install就没了。
作为对照,Skill侧的安装命令提取率是100%,因为安装路径统一为npx skillfish add owner/repo/path。一个约定,零歧义。
这对维护者来说是最廉价的优势:把安装命令和JSON配置提到README顶部,各自用独立代码块包起来。十分钟的工作量,决定了一个用户是留下还是跳出。
MCP(Model Context Protocol) 是让 AI 客户端(如 Claude Desktop、各类 IDE 插件)以统一方式调用外部工具和数据的开放协议。一个 MCP 服务器对外暴露能力,客户端则通过一段 mcpServers JSON 配置来声明要连接哪个服务器、用什么传输方式(stdio 或 HTTP)、启动命令是什么。所谓“安装路径断了”,指的是 README 里既没有可直接执行的启动命令,也没有可直接粘贴进客户端配置文件的 JSON 片段,用户只能自行猜测包名、参数与传输方式——而协议在演进过程中配置字段和传输方式都改过,猜错的成本很高。这正是统一约定(如 Skill 的固定安装命令)能显著降低采用门槛的原因。
两成服务器已经"睡着"了
按最后一次上游push时间统计:64.2%的服务器在六个月内有过更新,15.3%在6–12个月,还有20.4%已经一两年没动过。Skill侧84.6%在半年内活跃,休眠一到两年的比例几乎为零。
问题在于,MCP的客户端配置格式和传输方式在这个窗口内改过不止一次。相当一部分休眠服务器其实已经"开箱即死",但它们仍然出现在各个目录的列表里,往往还排在前排——因为目录按Star排序。
"在维护"比"受欢迎"是更有用的筛选维度,而且展示成本极低:每个条目旁边附上最后push日期,就够了。
给建设者的三条实操建议
按预期影响排序:
第一,别盯着Star。 62.8%的服务器不到100星,中位数64。一个40星的服务器不是失败品,它是常态。优化对象是那一个真正采纳它的团队,而不是时间线。
第二,先修安装命令。 十个仓库里有七个的安装命令是坏的。一条可复制粘贴的命令加一段现成的mcpServers配置,是这个生态里杠杆率最高的十分钟。
第三,只要保持维护就够了。 五分之一的服务仓库在沉睡。如果你发布一个真能跑的服务器并让它持续可用,你已经处在前20%的"下季度还能用"区间——而且这一点能通过提交日期自证。
最后一条给数据读者的元经验:**头部是清单,尾部才是市场。**按Star排出的顶层大量是聚合清单和索引项目(两侧前五里各有两个awesome-list),真正可用软件的供给,藏在11–50和101–500这两个没人写发布稿的区间里。
数据本身的边界
这份分析有几处必须明说的局限:分类基于关键词启发式,混入了一些明显的清单类仓库,会抬高头部数字,但不影响尾部形状;Star衡量的是曝光而非使用,缺少npm/PyPI下载数据,无法区分"被点星"和"被使用";快照覆盖约92%,绝对计数偏保守;分类体系尚早,89%的服务器条目落在"开发者工具"一个类目下,因此未做类目级分析。
所有数字都可从公开目录复现。这是一份季度系列报告的第一期,下一期将聚焦类目级分析和安装命令覆盖率的变化趋势。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。