1000+ TPU上跑通310B全参数RL:小米MiMo-V2.6的工程突破

Peano AI在千卡TPU集群上完成310B MiMo-V2.6全参数强化学习,实现比特级训练推理对齐与2秒参数同步。
Peano AI近日宣布在超过1000块TPU的集群上,为小米310B参数的MiMo-V2.6模型完整运行了全参数强化学习。技术亮点集中于三点:采用vLLM驱动rollout采样以保证吞吐效率;训练器与推理引擎实现比特级数值匹配,从根本上消除train-inference mismatch这一RL训练常见隐患;以及利用TPU的ICI高速互联网络,在2秒内完成310B参数的全量同步,展示了TPU架构在超大规模参数搬运上的硬件优势。这一工程实践表明,TPU正成为超大规模RL训练的可行技术路线,同时也折射出业界对训练稳定性与数值一致性的日益重视。目前具体训练效果与模型性能提升数据尚未公开,有待后续完整技术报告验证。
千卡TPU集群上的全参数强化学习
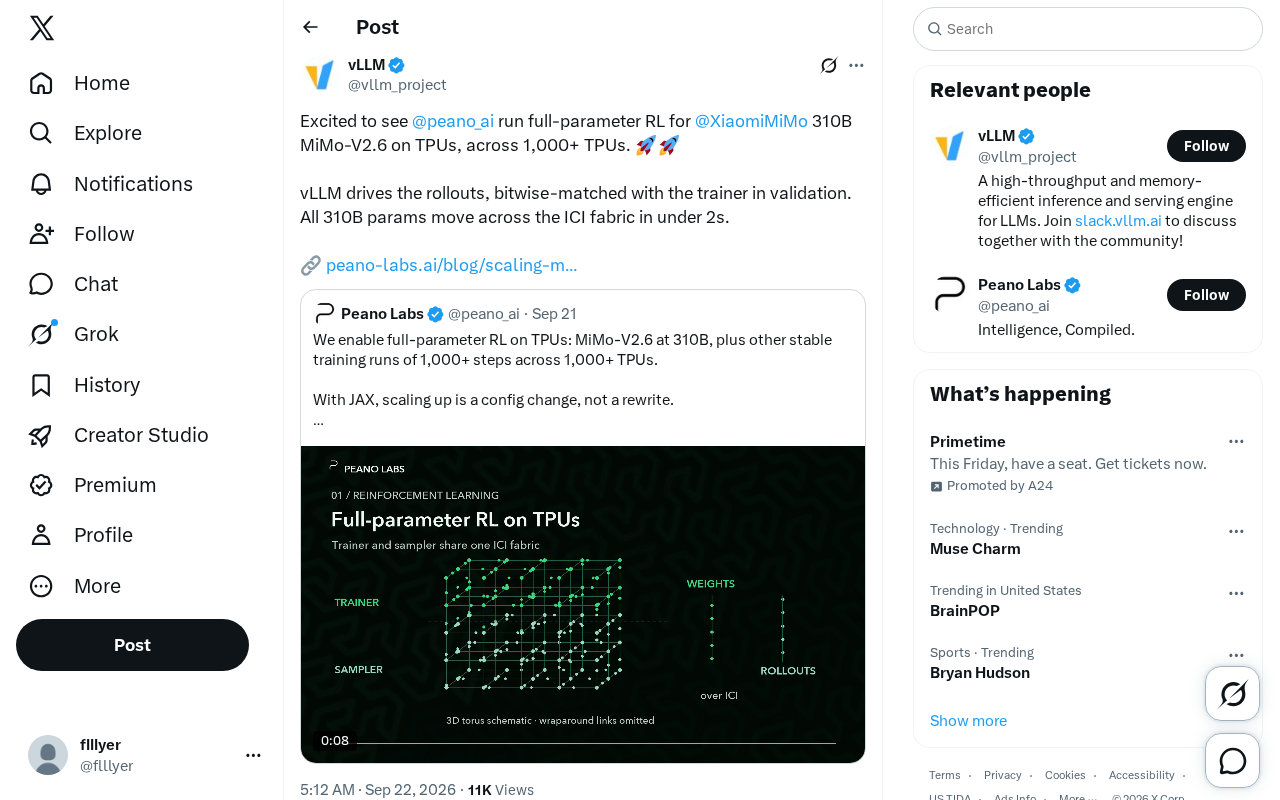
近日,一条来自Twitter的技术动态引发了业界对大模型强化学习工程能力的关注。Peano AI团队宣布,成功在超过1000块TPU的集群上,为小米(@XiaomiMiMo)310B参数规模的MiMo-V2.6模型运行了全参数强化学习(full-parameter RL)。
这一消息之所以值得关注,是因为在如此大规模的模型上进行全参数RL,而非仅微调部分参数或采用LoRA等轻量化方案,对底层基础设施、通信带宽和训练稳定性都提出了极高的要求。对于一个310B(3100亿)参数量级的模型来说,能够在千卡规模的TPU上把RL流程完整跑通,本身就是一项不小的系统工程成就。
vLLM驱动Rollout与训练器的比特级对齐
从原文披露的细节看,这套系统的技术亮点集中在几个关键环节。
首推的是推理引擎的选择:vLLM负责驱动rollout(采样生成)过程。在RL训练中,rollout阶段需要模型根据当前策略大量生成样本,这一步的吞吐效率直接决定了整个训练循环的速度。vLLM作为高性能推理框架,在这里承担了生成端的重任。
更值得称道的是,团队在验证环节实现了rollout与训练器(trainer)之间的比特级匹配(bitwise-matched)。这意味着推理阶段生成样本时所用的模型计算,与训练阶段更新参数时的模型计算在数值上完全一致,不存在因框架差异或精度处理不同而产生的偏差。
在实际的RL工程中,训练器与推理引擎通常是两套独立的实现,二者之间的数值不一致(train-inference mismatch)是导致训练不稳定、策略退化的常见隐患。做到比特级对齐,说明团队在数值一致性上投入了扎实的工程验证,这对RL训练的稳定性和结果可复现性都有直接价值。
RL中的rollout是强化学习训练循环的核心环节:策略模型(policy model)在当前参数状态下对输入prompt进行自回归解码,生成若干条完整的输出序列,再由奖励模型(reward model)对这些序列打分,最终以打分信号驱动策略参数更新(如PPO、GRPO等算法)。对于超大规模模型,rollout阶段往往是整个训练循环的吞吐瓶颈,因为它需要反复调用完整模型进行前向推理。vLLM通过PagedAttention、连续批处理(continuous batching)等机制大幅提升推理吞吐,使得在千卡规模下生成足量训练样本成为可能。
**比特级匹配(bitwise matching)**的难点在于:训练框架(如JAX/XLA on TPU)与推理引擎(如vLLM)在算子实现、混合精度策略、数值累加顺序上往往存在细微差异,这些差异会导致同一套权重在两侧产生不同的输出logit。在RL训练中,这种数值漂移会直接影响重要性采样比率(importance sampling ratio)的计算,进而造成策略梯度估计偏差、训练不稳定乃至策略崩溃(policy collapse)。实现比特级一致通常需要统一底层算子路径或引入严格的数值校验流程。
310B参数2秒内穿越ICI互联网络
另一个抓人眼球的数字是通信性能:全部310B参数在ICI(Inter-Chip Interconnect,芯片间互联)网络上的传输在2秒内完成。
ICI是Google TPU集群中连接各芯片的高速互联结构,是TPU区别于GPU集群的重要架构特征之一。在全参数RL的训练循环中,参数需要在训练器与推理引擎之间同步——每一轮策略更新后,新的参数权重都要下发到负责rollout的实例上。对于310B规模的模型,这个参数搬运的开销如果处理不当,会成为严重的性能瓶颈。
把3100亿参数的完整同步压缩到2秒以内,充分利用了TPU ICI fabric的高带宽特性,说明这套流水线在参数传输这一环上做了深度优化。这也侧面印证了TPU互联架构在超大规模模型训练场景中的竞争力。
**ICI(Inter-Chip Interconnect)**是Google TPU pod内部芯片间直接互联的高速网络,不经过主机CPU或传统以太网,带宽可达数百GB/s量级。与GPU集群中常见的NVLink(单机)+ InfiniBand/RoCE(跨机)的两层网络结构不同,TPU的ICI在pod内形成一个统一的高维Torus拓扑(如3D或4D Torus),使得大规模AllReduce、参数广播等集合通信操作可以在硬件层面高效执行,延迟和带宽利用率均优于软件层面的跨机通信方案。
310B参数在float16精度下约占620GB存储,在bfloat16下同样如此。2秒内完成全量参数的广播同步,意味着有效带宽需达到310GB/s以上(仅计单向传输),这充分说明ICI fabric在参数搬运这一典型"大消息、低频次"通信模式下的高效性。对比之下,GPU集群跨机参数同步通常受制于InfiniBand带宽上限,在相同规模下往往需要更长时间或更复杂的流水掩盖策略。
为什么这件事值得关注
把这几个技术点串联起来,能看到一条相对完整的大规模RL工程实践路径:vLLM负责高效采样,训练器负责参数更新,二者通过ICI高速网络快速同步,并在数值上保持比特级一致。
对行业而言,这条动态传递出几个信号:
- TPU正在成为超大模型RL训练的可行选择。以往大模型训练与RL的讨论多集中在GPU生态,而在千卡TPU上跑通310B全参数RL,展示了另一条可落地的技术路线。
- 国产大模型的工程深度在提升。小米MiMo系列作为参与方,能够支撑起如此规模的RL实验,反映出国内团队在大模型训练基础设施上的积累。
- train-inference一致性正成为RL工程的核心议题。比特级匹配被专门提及,说明业界越来越重视这一长期被忽视的稳定性隐患。
需要说明的是,这条动态属于初步的技术进展披露,具体的训练效果、模型性能提升幅度以及成本数据尚未公开。这项工作最终能带来多大的模型能力提升,还有待更完整的技术报告或评测结果来验证。
小结
在1000+块TPU上完成310B MiMo-V2.6的全参数强化学习,是一次典型的大模型系统工程展示。vLLM驱动的rollout、训练器与推理的比特级对齐、310B参数2秒内的ICI同步,这三点共同构成了这套流水线的技术看点。它既体现了TPU互联架构在超大规模场景下的潜力,也反映出RL工程正朝着更大规模、更高一致性的方向演进。
相关推荐

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。