1000小时Claude Code实战:六个等级从入门到精通

一位千小时用户把 Claude Code 经验压缩成六级进阶体系与适用边界。
文章将 Claude Code 的使用能力拆成六级递进体系:第一级是用 commit 与读 diff 两个保命习惯,加上一份只写"决定"、控制在一页内的 CLAUDE.md 项目记忆;第二级是用 Plan 模式在计划阶段最便宜地捕获错误,并用点名文件、说清完成标准的精确提示替代模糊请求;第三级是让"完成"被真正验证,靠先测试后实现、类型检查与 linter、hook、浏览器集成和干净上下文的第二意见,以及 Skill 沉淀可复用流程;第四级是管理 token 预算与上下文,看懂 /context、/usage,及时重开会话或用交接文件;第五级用子代理、work tree 和定时任务放手并行,但要窄范围、可检查。最后给出适用边界:几行已知改动自己写更划算,方法也适用于其他编码代理。
Claude Code 不是聊天窗口,而是一个会直接编辑文件、运行命令的编程代理。一位在 Claude Code 里投入超过一千小时的创作者,把这期间的全部经验压缩成了一套六级进阶体系。这套体系的价值不在于教你点哪个按钮,而在于帮你判断自己现在处于哪个水平,以及下一步该补什么。
第一级:两个保命习惯与项目记忆
Claude Code 与普通对话工具的根本区别在于:它改的是你的项目文件。一次错误的编辑不会像聊天回答那样被忽略,它已经躺在你的代码里了。所以从第一天起就要养成两个习惯:每次会话前先 commit,让 Git 始终有一个干净的回头点;每次批准前读 diff,因为权限提示展示的正是即将发生的变化。
这两个习惯之后,重心转移到让错误编辑更少发生,核心是那个 Claude 每次动手前都会读取的文件——CLAUDE.md。这是你控制的"项目记忆",每次会话开始时加载。但大多数人的写法都在浪费 token 或埋下隐患。
最常见的四种失误:把自动生成的草稿当成成品文件(它描述的是 Claude 读代码就能知道的文件夹结构,每多一行都是每次提示的额外成本);写"描述"而不是"决定"("项目用 React"没有信息量,"用 pnpm 绝不用 npm"才是规则);试图第一天就写全所有规则(有效的规则来自纠正——Claude 做错了,你修好,再加一行防止重犯);让它过期(换了库、删了文件夹,规则要同步更新)。
还有三类东西绝不能放进去:密码和 API key(文件进了 Git 就是风险)、linter 已经强制执行的风格规则(linter 更便宜且不会忘)、长篇文档。另外,只对后端有意义的规则应该放在 backend 文件夹内的 CLAUDE.md 里,跨项目通用的偏好(比如 commit message 写法)则放在 home 目录的 .claude 文件夹中,避免混进团队仓库。
第一级的达标标准:CLAUDE.md 控制在一页以内,你能说出每一行防止的是哪种错误,Claude 不再一天问你五十次权限。
第二级:Plan 模式与提示词的精确度
输入框下方可以在 Normal、Accepting edits 和 Plan 模式之间切换(Shift+Tab 循环)。Plan 模式下 Claude 只能读和搜,不改任何东西,最终交出一份书面计划。
Plan 模式并非万能。如果你已经知道确切改法、且只涉及一个文件,研究阶段纯属浪费 token。它真正划算的场景是任务跨多个文件,或者你自己也不确定该怎么做。计划是捕获错误最便宜的地方——如果 Claude 理解错了任务,你在一段十几行的文字里就能看出来,而不是在八个被改动的文件里事后发现。改计划只要一条消息,改代码则要 review、revert、再跑一遍,同样的 token 再烧一次。
审查计划时,像读一个新人的 pull request 那样读它。模糊的步骤("更新相关组件")通常意味着 Claude 根本没找到要改的代码;警惕引入你已经有的库;警惕与任务无关的文件改动或清理。如果没有一步说明结果将如何验证,打回去。打回时要具体:指出第三步用已有的日期库,删掉第五步,末尾加一步跑现有测试。
提示词同样如此。Claude 擅长执行你说的,极不擅长猜你的意思。对比两个提示:"加个暗色模式"是完整请求,Claude 会遍历所有样式表、自选方案、甚至引入新库;而"用 src/style/theme.css 里的 CSS 变量加暗色主题,不加新依赖,开关放 header 里 profile 菜单旁边,选择存 localStorage,不要碰邮件模板"——同一个功能,但后者告诉它去哪找、什么不能碰、什么叫完成。当你自己也不确定时,反过来让它先问你问题再写计划。
这一级的达标:你读每份计划后才批准,已经改过或拒绝过几份,你的提示词点名了文件并说清了完成标准。
第三级:让"完成"真的被验证过
Claude 说 done,只代表模型停了,不代表代码能跑。这一级是给它自查的手段。
测试的顺序很关键:先要测试,确认测试描述的是你真想要的行为,然后才让它写实现。如果代码先行、测试后补,测试往往只是在描述代码现有的行为——包括 bug。还要防另一个捷径:测试失败时模型有时会改测试而不是修代码,在 CLAUDE.md 里加一行"只有我说改测试时才改测试"。
拿一个 bug 举例:优惠码过期后仍能用。不要直接让它修,先让它写一个复现问题的测试——昨天过期的码今天应用必须被拒绝。跑一遍,它应该失败,这个失败才是有用的,它证明测试确实能抓住这个 bug。然后要修复,条件是测试保持不变。转绿时你知道修复处理了这个例子,而测试留在项目里,下个改动无法让同一个 bug 溜回来。
穷举式的检查:类型检查和 linter 运行只要几秒,写进 CLAUDE.md 的完成标准里,让它们在你看到 diff 之前就拦下一整类错误。如果不指望模型自觉,可以用 hook——Claude Code 在会话固定节点自动执行的命令,比如每次编辑后自动跑 linter,或者阻止任何触碰 .env 和 migrations 文件夹的改动。
视觉类任务有另一个问题:Claude 写了 CSS 但从没见过页面。通过 Chrome 集成或 Playwright 这类浏览器 MCP 给它一个浏览器,它就能打开应用、点击流程、截图自己造出来的东西。浏览器检查很吃 token(每张截图和页面快照都进上下文),留到最后一轮,别每次微调都用。
还有一个零成本的检查——干净的上下文第二意见。功能完成后开个新会话或让子代理对照你最初的需求 review diff,记得贴上原始任务,因为新会话不知道拿什么做对比。它没有经历那场长对话,不携带第一场会话沿途积累的假设,更容易发现遗漏。
这一级还包括 Skill。一个 Skill 是一个含 SKILL.md 的文件夹,顶部有名字和一行描述——这行描述是 Claude 永远放在上下文里的唯一部分。下面是按"讲给新同事听"的方式写的步骤:路由放哪、用什么校验、先写测试、跑检查、更新文档。当你请求新端点时,Claude 用描述匹配请求并加载完整步骤,或者你用斜杠手动调用。所以描述要写成"何时使用"的形式。Skill 与 CLAUDE.md 的核心区别:CLAUDE.md 每次都读,只该放每次都重要的内容;Skill 在用到之前几乎零成本,所以可以又长又细。
Skill 和 MCP server 常被混淆。区分很简单:Skill 是"知识",告诉 Claude 怎么做;MCP server 是"访问",让它够到代码之外的东西,比如数据库、issue tracker、设计文件或浏览器。如果问题是 Claude 做事方式不对,写 Skill;如果问题是 Claude 根本看不到它需要的东西,才考虑 MCP server。而且先确认是否真的需要——如果工具已有命令行版本(GitHub CLI、数据库客户端),Claude 往往直接在 shell 里跑就行,在真正使用前不占用上下文。
Hook 的机制与配置位置:Hook 是 Claude Code 在会话生命周期固定节点自动触发的 shell 命令,可用的事件包括 PreToolUse(工具调用前)、PostToolUse(工具调用后)、UserPromptSubmit(提交提示时)、Notification 与 Stop 等。配置写在 .claude/settings.json 或项目根目录的 settings.local.json 里,按事件名分组,每条 hook 声明匹配器(如匹配 Edit/Write 工具)和要执行的命令。命令通过标准输入接收一段 JSON 描述本次事件(工具名、文件路径等),并可用退出码控制流程:退出码 2 表示阻断该操作并把 stderr 反馈给 Claude。因此"编辑后自动跑 linter"通常写成 PostToolUse 匹配 Edit|Write 执行格式化或检查;"阻止改动 .env"则更适合 PreToolUse,命中路径时以退出码 2 拒绝。Hook 在你本地 shell 中执行、拥有你的权限,配置前应确认命令来源可信,且它不消耗模型 token。
MCP(Model Context Protocol)是什么:MCP 是一套开放协议,用于把外部系统以标准化方式暴露给模型——每个 MCP server 对外声明一组工具(tools)、资源(resources)和提示模板(prompts),客户端(如 Claude Code)负责发现并把这些能力转成模型可调用的接口。这解释了文中"工具名预加载、详情按需拉取"的成本结构:server 连上后,其工具清单会以 JSON Schema 形式进入上下文,工具越多占用越大,几十个工具的 server 可能一次性吃掉可观的窗口空间。传输方式上,本地进程通常用 stdio,远程服务用 HTTP/SSE,凭据由用户在客户端配置,因此接入前要评估该 server 的权限范围。判断是否需要自建 server 的标准很简单:若目标系统已有稳定的 CLI 或 HTTP API,让 Claude 直接调命令行往往更省,只有需要结构化、可复用且模型不熟悉接口的场景才值得包装成 MCP。
第四级:Token 预算与上下文管理
订阅制下 token 就是钱。Claude Code 数的是 token——它读的、写的、每个工具返回的输出。Pro 和 Max 计划的用量按滚动 5 小时窗口计算,上面还有周限额。所以两个让 Claude 读半个仓库的提示,可能比二十个精准的小提示更贵。
两个 token 就能填满上下文窗口,那是会话的工作记忆;而质量在窗口填满之前就开始下滑——会话早期的指令获得的注意力变少,Claude 重复已做过的检查,或者悄悄推翻你一小时前的决定。更大的窗口给你更多空间,但不会让一场漫长混乱的会话表现得像新会话。
输入 /context 可以看到当前窗口里都坐着什么:系统提示、系统工具、MCP 工具、记忆文件(CLAUDE.md)、skills、对话消息,以及剩余空间。值得在全新会话里、打第一个字之前跑一次,因为那个数字就是每次会话在你开口前的固定成本。MCP server 通常也出现在这份明细里。新版 Claude Code 只预先加载工具名,需要时才拉详情,但如果你关掉这个机制或把某个 server 标为始终加载,它所有的工具描述都会落进上下文——有些 server 有几十个工具。为一次性任务连了五个 server 然后忘了关,你会在每个会话里持续付费。跑 /mcp 看连了什么,关掉这个项目不需要的。
另一个数字是 /usage,显示当前 5 小时窗口和周限额已用多少、何时重置。做任何大规模动作前(比如全项目重构,或一个你打算放着跑的循环)值得先看一眼。发现干不完,比干到一半才发现便宜得多。
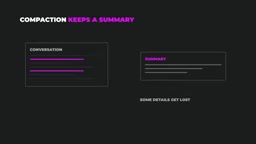
窗口满了会自动 compact,摘要对话后继续。但摘要会丢细节,而自动摘要不知道哪些细节对你重要。如果确实要在同一会话里继续,自己跑 /compact 并告诉它保留什么,比如保留 API 决策和失败的测试列表。多数时候更好的做法是给每个任务独立会话,做完 /clear 再开下一个。如果 Claude 开始翻与任务无关的文件,立刻按 Escape 纠正,因为它打开的每个文件都是 token。不是每个任务都需要最大的模型,/model 可以切换,例行的编辑用便宜模型最划算。
一个简单判断:还在同一个任务、窗口里的东西都还相关,就继续;任务变了、Claude 开始自相矛盾、或 /context 显示窗口快满了,就重开。清空之前让 Claude 写一份简短的交接文件——做了什么、做了哪些决定及原因、还剩什么——读一遍修正错误,然后让新会话指向这个文件。中间选项也有:/model 里的 opus plan 设置在 Plan 模式用 Opus,开始改动后切到 Sonnet,贵的模型做你真正要审的思考,便宜的做打字。
粘贴内容也要克制:整个日志文件塞进上下文并不划算,通常错误信息和最后几行就够了,或者告诉 Claude 日志在哪个文件、找什么。几个小命令能省下比体积更多的时间:连按两次 Escape 或输入 /rewind 可以把对话和 Claude 做的代码改动回滚到更早的点(它只跟踪 Claude 自己的文件编辑,不跟踪 shell 命令造成的改动,所以不替代 Git);误关终端后 claude continue 接续该文件夹上次对话,claude resume 给你历史会话列表;消息以感叹号开头会作为普通 shell 命令执行,输出落进对话里 Claude 也能看到;/status line 在终端底部设一条状态行,显示当前模型和上下文占用。
上下文窗口与压缩的本质:上下文窗口是模型单次推理能看到的全部 token 上限,系统提示、工具定义、记忆文件、对话历史与工具输出都挤在同一份额度里。模型对上下文中部信息的利用率通常低于开头和结尾,这被称为"lost in the middle"现象,也是质量在窗口填满之前就下滑的原因之一;指令在长对话里获得的注意力被稀释,模型于是重复检查或推翻早先的决定。Compact 的做法是把已有对话交给模型自身生成摘要,再用摘要替换原文继续——这是有损压缩,被丢弃的往往是具体数值、失败的测试名和约定细节,而摘要模型并不知道哪些对你关键。所以手动 /compact 附带保留指令,或干脆用交接文件加新会话,都比依赖自动摘要可靠;子代理的设计逻辑也在此:把大段探索留在它自己的窗口,只把结论带回主会话。
第五级:放手让 Claude 自己干活
子代理是主会话交给一个独立任务的单独 Claude 实例——翻文档、review diff——它在自己的上下文窗口工作,只回传摘要,主会话保持干净。用 /agents 创建,或者描述你要什么让 Claude 建一个。代价是每个子代理都是一整场对话,几个并行跑,限额消耗快好几倍。子代理以 markdown 文件存在 .claude/agents 文件夹,顶部设名字、告诉主会话何时交接的描述、允许使用的工具和运行的模型。比如一个 review 完成的 diff 的代理:只给读取和搜索工具,没有编辑工具、没有 shell(它的工作是报告不是修复),跑在 Sonnet 上,这样 review 不必花满血 Opus 的钱。
Work tree 解决的是另一个问题:它是同一项目的第二份工作副本,在独立文件夹和独立分支上,你可以在每个里跑独立的 Claude 会话,彼此不会覆盖文件。输入框下有个 work tree 开关,开启后新会话创建一份独立副本。注意新副本可能还没装依赖,让 Claude 装一下即可;任务完成后让它 commit 并把分支合回来。Work tree 本身不耗 token,但每个并行会话都从同一限额里扣,产出你仍要审,两三个会话之后就该收敛。
再往上是定时跑或跑到条件满足:loop 按间隔重复提示,但只在会话开着时有效,本身不是过夜任务;goal 让 Claude 持续工作直到某条件为真,比如所有测试通过且类型检查干净;claude -p 以非交互方式跑单个提示。真正的过夜任务需要独立调度器——机器上的 cron 或定时的 CI job——由它调用 claude -p。所有这些都在没人能及时喊停的情况下运行,所以给它们窄任务、可检查的结果:每晚跑测试、给失败项开 issue 是好例子,睡觉时把整个功能建完不是。
经验总结与适用边界
整套体系里,如果只能给第一天的人一句建议,那就是:三行你本来就会写的改动,直接自己写。向 Claude 解释它的时间比打字更长,还要额外付 token。三种情况下应该自己敲键盘——你知道确切改动且只有几行;解释上下文比写代码更费时;你在学习,想让知识进脑子而不只是进仓库。还有一种情况:Claude 把同一件事做错两次,第三次用同样的提示通常只是烧 token 换同样的结果,要么自己修,要么退一步想清楚提示缺了什么。
这套方法大部分也适用于其他编码代理,比如 Codex CLI、OpenCode 和 GitHub Copilot。Claude Code 是个强工具,但结果来自你怎么驱动它,而不是你打开了多少功能——控制、明确的提示和检查,比任何插件都重要。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。