109K参数的FilterFusion:CPU单线程实时视频去噪新方案

FilterFusion 以 109K 参数实现 1080p 实时视频去噪,CPU 单线程达 55.9 FPS。
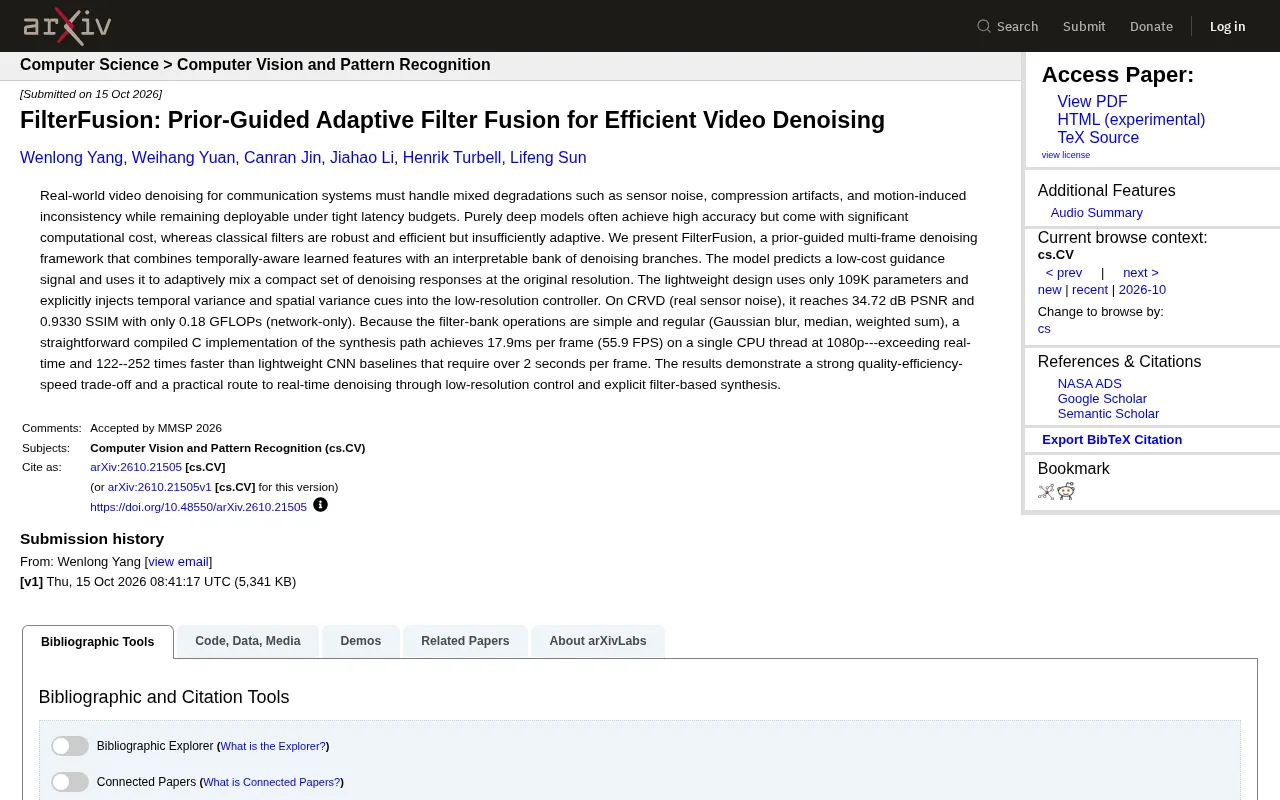
FilterFusion 针对真实视频去噪中画质、速度与算力难以兼顾的困境,提出低分辨率控制加全分辨率显式滤波合成的架构。模型在低分辨率空间生成引导信号,显式注入时间方差与空间方差先验,自适应混合高斯模糊、中值滤波等经典滤波器组的输出。整个网络仅 109K 参数、0.18 GFLOPs,在 CRVD 数据集上达到 34.72 dB PSNR 和 0.9330 SSIM。其合成路径用 C 语言编译实现后,在 1080p 单 CPU 线程上达到 17.9ms/帧即 55.9 FPS,比轻量 CNN 基线快 122 至 252 倍。该工作验证了低分辨率控制驱动显式滤波合成这一工程路径在实时视频去噪中的可行性,为边缘设备与 CPU 环境部署提供了新思路,但在更复杂真实场景下的稳健性仍待进一步验证。
视频去噪一直面临一个尴尬的三角困境:画质、速度、算力,三者难以兼得。纯深度模型精度高但计算代价惊人,经典滤波器效率好但适应性不足。一篇来自RSS来源的新工作 FilterFusion 试图打破这个僵局——用区区 109K 参数,在 CPU 单线程上跑到 1080p 每秒 55.9 帧。
问题背景:混合退化下的实时去噪难题
通信系统中的真实视频去噪,面对的从来不是单一噪声。传感器噪声、压缩伪影、运动引起的时间不一致性往往同时存在,叠加在一起形成复杂的混合退化。
纯深度学习方法在这类场景下能达到很高的精度指标,但推理成本极高——一些轻量 CNN 基线处理单帧甚至需要 2 秒以上,在实时通信场景中完全不可用。经典滤波方法(高斯模糊、中值滤波等)则恰好相反:运算简单、鲁棒性好,但在面对多变的噪声类型时缺乏自适应性,无法根据内容动态调整。
FilterFusion 的思路是各取所长:用学习到的时序特征提供"先验指导",用可解释的滤波器组完成实际合成。
PSNR 与 SSIM 是视频/图像去噪领域最常用的两个质量评价指标。 PSNR(峰值信噪比)通过计算处理后图像与干净参考图像之间的均方误差来衡量失真程度,单位为分贝(dB),数值越高代表像素级误差越小。SSIM(结构相似性指数)则从亮度、对比度和结构三个维度评估两幅图像的感知相似度,取值在 0 到 1 之间,越接近 1 表示结构保留越好。二者互补:PSNR 关注逐像素精度,SSIM 更贴近人眼对结构信息的主观感知。在视频去噪论文中同时报告两者,是判断方法是否在保真度和视觉质量上都达标的标准做法。
CRVD(Captured Raw Video Denoising)是一个面向真实传感器噪声的视频去噪数据集。 与常见的合成噪声数据集不同,CRVD 通过专业设备同步采集真实场景下的含噪视频与干净参考,噪声来自传感器本身的物理特性,而非人为添加的高斯噪声。因此它更能反映通信系统中传感器噪声、压缩伪影与运动不一致性叠加的混合退化情况,也成为评估去噪方法实际落地能力的重要基准。
核心架构:低分辨率控制器 + 全分辨率滤波器组
FilterFusion 的整体设计围绕一个核心原则展开——把昂贵的决策放在低分辨率上做,把便宜的合成放在原始分辨率上做。
低分辨率控制器
模型首先预测一个低成本的引导信号(guidance signal),这个信号在低分辨率空间生成,负责决定如何混合不同的去噪分支。控制器显式地注入了两种先验线索:
- 时间方差(temporal variance):反映帧间运动引起的不一致性
- 空间方差(spatial variance):反映单帧内噪声的空间分布特征
将这两类方差线索注入低分辨率控制器,意味着模型在做混合决策时,已经"知道"了哪些区域运动剧烈、哪些区域噪声更重,从而有针对性地分配去噪强度。
可解释滤波器组
合成路径使用一个紧凑的滤波器组,包含高斯模糊、中值滤波、加权求和等经典操作。这些操作的特点是简单、规则、高度可预测——没有卷积神经网络的复杂算子,也因此为后续的工程优化留下了充足空间。
每条去噪分支产生一个响应,控制器根据引导信号自适应地混合这些响应。整个网络仅 109K 参数,网络本身的计算量只有 0.18 GFLOPs。
GFLOPs(十亿次浮点运算)是衡量神经网络推理计算量的常用单位。 一次 FLOP 指一次浮点加法或乘法,模型每处理一帧图像所需的总运算次数即为其计算量。0.18 GFLOPs 意味着该网络处理单帧仅需约 1.8 亿次浮点运算,相比动辄数十甚至上百 GFLOPs 的主流深度模型低了两到三个数量级。参数量(109K)与 GFLOPs 是两个不同维度:前者衡量模型存储占用,后者衡量运行时的计算开销。FilterFusion 两者都极低,才使得在纯 CPU 单线程上达到 55.9 FPS 成为可能——这正是"可编译的合成路径"设计带来的直接收益。
性能数据:34.72 dB PSNR 与 55.9 FPS 同时达成
在 CRVD(真实传感器噪声数据集)上的测试结果体现了这套设计的实际效果:
| 指标 | 数值 |
|---|---|
| PSNR | 34.72 dB |
| SSIM | 0.9330 |
| 网络计算量 | 0.18 GFLOPs |
| 参数量 | 109K |
| CPU 推理速度(1080p,单线程) | 17.9ms/帧(55.9 FPS) |
最值得关注的是推理速度这一栏。研究团队将合成路径用 C 语言编译实现后,在 1080p 分辨率、单 CPU 线程的条件下达到了 17.9ms 每帧,即 55.9 FPS——这不仅超过了实时阈值(通常为 30 FPS),而且比需要 2 秒以上处理单帧的轻量 CNN 基线快了 122 到 252 倍。
这种速度优势的直接来源是滤波器组操作的简单性和规则性。高斯模糊、中值滤波这类操作在编译后可以高效执行,不依赖 GPU 加速或专用推理框架。
设计哲学:低分辨率控制 + 显式滤波合成
FilterFusion 的贡献不只是一组数字,更在于它验证了一条工程路径的可行性:通过低分辨率控制来驱动显式滤波合成,可以在质量、效率和速度之间取得实用的平衡。
这条路径的启发在于,并非所有决策都需要在原始分辨率上完成。把"判断用什么滤波器、以什么比例混合"这类高层决策交给低分辨率控制器,把"实际执行滤波"交给高效的经典算子,既保留了学习的自适应性,又避免了端到端深度模型的计算冗余。
对于需要在通信系统、边缘设备或 CPU 环境下部署实时视频去噪的工程团队来说,这种"可编译的合成路径"意味着模型可以直接落地到现有基础设施上,而不必依赖 GPU 推理栈。
当然,该方法目前主要在 CRVD 数据集上验证,面对更复杂的真实场景(如剧烈运动、多源噪声叠加)时滤波器组的表现是否依然稳健,还需要进一步观察。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。