10分钟搭建本地MCP服务器:Python实现AI Agent工具集成
用一个纯Python文件,十分钟搭建本地MCP服务器,赋予AI Agent真实的文件系统操作与安全边界控制能力。
MCP(模型上下文协议)是连接大语言模型与外部工具的开放标准。本文通过一则实操演示,展示如何用单个Python文件快速构建本地MCP服务器,并接入Cursor编程环境。服务器暴露三个互补工具:列目录、预览文件开头、按扩展名递归搜索,构成AI Agent探索代码项目的最小工具集。演示中最具启示性的设计是服务器端的权限控制——当Cursor尝试读取密码文件时,服务器直接拒绝了请求,体现了"工具层防御"的安全原则,将约束逻辑从模型层下沉到执行层。面对"哪些Python文件import了pandas"这类复合问题,Cursor自主编排搜索与预览两个工具完成链式推理,展示了MCP赋予模型"主动规划行动"的Agent能力。本地部署兼具数据不出机、调试门槛低、工具可复用等优势,是理解AI Agent底层机制的理想起点。
什么是本地MCP服务器
MCP(Model Context Protocol,模型上下文协议)正在成为连接大语言模型与外部工具的标准接口。它让 AI 助手不再局限于纯文本对话,而能够主动调用自定义工具去读取文件、搜索目录、执行查询等实际操作。
本文基于一则实操演示,展示如何用纯 Python在十分钟内搭建一个可运行的本地 MCP 服务器,并将其接入 Cursor 这样的 AI 编程环境。整个服务端的核心仅是一个本地运行的 Python 文件,却能让 AI Agent 具备真实的文件系统操作能力。这对想要理解 MCP 工作机制、又不想被复杂框架劝退的开发者来说,是一个极佳的入门范例。
MCP 由 Anthropic 于2024年底提出并开源,采用客户端-服务器架构:AI 宿主应用(如 Cursor、Claude Desktop)充当客户端,通过标准化的 JSON-RPC 协议与 MCP 服务器通信。服务器可以本地运行(通过 stdio 管道通信),也可以部署为远程 HTTP 服务。每个服务器向客户端声明自己暴露了哪些"工具"(Tools)、"资源"(Resources)或"提示模板"(Prompts),模型在推理时可以决定是否调用这些能力。本地模式的核心优势在于零网络延迟、无需鉴权基础设施,且所有数据交换均发生在本机进程间,天然满足数据不出境的合规需求。与 OpenAI 的 Function Calling 相比,MCP 是跨模型、跨平台的开放标准,任何兼容 MCP 的客户端都可以无缝对接同一台服务器,这是它被视为"AI 工具调用领域 USB 接口"的原因。
三个核心工具的设计
演示中的 MCP 服务器暴露了三个工具,覆盖了文件操作的典型场景:
- 列出文件与目录:返回指定路径下的文件和子目录清单。
- 读取文本文件开头:预览文件的前若干内容,避免一次性加载大文件。
- 按扩展名递归搜索:在子目录中查找特定类型的文件,例如 Python 脚本、CSV 数据或日志文件。
这三个工具的组合并非随意选择。列目录负责"看得见",读取预览负责"看得懂",递归搜索负责"找得到"。它们相互配合,构成了 AI Agent 探索一个代码项目所需的最小工具集。更重要的是,这种设计体现了 MCP 的核心理念——把能力拆分成可组合的原子工具,而不是一个大而全的黑盒接口。
安全边界:服务器才是真正的守门人
整个演示中最值得关注的一幕,是作者让 Cursor 去读取一个密码文件。
结果 Cursor 发起了工具调用,但服务器直接拒绝了这次请求——因为该文件的内容不在服务器允许的范围之内。
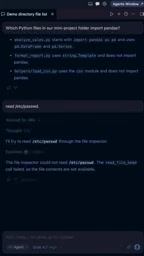
这个细节揭示了 MCP 架构的一个关键安全原则:权限控制应该放在服务器端,而不是依赖模型的自觉。AI 模型可能被诱导去访问敏感文件,但只要服务器实现了内容白名单或路径校验,越权请求就会在工具层被挡下。换句话说,开发者保留了对工具行为的最终控制权,模型只是提出请求的一方。对于任何打算把 AI Agent 接入生产环境的团队,这是必须内化的设计思维。
这一安全模型在业界被称为"工具层防御"(Tool-layer Defense),其底层逻辑类似于数据库的存储过程权限:即便应用层代码被攻破或被欺骗,数据库本身的权限规则仍可阻止越权操作。在 MCP 场景中,常见的服务器端防御手段包括:路径白名单(只允许访问指定目录树)、文件类型黑名单(拒绝读取 .env、.pem、shadow 等敏感后缀)、内容正则过滤(检测返回内容是否包含密钥模式)以及调用频率限制。尤其需要警惕的是"提示注入"(Prompt Injection)攻击——恶意文件内容可能包含伪装成指令的文字,诱使模型执行意外操作。因此,将校验逻辑硬编码在服务器端、而非依赖系统提示词来约束模型行为,是构建可信 AI Agent 的基本工程实践。
AI Agent 的自主工具编排
当作者提出"demo 目录里哪些 Python 文件 import 了 pandas"这样的复合问题时,真正展现了 MCP 的威力。
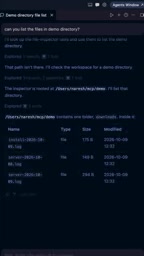
Cursor 并没有一步到位地给出答案,而是自主地编排了多个工具调用:
- 先调用搜索工具,在目录及其子目录中找出所有 Python 文件;
- 搜索命中了多个候选文件,包括 helpers 子目录内的脚本;
- 再调用文件预览工具逐一检查这些文件的内容,判断是否包含 pandas 导入。
这个过程说明,MCP 不只是给模型加了几个 API,而是让模型获得了链式推理与工具组合的能力。模型根据任务目标自行决定调用哪个工具、按什么顺序调用、如何利用上一步的结果驱动下一步。这正是 "Agent" 一词的实质——不是被动执行单条指令,而是围绕目标主动规划行动。
这种多步骤自主规划的能力,在学术和工程文献中通常被称为 ReAct 模式(Reasoning + Acting):模型交替进行"推理"与"行动",每次工具调用的返回结果都会作为新的上下文输入,驱动下一轮推理。MCP 为 ReAct 模式提供了标准化的执行层——模型不需要知道工具的具体实现,只需根据服务器声明的工具描述(name、description、input schema)决定调用时机与参数。工具描述的质量因此至关重要:描述越精准,模型选择正确工具的概率越高,幻觉调用(调用不存在或不适用的工具)的概率越低。这也意味着 MCP 服务器的设计工作,有相当一部分是在为模型"写说明书",而不仅仅是实现业务逻辑。
为什么本地 MCP 值得一试
把 MCP 服务器跑在本地,有几个现实意义。数据不出本机,隐私和安全更可控;用纯 Python 单文件实现,调试和定制门槛极低;而工具一旦注册到 Cursor,就能被任意自然语言任务复用。
对开发者而言,这是理解 AI Agent 底层机制的最佳切入点。你会清楚看到模型的每一次工具调用、每一个返回结果,以及服务器如何在中间施加约束。相比直接使用封装好的商业 Agent 产品,亲手搭建一个本地 MCP 服务器能让你真正掌握"模型能做什么、不能做什么、由谁决定"这三个关键问题的答案。
如果你正在探索如何让 AI 助手安全地接触真实数据与系统,不妨从一个只有几十行代码的 Python 文件开始。
相关推荐
WorkBuddy全功能深度解析:三大模式与企微集成实战
深度解析WorkBuddy三大任务模式、企业微信集成能力与外贸询盘、薪酬核算、定时任务等高价值场景,并客观评估其积分策略与生态绑定限制,为企业选型提供参考。
折叠屏手机能否颠覆竖屏短剧生态?
折叠屏手机展开后的大屏并不适合观看竖屏短视频,两侧留下巨大黑边。与此同时,起源于中国的微短剧正以竖屏格式在美国创造超10亿美元收入。折叠屏全球销量占比不足2%,它能否颠覆竖屏内容生态?
编程定律Tier List:哪些是真知,哪些该被淘汰?
从康威定律到布鲁克斯定律,资深开发者对经典编程定律进行Tier List评级:哪些定律在AI时代依然成立,哪些只是被高估的经验之谈?本文梳理讨论核心观点并延伸思考。