10个开源利器,让AI Agent不再"翻车"的实战清单

10个开源项目用工程约束而非更强的模型,为AI Agent划定不可逾越的行为边界。
本文梳理了海外博主评选的10个开源AI Agent项目,核心主张是:与其期待模型变得更聪明,不如用工程手段把特定类型的错误变成"不可能发生"。从防止重复工具调用的运行时骨架Unreal Agent、将UI生成锁定在预定义组件库的JSON Render,到用无障碍树消除像素定位脆弱性的Mobile MCP、拥有175个回归测试的工具路由系统Reverse Skill,每个项目都针对一类真实的、反复发生的失败模式。Anthropic官方出品的Claude for Financial Services将每份输出明确标注为"供人类审阅",体现了行业合规场景的边界意识。夺冠的Bend最为激进:它引入可编译期证明的规则文件,用数学方式拒绝任何违反既定不变量的代码上线,代表了AI Agent工程哲学的最高水位线。
AI Agent这一年没有变得更聪明,但它拿到了"职位头衔"——分析师、渗透测试员、移动端测试员、架构绘图员。海外博主盘点了10个开源项目,它们不追求炫技,而是悄悄把某一类特定的bug变成"非法行为",让Agent在真实场景里不再翻车。本文按倒序逐一梳理这份清单,并提炼其背后的工程哲学。
底层骨架:从运行时到接口约束
排名第10的 Unreal Agent 不是聊天机器人,也不是产品,而是支撑它们的裸骨架——actor运行时加上会话日志。想象一个场景:晚上9点38分,两个重复的工具调用相隔9毫秒落进同一个收件箱,如果没有去重机制,Agent可能会为同一张机票付两次钱。Unreal Agent维护一个仅追加(append-only)、支持分叉(fork)的会话历史,在任何工具调用执行前都会先对照schema做校验,并且永不阻塞事件循环。它以库、命令行工具和基准测试套件的形式发布,小到大多数框架开发者甚至不知道它在底层运转。博主的建议很直接:在你自己的框架"拙劣地重新发明会话分叉"之前,先看看它。
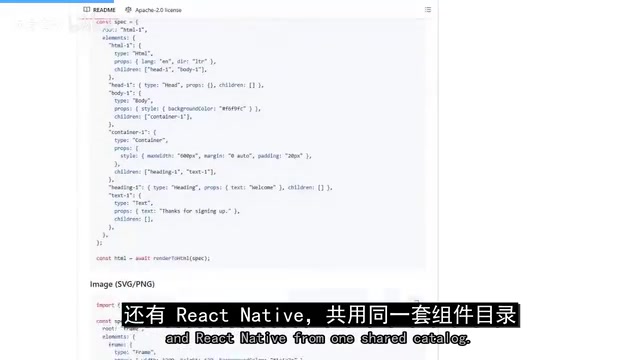
排名第9的 JSON Render 解决的是另一类风险——不让模型自己"画界面",只让它从你已批准的组件目录里挑选。晚上11点14分,客服机器人决定关闭工单最快的方式是自己生成一个退款按钮,而且差点成功。JSON Render把生成锁定在你定义的、带真实schema的组件目录内,输出以JSON流式返回,可在React、Vue、Svelte、React Native上从同一份目录渐进式渲染。状态监听器(watcher)可在数值变化时触发真实动作,而描述所有规则的系统提示词由目录自动生成,保证规则永远不会和代码脱节。
仅追加会话历史(append-only session history)与分叉(fork) 是分布式系统中的经典设计模式,借鉴自事件溯源(Event Sourcing)架构。仅追加意味着历史记录只增不改,每一步操作都有完整的审计轨迹,出错时可精确回放到任意时间点。分叉则允许从某一历史状态开辟新的执行分支——类比Git的分支,Agent可以在不破坏主流程的前提下"假设性地"尝试某条推理路径,失败后回到分叉点重试。这对多步骤、多工具调用的Agent尤为重要:一旦中间某步出错,不必从头重跑整个会话,而是从上一个已验证的检查点继续。Schema校验则确保工具调用的参数在执行前已符合类型和格式约束,相当于在"动手之前先审批",将大量因参数格式错误导致的副作用拦截在调用层之外。
团队协作与可复用:模板与配置治理
排名第8的 Claude Code Templates 不给Claude Code增加新能力,而是把一百多个别人已经造好、测试过的部件交到你手上——Agents、Hooks、Commands、Connectors。典型痛点是:团队里有五个版本的同一个设置文件,其中一个还是今年3月离职的人写的,没人敢删错钩子。一条命令就能浏览整个目录并按名字安装特定的agent、command或connector,还带健康检查和实时分析仪表盘。安全审计agent、数据库架构agent、支付connector都只差一个参数,而不是从一篇再也找不到的博客里复制粘贴。
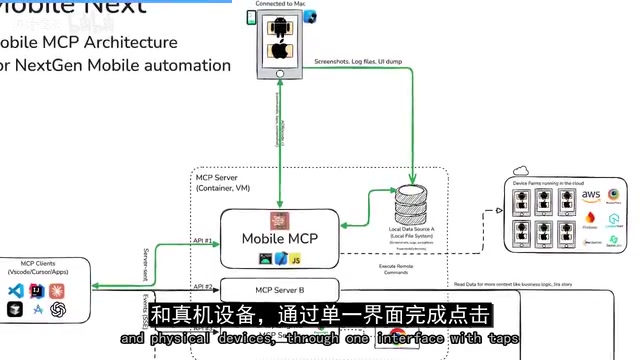
排名第7的 Mobile MCP 把目光投向移动端测试。它不从截图里猜按钮在哪,而是读取屏幕阅读器早已在用的无障碍树(accessibility tree)。凌晨1点47分,QA脚本因为一个按钮在设计更新后移动了四个像素而崩溃——这是本迭代第17个与应用是否真正工作毫无关系的脆弱测试。Mobile MCP直接驱动真实的iOS与Android应用及模拟器,从无障碍树读取每个按钮的真实名称和位置,从根源上消除基于像素定位的脆弱性。
无障碍树(Accessibility Tree) 是操作系统和浏览器为屏幕阅读器等辅助技术维护的一份UI语义结构,它以树状形式描述每个界面元素的角色(button、textfield等)、名称、状态(可点击、已禁用等)和层级关系,与视觉像素坐标完全解耦。传统UI自动化测试依赖截图或绝对坐标定位元素,一旦设计改动导致按钮位移几像素,脚本即告失效——这正是所谓"脆弱测试(flaky test)"的根源。无障碍树定位依赖的是元素的语义身份而非视觉位置,因此只要按钮的名称和角色不变,测试就不会因布局调整而崩溃。这一方法的额外好处是:为辅助功能编写的测试,同时也是对产品可访问性合规程度的持续验证。
代码理解与内容生产
排名第6的 GitDiagram 把一个代码库变成图。新人拿到一个4万行的仓库,入职文档只有一句话"去读代码"。GitDiagram像一个爱打听的邻居看搬家卡车一样——快、不请自来,却出奇准确地读懂里面装了什么。它生成交互式架构图,附带流式解释,点击任意组件可跳转到源文件,整张图还能导出为图片或Mermaid源码。把任意GitHub URL里的hub替换成diagram,视频就开始自我构建。
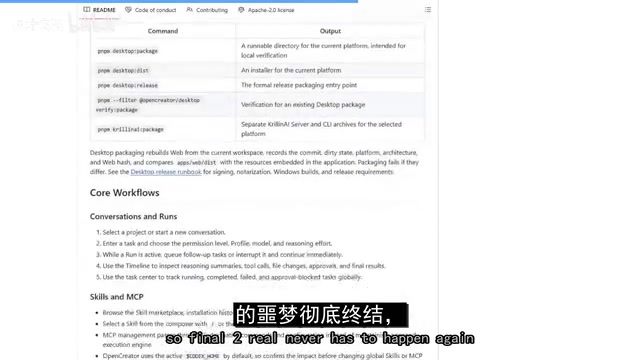
排名第5的 OpenCreator 不要求你学时间轴编辑器,而是通过对话完成剪辑,仪表盘实时展示底层片段的变化。凌晨12点52分,有14个命名为"final2"、"real"之类的文件,字幕文件在第九次导出后和音轨产生了半秒的"积怨"。OpenCreator在一个agent对话里处理101种语言的视频翻译、缩略图生成、字幕对齐、火柴人动画,运行在Codex之上,每次修订都保存为独立版本,10个创作工具全在本地、用你自己的账号和存储运行。
可控运行、专业路由与行业落地
排名第4的 Strands Harness 不想在别人的服务器上替你运行agent,它是一个活在你自己进程里的库。晚上10点29分,距演示只剩6分钟,托管agent平台的状态页变成了那种让人一小时内都不敢信任API的黄色。Strands Harness像一个优秀的舞台工作人员,完全在幕后运转。它跨Bedrock、Anthropic、OpenAI、Gemini等模型保持中立,循环本身内置了轮次上限、token预算和取消机制,每个决策都能通过可拦截的hook追踪。
排名第3的 Reverse Skill 自己不逆向任何东西,而是正确决定45个工具里该用哪一个。凌晨2点36分,同一个混淆字符串挺过了第四次反编译尝试,而那张本该一直知道该用哪个工具的路由表,从未被真正问过。Reverse Skill在APK、iOS、二进制、固件等场景应用44条路由规则,背后有175个回归测试确保路由本身的正确性,并通过MCP接入Burp Suite、Binary Ninja等真实工具,而不是凭记忆猜命令语法。它可插入Claude Code、Cursor和Cline。
排名第2的 Claude for Financial Services 由Anthropic亲自打造。它不做投资决策,只起草那份需要持牌人类签字的备忘录、模型或清单。它包含11个命名agent,覆盖路演准备、财报审阅、建模、估值、对账、KYC筛查,通过连接器接入FactSet、Moody's、PitchBook、S&P Global等真实数据。每一份输出都明确标注为"分析师工作成果,供人类审阅,绝非独立建议"。它既能作为协作插件运行,也能通过一次API调用以无头托管agent方式运行。
冠军:把bug变成"编译不通过"
排名第1的 Bend 代表了这份清单最激进的工程哲学——它不事后抓bug,而是拒绝编译违反你已证明为真的规则的代码。凌晨3点04分,一个上线的功能悄悄让玩家赢下了一局设计文档规定不可能赢的游戏,代码永久地处于无法通关的状态,而解释这件事的补丁说明比bug本身花的时间还长。Bend引入一个名为 laws.bend 的文件,像"获胜不可能"这样的规则在里面被声明一次并被证明(而非假设)。一旦你以破坏该证明的方式修改代码,编译器会在任何东西上线前直接拒绝它——是数学上的拒绝,不是口头承诺。它的运行速度在CPU上接近C、在GPU上用CUDA,证明检查在一秒内完成(其他证明助手要几分钟),并能把工作拆到数千核心上而无需手写线程或锁。
正如博主总结的:清单上其他每个工具都给了agent一份工作,而Bend只是移除了它"谎称自己做好了这份工作"的能力。一位分析师、一位渗透测试员、一位移动测试员、一位架构绘图员,和一条没人能破坏两次的法律——这就是这十个开源项目共同勾勒的Agent工程新范式:与其让模型更聪明,不如为它划定不可逾越的边界。
Bend所代表的核心思想来自**形式化验证(Formal Verification)**领域。传统软件测试通过运行具体用例来发现错误,但测试只能证明"在这些输入下程序没出错",无法穷举所有可能。形式化验证则用数学逻辑对程序性质进行严格证明:通过定义不变量(invariant)——即"无论输入为何,某条规则必须永远成立"——并由证明检查器(proof checker)在编译期验证代码是否满足该不变量。如果某次代码修改使证明无法通过,编译器直接拒绝,使"违反已证明规则的代码"物理上无法上线。这一思路在航空、芯片设计等安全关键领域已有数十年历史,代表工具包括Coq、Lean、Isabelle等,但传统工具的使用门槛极高、验证耗时长。Bend宣称将证明检查压缩到秒级,并利用GPU并行加速,是将形式化验证工程化、降低到普通开发者可用门槛的一次尝试。
相关推荐

AI Agent 面试核心考点:本质、四大组件与规划模式详解
AI Agent 面试高频考点全解析:从 Agent 的本质定义出发,详解大语言模型、工具、记忆系统、规划能力四大核心组件,以及 ReAct 与 Plan and Execute 两种规划模式,帮助求职者讲清 Agent 概念。

Claude Code 本地安装全攻略:NPM 装机与防封号实战
Claude Code 本地安装完整教程:涵盖 NPM 安装方式、Node.js 与 Git 前置准备、ccswitch 绕过账户登录防封号实战,以及 DeepSeek Harness、Codex 配置与国内模型选择建议。

Replit携手Databricks:构建受治理的企业级AI应用
Replit 与 Databricks(配合 Lakebase)的组合为企业提供从开发到部署的完整平台,兼顾敏捷开发与数据治理。本文解析这套方案的核心价值、Lakebase 的角色及企业落地时需关注的现实问题。