10美元AI编程套餐怎么选?Go与Code额度对比拆解
同价AI编程套餐的选购关键不在总额度,而在你常用模型的具体额度分配。
市面上同为10美元/月的OpenCode Go套餐与CommonCode Code套餐,表面上Code总额度(70美元)高于Go(60美元),但这一数字具有误导性。两款套餐对不同模型的额度分配差异显著:Mimo V2.5和千问3.7 Plus在Go套餐的额度是Code的两倍,而DeepSeek V4 Flash和Kimi K3则在Code套餐额度更高,Mini Max M3目前Code还提供限时免费活动。此外,两套餐对同一模型估算的请求次数不同,这源于计价口径(如输入缓存折扣)的差异,而非实际可用量的真实差距。正确的选购逻辑是:先明确自己高频调用的模型,再针对该模型对比两边的具体额度,而非被总额度数字左右决策。
同样10美元,为何总额度低的套餐反而更划算?
DeepSeek涨价之后,不少开发者开始重新审视手上的AI编程套餐。市面上两个热门选择——OpenCode的Go套餐和CommonCode的Code套餐,价格都是每月10美元。表面看,Code的最高用量额度是70美元,Go只有60美元,直觉告诉你Code更划算。
但实际情况没这么简单。这两个套餐标注的最高额度只适用于部分模型,并不是直接把这笔钱送到你账户里。同一套餐内,不同模型的可用额度也存在差异。真正决定你该买哪个的,不是套餐封面写着多少钱,而是你每天高频使用的那个具体模型,在两边分别能拿到多少额度。
换句话说,选套餐的逻辑要从「谁的总额度高」转向「我常用的模型在哪边额度更高」。这是整个对比的核心前提。
Go占优的模型:Mimo与千问系列
先看Go套餐额度更高的部分。以Mimo V2.5为例,它在Go里的可用额度是60美元,而在Code里只有30美元,整整差了一倍。千问3.7 Plus的情况类似,Go给到60美元,Code只有33美元。
这两个模型几乎撑起了Go套餐一半的用量优势。如果你的日常工作流高度依赖Mimo或千问系列,那么即便Go的总额度看起来低一些,实际能榨出的价值反而更高。
这也解释了开头的疑问:所谓「总额度」是一个笼统数字,真正影响体验的是模型级别的额度分配。选错方向,多花的钱可能根本用不到你需要的模型上。
Code占优的模型:DeepSeek与Kimi系列
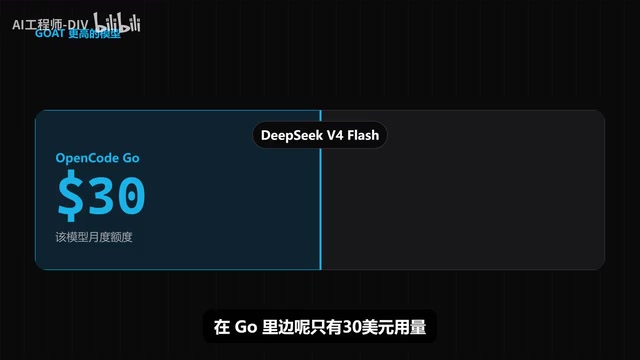
反过来看Code更有优势的场景。如果你平时用的是DeepSeek V4 Flash(视频中提到的D6V Drive/Dsic V4 Flash),Go里只有30美元用量,Code里则有60美元。Kimi K3模型上,Go是15美元用量,Code是20美元,Code同样略胜一筹。
对这两类用户来说,Code是更划算的选择。此外还有一个限时福利值得关注:如果你用的是Mini Max M3模型,目前购买Code可享受限时免费活动,优惠持续到下月5日。对高频调用M3的用户而言,这段时间等于零成本试用。
请求次数差异:口径不同,别被数字误导
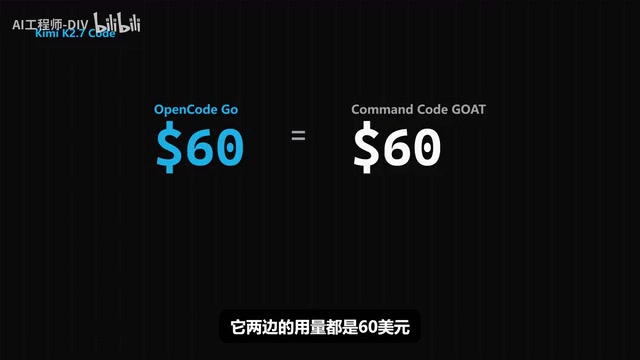
有一个容易踩坑的细节。两个套餐都包含Kimi K2.7 Code模型,两边标注的用量都是60美元。但估算的请求次数不一样:Go这边约6750次/月,Code这边约5420次/月。
乍看Go多出约25%的请求,似乎更超值。但这里要冷静判断——如果两家的输入缓存、输入Token计价口径不同,那这个数字差异只能说明统计方式不一致,并不能证明Go的实际可用量真的多出25%。用美元额度去反推固定请求数,本身就存在误差,这是选套餐时最需要警惕的陷阱。
所谓「输入缓存(Prompt Cache)」,是指当你多次调用同一个模型时,如果请求的前缀部分(如系统提示词、上下文)与上次相同,服务商会缓存已处理过的Token,后续调用只对新增部分计费,缓存命中的Token价格通常只有正常价的10%-50%。这意味着同样60美元额度,缓存策略激进的平台理论上能支撑更多实际请求——但如果两家平台缓存折扣比例不同,用"请求次数"来比较就会产生严重偏差。选套餐时,额度相同的情况下,平台的缓存定价政策比请求数估算更值得关注。
基线额度与项目窗口:集中开发选哪个
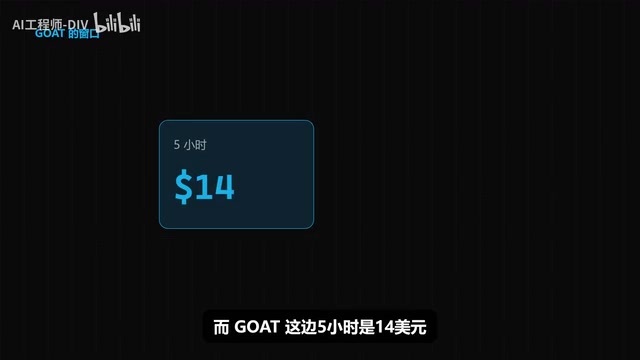
除了模型额度,还要看两个套餐的基线用量分布。Go的基线是5小时12美元、每周30美元、每月最高60美元;Code的基线是5小时14美元、每周35美元。
如果你习惯集中时间攻一个项目,短时间内高强度调用,Code的时间窗口设计会更宽松一些。但同样要提醒:美元额度不能直接换算成固定请求数,实际能跑多少还取决于你调用模型的计价方式。
「基线额度」和「时间窗口」是订阅制AI编程套餐的两个独立维度。基线额度决定了在最短计费周期(如5小时窗口)内你能消耗多少,适合短冲刺型开发;月度上限则约束了长周期总用量。Code套餐5小时窗口为14美元、Go为12美元,差距不大,但如果你经常在一个晚上密集调用完成某个功能模块,5小时窗口的宽松程度会直接影响你是否被限速或提前耗尽短期额度。长期低强度使用者受此影响较小,可以主要关注月度总额度和模型分配。
选购结论:按常用模型对号入座
把整套逻辑归纳成一句话——只看官方额度的话,一切取决于你平时最常用的那个模型:
- 常用Mini Max M3、Mimo、千问系列:优先选Go套餐,这几个模型Go给的额度更高(注:M3当前Code有限时免费,短期可薅羊毛)。
- 常用DeepSeek V4 Flash、Kimi K3:优先选Code套餐,额度翻倍或略高。
如果你的主力模型不在上述列表里,最稳妥的办法是直接去两家官网,把你的目标模型逐一对比额度,再决定这10美元花在哪边。套餐没有绝对的优劣,只有匹配不匹配你的工作流。
相关推荐
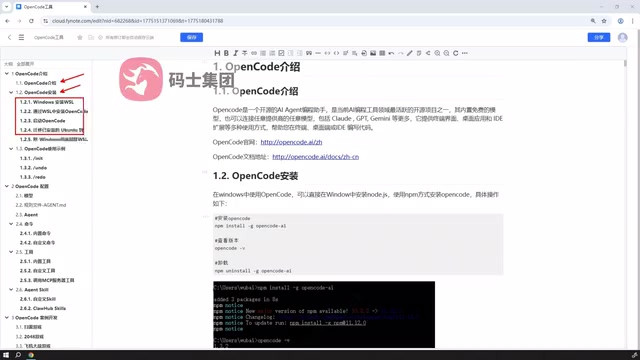
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
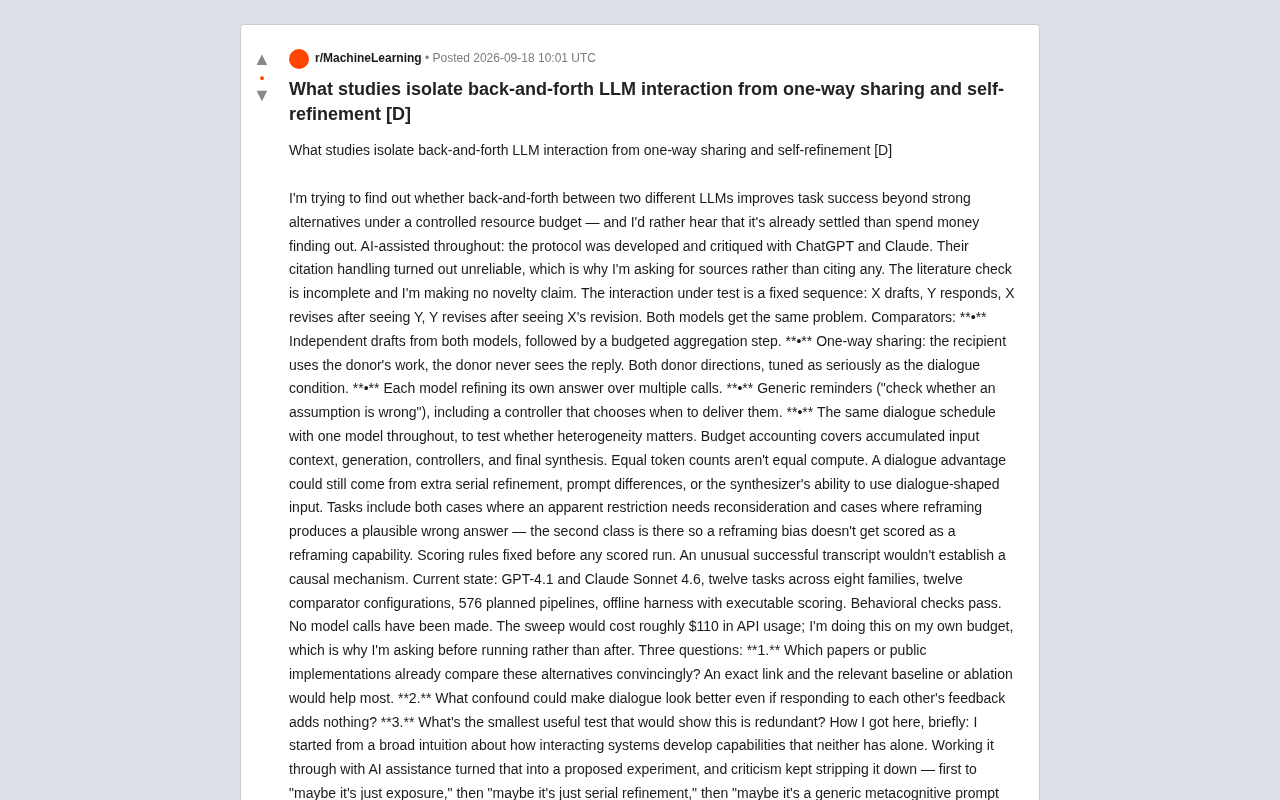
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。
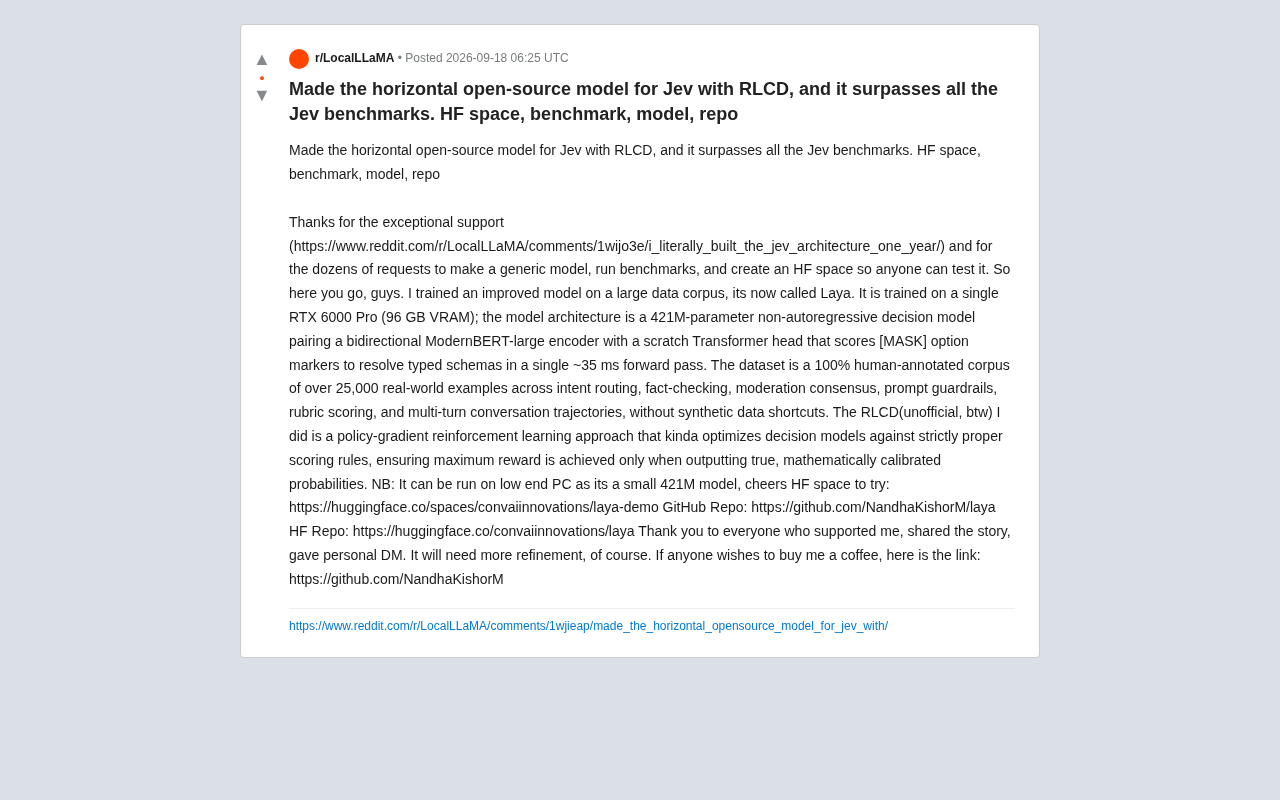
Laya开源决策模型:421M参数如何超越Jev基准测试
开源决策模型Laya基于Jev架构和RLCD强化学习训练,421M参数非自回归设计,可在低端PC运行,35毫秒完成推理,在多项Jev基准测试中实现超越,采用25000条纯人工标注数据。