10年109k篇ML论文压缩成千个主题页:基准纪录、消融与审稿期待一页看懂

团队将五大顶会十年约10.9万篇论文聚合为1260个主题页,展示基准纪录、消融与基线分布。
一个团队从ICML、NeurIPS、ICLR、CVPR、AAAI自2016年以来的约10.9万篇接收论文中提取数据,聚合成约1260个主题的单页视图,并从7.9万篇全文中抽取结果表格与消融数据。每个主题页展示各benchmark最好成绩的时间线及对应论文、近期论文的消融实验(含失败尝试)、常用对比基线分布,以及最新arXiv预印本和BibTeX,所有数字均可链接回原文。团队明确说明数据提取不完美、跨论文数字不总是可比,定位为研究起点而非排行榜,且2026年论文数据尚未纳入。工具免费无需注册,旨在改变文献调研的起点。
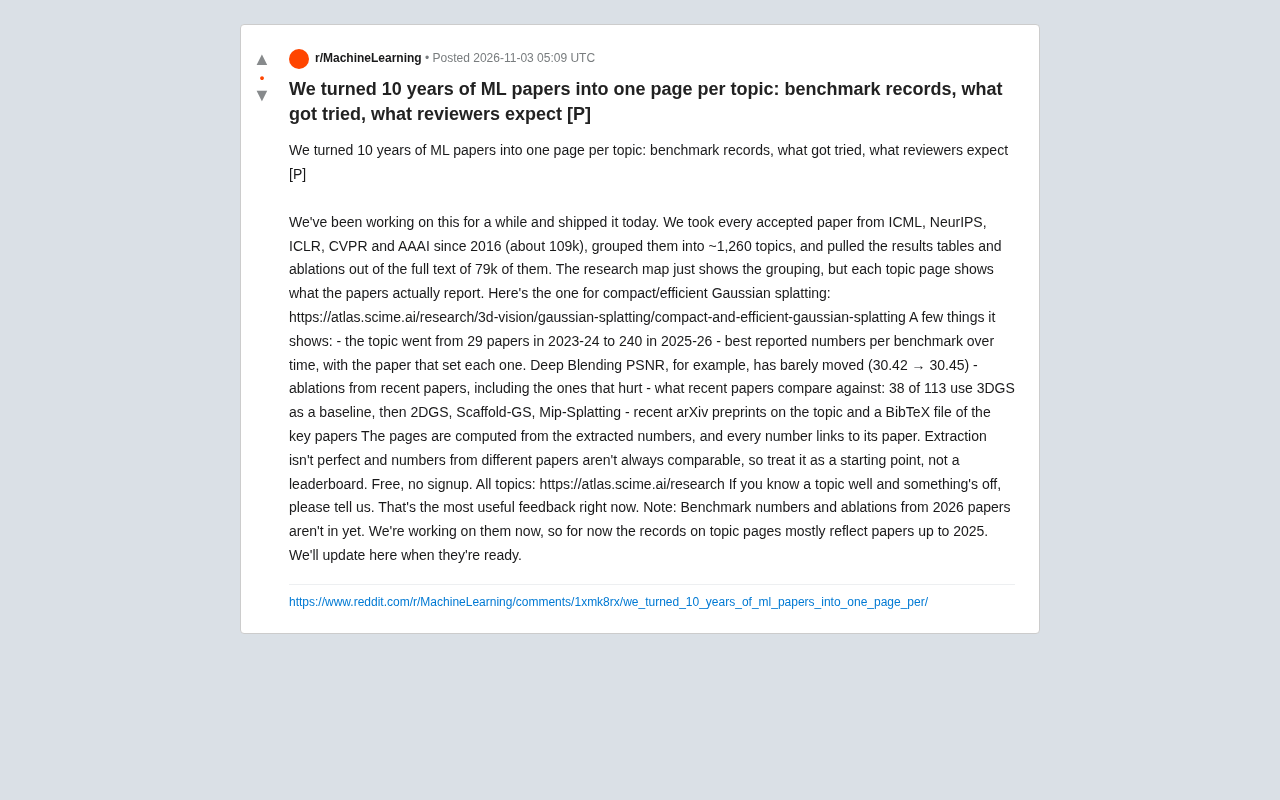
做机器学习研究的人大概都有过这样的体验:想进入一个细分方向,先得在几百篇论文里手动翻结果表格,搞清楚哪个benchmark已经被刷到什么水平、哪些方法被试过又失败、审稿人到底在意什么。一个团队把这件事自动化了——他们从ICML、NeurIPS、ICLR、CVPR、AAAI自2016年以来的全部接收论文中提取数据,按主题聚合成单页视图,最近正式上线。
数据规模:109k篇论文如何变成1260个主题
据该项目在Reddit上的发布帖,团队收集了五大顶会自2016年起的约109,000篇接收论文,将其归入约1,260个主题;并从其中79,000篇论文的全文里抽取了结果表格和消融实验数据。
这个规模值得注意的地方在于覆盖率:不是抽样,而是全部接收论文;不是只抓摘要,而是深入全文解析表格。结果是一个可检索的研究地图,让研究者不必逐篇阅读就能看到某个子领域的演进轨迹。
帖子里给出的示例主题是紧凑/高效高斯泼溅(compact and efficient Gaussian splatting),页面展示了该方向从2023-24年的29篇论文增长到2025-26年的240篇,热度变化一目了然。
顶会(ICML/NeurIPS/ICLR/CVPR/AAAI) 是机器学习与计算机视觉领域公认的旗舰会议,其接收论文通常代表了该领域当年最受关注的研究方向。ICML、NeurIPS、ICLR 偏重机器学习理论与方法,CVPR 偏重视觉,AAAI 则覆盖更广的人工智能议题。把这些会议的接收论文作为语料,意味着覆盖了主流研究社区的核心产出,但也会遗漏期刊论文以及部分细分领域专属会议(如 ACL、EMNLP 之于 NLP)的工作,这是理解该工具覆盖边界时需要注意的一点。
arXiv 预印本 是论文正式发表前的公开版本平台,机器学习领域的绝大多数工作都会先上传 arXiv。它的优势是时效性强,能反映最新进展;代价是未经同行评审,质量参差不齐,且版本会不断更新。主题页把最新 arXiv 预印本与已发表论文并列展示,实际上是在“权威性”和“新鲜度”之间做了一种折中。
主题页里究竟有什么
每个主题页由提取出的数值计算生成,且每个数字都链接回原论文。以高斯泼溅页面为例,可以看到几类信息:
- 基准纪录的时间线:各benchmark上报告过的最好数字,以及是哪篇论文创造的。帖子特别提到Deep Blending PSNR几乎没有变化(30.42 → 30.45),这种"停滞"本身就是有价值的信号。
- 近期论文的消融实验:包括那些让效果变差的尝试。负面结果往往最难在文献中找到,却被系统性地汇总了出来。
- 对比基线分布:近期论文在跟谁比。示例中113篇里有38篇把3DGS作为基线,其次是2DGS、Scaffold-GS、Mip-Splatting。这实际上勾勒出了该领域的"默认参照系"。
- 最新arXiv预印本与关键论文的BibTeX文件,方便直接进入写作流程。
访问免费、无需注册,全部主题入口在atlas.scime.ai/research。
消融实验(ablation study) 是机器学习论文中用来验证“某个组件是否真的有用”的实验:在保持其他条件不变的前提下,逐个去掉或替换模型中的模块,观察性能变化。正向消融说明某设计带来了提升,而负向消融——即加上某模块后效果反而变差——同样有信息量,它能告诉后来者哪些路线已经被试过且不奏效,避免重复踩坑。这类负面结果因为缺乏“亮点”,很少被单独写成论文,通常只散落在正文表格里,因此系统性地把它们汇总出来是该工具比较有价值的部分。
基线(baseline) 指论文中用于对比的参照方法。一个领域在成熟过程中往往会收敛出若干“默认基线”,新论文若不与这些方法比较,审稿人通常会质疑其说服力。统计近期论文的基线分布,等于间接描绘出该领域的共识参照系,也能帮助判断哪些方法已经成为“必比项”。
定位明确:是起点,不是排行榜
团队对局限性的说明相当坦诚,这一点反而增加了工具的可信度。他们明确指出:数据提取并不完美,不同论文的数字并不总是可比,因此应当把这当作研究起点而非leaderboard。
这个提醒很关键。机器学习论文中的实验设置差异巨大——数据集划分、预处理、评测协议都会影响数字,跨论文直接比较本身就存在风险。工具的价值不在于给出权威排名,而在于让你快速知道"这个方向大致被推到哪了""哪些路线已经有人走过"。
另一个时效性缺口:2026年论文的基准数字和消融实验尚未纳入,目前主题页上的纪录主要反映截至2025年的论文,团队表示正在处理并会更新。
排行榜(leaderboard) 通常指在固定数据集、固定划分、固定评测脚本下对方法进行统一排名的榜单,例如 Papers with Code 上的各类 benchmark 排行。排行榜的数字之所以可比,是因为评测条件被严格统一;而跨论文从正文表格中抽取的数字,往往来自各自不同的实验设置,二者性质完全不同。这也解释了为什么该团队反复强调“研究起点而非 leaderboard”——一旦读者把抽取出的数字当作权威排名,就可能得出错误结论。
PSNR(峰值信噪比) 是图像与三维重建领域常用的质量指标,数值越高表示重建结果与真实图像越接近,单位是分贝(dB)。在 Deep Blending 这类数据集上,PSNR 提升 0.03 dB 在感知上几乎不可分辨,因此“30.42 → 30.45”这种微小变化通常意味着该 benchmark 已接近饱和,方法改进的空间有限,研究者或许应转向新的评测场景。
对研究者意味着什么
这类工具改变的可能是文献调研的起点。传统流程是"读综述→追引用→翻表格",现在多了一个入口:先看主题页掌握全局,再有选择地精读。对于跨方向进入的研究者、需要快速判断选题是否已被做透的学生,以及对审稿人预期好奇的作者,这种聚合视图能省下可观的筛选时间。
当然,自动化抽取的准确性需要领域专家校验。团队在帖中直接请求反馈:"如果你熟悉某个主题且发现有问题,请告诉我们"——这大概是目前对他们最有用的输入。
从更宏观的角度看,把十年顶会论文结构化,本身也是对研究生态的一次量化观察:哪些benchmark陷入停滞、哪些基线成为共识、哪些尝试被反复证明无效。这些信息过去散落在无数篇论文的正文里,现在被摆到了同一页上。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。