12GB显存跑180B大模型?Strata引擎本地部署深度解析

Strata用四层存储调度让12GB显卡跑180B级模型,128k上下文实测44.8 token/s,但数据未经独立验证。
Strata是一款专为Qwen 3系列大模型设计的推理引擎,核心创新在于将180B参数模型拆分到显存、系统内存和SSD三层存储中协同运行,使配备12GB显存RTX 5070的普通桌面电脑能以128k上下文跑出44.8 token/s。其底层依赖MoE稀疏激活(每token仅调用约6B参数)、CPU-GPU协同计算(绕过PCIe带宽瓶颈)以及投机解码加速三项技术。然而,这份性能数字存在明显的可信度隐患:所有速度数据均为开发者自测,"快3倍"的基线依据在文档中无从查证,非RTX 5070显卡的数字甚至只是估算。此外仓库尚无许可证,代码可读但不可复用。Strata的架构设计逻辑自洽,值得技术研究,但在独立验证完成前,所有性能声明都应保留判断。
一台配备12GB显存RTX 5070、64GB内存的普通桌面电脑,要跑一个主文件就有37.6到47GB、外加28.8GB独立查找表的大模型——听起来像天方夜谭。但Strata这款GitHub上新出现的推理引擎,却声称能在这套配置上以128k上下文跑出每秒44.8 token的速度。这个数字到底是真是假?它背后的架构设计是否站得住脚?
Strata是一位开发者为运行Qwen 3系列大模型而发布的推理引擎。Reddit上一篇讨论它的帖子甚至打出了"快3倍"的旗号。本文基于B站UP主对该项目的拆解分析,带你看清它聪明的设计思路,也指出其中最经不起推敲的部分。
模型到底多大:125B还是180B?
关于这个模型的参数量,网上说法不一,有人说125B,Hugging Face页面却标着约180B。两个数字其实都对,只是回答的是不同问题。
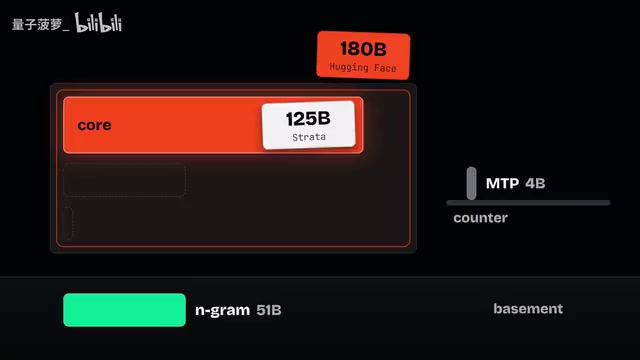
模型卡的规格列表写得很清楚:核心模型125亿参数(125B),外加一个510亿参数的n-gram查找表,再加40亿参数的draft层(称为MTP,多token预测)。加起来正好是180B。
换句话说,125B是真正"做思考"的部分,180B是把所有组件都算进去的总和。读到相关帖子时要留意它到底在数哪个数字,因为这些附加组件最终会被安置在系统中完全不同的"房间"里。
混合专家架构:为什么小厨房撑得住
这个模型内部是一个混合专家(MoE)结构。它的48层,每层有512个小型专家网络,相乘下来就是24,576个专家——这正是Strata所处理的数量。
小厨房能撑住的关键在于稀疏激活:每处理一个token,每层的路由器只挑选512个专家中的10个,外加一个贯穿全部48层始终运行的共享专家。这样算下来,每个token只调用480个路由专家。换成参数量看,就是从125B中只激活约6B。
两万多道菜,任何一张订单只触及其中约2%。你永远不需要一次性把整个菜单摆出来,只需要快速拿出正确的那2%。
混合专家(Mixture of Experts,MoE)架构的核心思想是将一个大型神经网络拆分为多个较小的"专家"子网络,每次推理时只激活其中一小部分。这与传统的密集模型(Dense Model)形成对比——后者每处理一个token都会调用全部参数。MoE的路由器(Router)本质上是一个轻量级的分类网络,它为每个token打分并选出最合适的专家组合。这种设计的好处是:模型总参数量可以扩展得很大(理论上覆盖更多知识),但实际计算量(FLOPs)却只与激活参数成比例。Qwen 3的125B中只激活约6B,意味着单次推理的计算量接近一个6B密集模型,但知识容量接近125B。代价则是显存压力:所有专家权重都必须能被访问到,因此无法像密集模型那样简单地只加载"推理所需"的那部分——Strata的多层存储调度正是为了解决这一矛盾。
四层存储:显存、内存、SSD各司其职
Strata最精巧的地方在于把模型的不同部分分配到不同层级的存储中,像一个有后厨、储藏室和地下室的厨房。
显存(厨房台面):每个token都要用到的部分全部常驻VRAM——注意力层、一种叫delta net的层、路由器、共享专家、输出头,以及记录128k对话上下文的KV缓存。这些是每次出餐都要抓的刀具和锅。
专家缓存(手边货架):Strata在显存里划出约6GB作为专家缓存,存放约4,500个专家,不到总量的五分之一。当路由器选中的专家恰好在货架上,GPU就直接在本地处理。
内存(储藏室):全部24,576个专家都固定在系统内存中。关键的设计在于——当路由器选中的专家不在显存货架上时,Strata不是把专家权重搬下PCIe 4.0那条约26GB/s的"走廊",而是让CPU这位"第二位厨师"直接在内存里现场计算。同时GPU继续处理同一个token的其他部分,两盘菜最终落在同一张订单上。
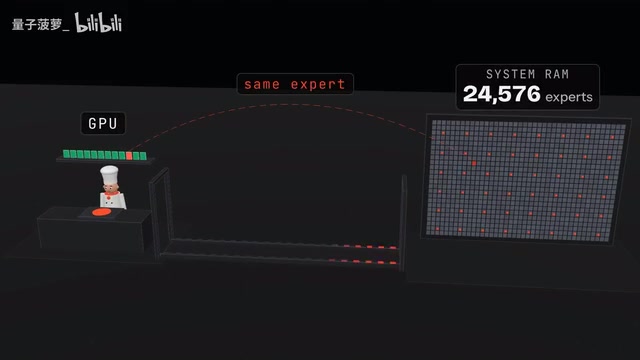
这种CPU-GPU协同计算是避免被慢速数据传输拖累的核心手段。不过第二位厨师也不是免费的——Strata采用了多种压缩量化版本,比如跑出44.8 token的IQ3_XXS把权重压到约3比特,Q2和IQ2版本更是压到约2比特。即便如此,IQ3_XXS光专家就约占43GB内存,再加约6GB,64GB内存在你打开浏览器之前就已被吃掉一大块。
PCIe(Peripheral Component Interconnect Express)是连接GPU与CPU/内存的高速总线。PCIe 4.0 x16理论带宽约为32 GB/s,实际可用带宽在双向传输时通常在26 GB/s左右。这个数字听起来不小,但对于需要每token都从内存搬运专家权重的场景而言却极为紧张:假设每个专家权重约几MB,每层选10个专家、共48层,每token的数据搬运量可能高达数GB,远超PCIe带宽所能支撑的实时吞吐。这正是Strata选择"CPU在内存中就地计算"而非"将权重搬到GPU"的根本原因——绕过PCIe瓶颈,以CPU算力换取传输带宽。这一取舍的代价是CPU负载大幅上升,且IQ3_XXS等量化版本的精度损失会影响CPU端的计算质量,用户在实际部署时需要权衡CPU性能与答案质量之间的关系。
地下室里的51B查找表
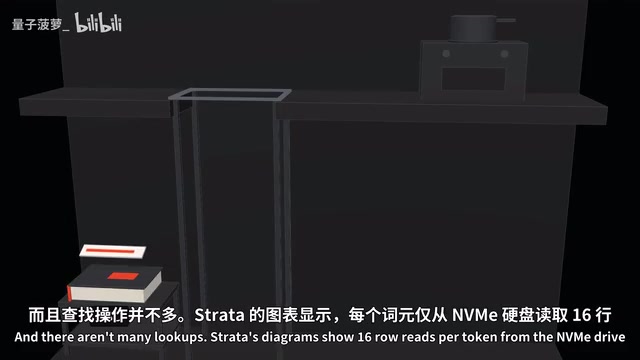
那个510亿参数的n-gram表被Strata留在了SSD上。n-gram就是连续的一小串token,这张表为它们存储了学习到的条目,相当于一本28.8GB的巨型短语手册。
它之所以能放在更慢的SSD上,是因为使用方式特殊:它是查找表,不需要跨整张表做繁重运算,只需翻到某一行、读取、合上。Strata的图示显示每个token从NVMe驱动器读取16行,而且是提前一步发起的,页面在厨房开口要之前就已在路上。
此外还有那个40亿参数的MTP层(投机解码的"副厨"),它快速预判接下来最多3个token,然后由完整模型一次性验证这些猜测,按顺序保留直到遇到不认同的那个。Strata报告平均每次验证能通过2.4到3.2个token,意味着一次昂贵的完整推理可以一次出两三盘菜。
投机解码(Speculative Decoding)是一种加速自回归语言模型推理的技术。传统推理中,每生成一个token都需要完整地跑一遍大模型,吞吐量受限于这种串行结构。投机解码引入一个轻量级的"草稿模型"(Draft Model),先快速连续猜测若干个token,再让完整模型一次性并行验证这批猜测——由于大模型的并行验证代价远低于串行生成,整体吞吐量得以提升。关键指标是"接受率"(acceptance rate):草稿模型猜得越准,每次完整推理能确认的token就越多。Strata报告的2.4到3.2的平均接受token数,意味着MTP层的草稿质量尚可。值得注意的是,投机解码对延迟(首token时间)帮助有限,主要提升的是吞吐量,在长文本连续生成场景下收益最为显著。
查账:44.8和"快3倍"到底可信吗
Strata为RTX 5070发布了一张实测速度表,这是整个仓库里最有价值的东西,因为网上流传的数字彼此并不一致。
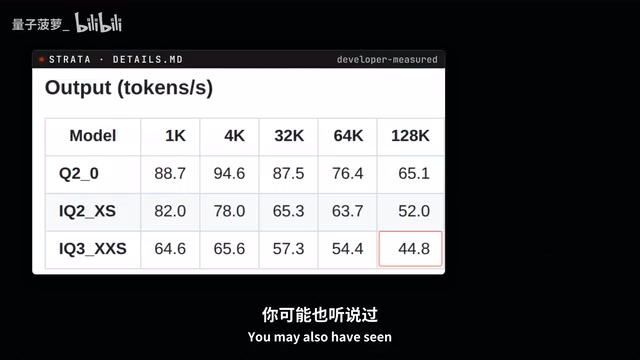
在128k上下文下,IQ3_XXS版本是44.8 token/s,上面一行2比特的IQ2_XS是52,Q2_0行同样2比特是65.1。你可能见过"约65 token/s"的说法,这张表里有两个格子对得上:128k下的Q2_0(65.1),或者4k短上下文下的IQ3_XXS(65.6)。所以65是真数字,只是回答的是另一个问题。
对于128k对话、IQ3_XXS配置,应该引用44.8。
至于"快3倍"的说法:基线被设为15 token/s,44.8除以15约等于3。但这个15在仓库文档里根本找不到,也没说明对比的是什么软件、什么配置。"比一个未知配置快3倍",告诉你的信息远比听起来少。
更重要的是,这张表里每个速度都是开发者自测的,没有一个经过独立验证。其他显卡(如5060 Ti、3090)的数字甚至不是实测,文档自称是估算,误差±20%。而且IQ3_XXS虽被标为"best",那只是指速度维度,不代表答案质量,别因为2比特版本更快就贸然切过去。
一张还没签字的许可证
在你敲下git clone之前,还有一笔账要看:Strata的仓库才发布没几天,license字段是空的。底层它构建在llama.cpp和ggml之上(这些是MIT协议),但Strata自己的代码没有许可证——你可以读它,但没有权限复用。
在开源软件中,缺少许可证(License)并非小问题。根据默认版权法,未附带许可证的代码意味着"保留所有权利"——任何人都可以查看代码,但在未获作者明确授权前,复制、修改、分发或在产品中使用均属侵权。这与MIT、Apache 2.0等宽松许可证形成鲜明对比。Strata底层依赖的llama.cpp和ggml均采用MIT协议,允许商业使用和修改,但上层的Strata代码若无许可证,整个衍生项目的法律地位就变得模糊。对于个人研究或学习,风险较低;但若用于企业内部工具、商业产品或进行二次开发和分发,就需要等待作者明确许可证条款。项目刚发布时缺少许可证属于常见的疏漏,开发者后续补充的概率较高,但在此之前应保持观望。
结论:聪明的设计,待验证的数字
如果你手握12GB显卡、64GB内存,又乐意读引擎代码,Strata值得你花一个晚上研究。它的"厨房布局"确实巧妙——四层存储各司其职、CPU与GPU协同、投机解码加速,整套逻辑自洽地解释了44.8这个数字在开发者桌面上如何成为可能。
但要把44.8当成"开发者的声明"而非定论,选IQ3_XXS时要清楚它依赖你的CPU,在有正式许可证之前别在上面构建任何东西。真正的考验属于你自己:当别人用自己的内存和自己的SSD来跑这套架构时,44.8还能活下来吗?
相关推荐

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。

花旗AI编程代理Devon:年省30%技术外包费,1.4万工程师已使用
花旗集团利用AI编程代理Devon,一年内削减30%技术供应商费用,1.4万工程师使用,产品发布提速30%-40%。本文分析其对IT外包行业的冲击及未来人机协作模式。

从生日派对到千亿AI帝国:新一代PayPal黑帮崛起
2015年一张生日派对合影,十年后催生Scale AI、Cognition AI等千亿估值AI公司。解析新一代PayPal黑帮的创业路径、互相投资生态,以及Peter Thiel的Founders Fund如何完成代际传承。