12款AI Agent横评:DeepSeek V4.1下谁最强?

12款Agent同用DeepSeek V4.1 Flash实测4道题,冠军80分仅花0.35元。
B站UP主“护身最高”将同一模型DeepSeek V4.1 Flash装入12个不同Agent壳,用4道贴近真实工作的任务进行横评,涵盖脏数据清洗、折扣bug修复、代码画图和模块配置错误修复。测试采用盲评与自动化验收,综合分中质量占40%、速度占20%、花费占40%。结果总榜冠军得分80.0分、总成本0.35元、耗时6.2分钟;同模型下不同Agent花费相差2.2倍、速度相差3.9倍。整体缓存命中率97.6%使输入成本极低,但120万输出Token才是成本关键。UP主强调这是个人体验式测评,模型决定能力上限,壳决定等多久、花多少钱。
一场“从夯到拉”的Agent实战检验
当同一个模型(DeepSeek广告 V4.1 Flash)被装进12个不同的Agent壳里,交付能力会差多少?B站UP主“护身最高”用4道贴近真实工作的任务做了一次横评,结果有些出人意料:综合冠军不是名气最大的,最贵的也不一定最好用。这场测试耗资6.77元、调用908次、消耗4520万Token,最终有Agent拿下96.5分的单项高分,也有Agent因未交付文件被直接判负。
需要先明确:这是个人体验式测评,不是产品总评。所有Agent均使用原生提示词和原生工具,每家独立API Key、独立工作目录,仅统一模型。同一Agent可能默认高思考、长上下文,这些都按其自身请求参数记录。
测试设计:4道题、盲评与自动化验收
任务来自日常交付,不是刷题
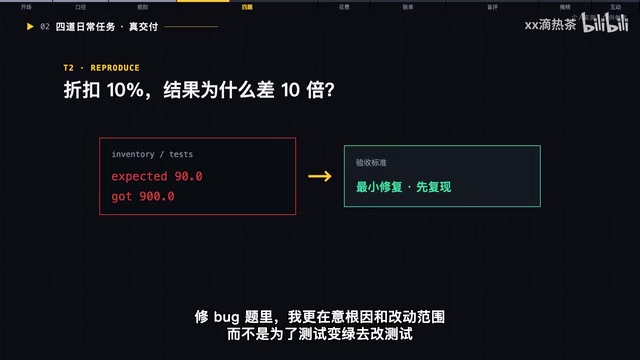
四道题分别覆盖:脏销售表清洗与简报、真实小仓库的折扣bug修复、代码画“骑自行车的提壶”、模块配置错误修复。UP主强调,每道题都要留下文件、测试结果和可复现说明,且有自动验收兜底——改测试骗过率不算过关。
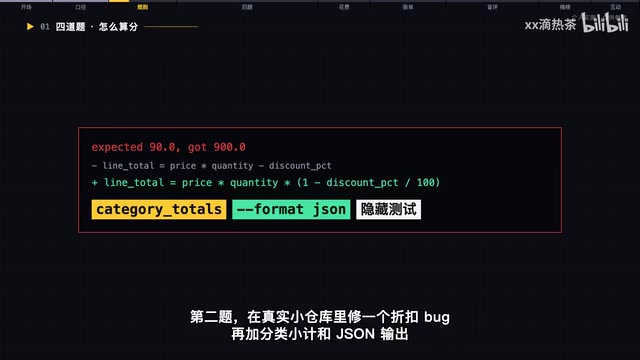
例如修bug题,隐藏测试会继续检查空列表、折扣边界和CLI参数,只让可见测试变绿远远不够。配置题中,源码是ESM却告诉Node用CommonJS解析,报错“不能在模块外使用import”,正确做法是改package.json的type字段,而不是删掉测试。
评分与成本口径
综合分中质量占40%、速度占20%、花费占40%。所有Token按闲时价统一核算,最终以DeepSeek控制台实扣为准。盲评由UP主一人完成,每题只记一条有效记录。
盲评(Blind Evaluation) 是一种在测评中隐藏被测对象身份、仅依据输出质量打分的做法。本文中,12个Agent被匿名编号为A到L(其中有一个空号),UP主在不知道编号对应哪个产品的前提下,先按1-10分评估每道题的交付质量,揭晓编号后再与成本、速度合并计算综合分。盲评的目的是避免品牌偏见或先入为主的印象影响评分,使质量分更贴近实际交付水平。由于只有UP主一人评分,且每题只记一条有效记录,这种盲评更接近个人体验式测评,而非严谨的多人交叉评审。
自动化验收(Automated Acceptance Testing) 指通过预先编写的测试脚本或检查程序自动判定任务是否合格,而非依赖人工肉眼判断。在本文的修bug题和配置题中,隐藏测试会继续检查空列表、折扣边界、CLI参数等边界条件,仅让可见测试变绿并不算过关。自动化验收的好处是标准统一、可复现,能有效防止“改测试骗过率”这类作弊行为,但也要求出题者提前设计好覆盖面足够的测试用例。
四题交付:质量分背后的细节
销售表清洗题,300单中239单完成,销售额533953元,退款率14.3%。更值得关注的是UP主指出的异常产品区域和下一步动作,而非简单复述数字。
修bug题里,折扣参数本是百分比,错误代码却当小数直接减,正确做法是先除以100。追加的分类小计和JSON输出必须兼容原有文本输出。
画图题重点看坐姿、脚是否踩踏板、车轮是否转动。配置题改对一处后,测试和启动都应恢复,最终启动输出三条记录、总计240元、最高分类为广告,一个字段都不能少。
成本与速度:同模型下壳决定钱包和耐心
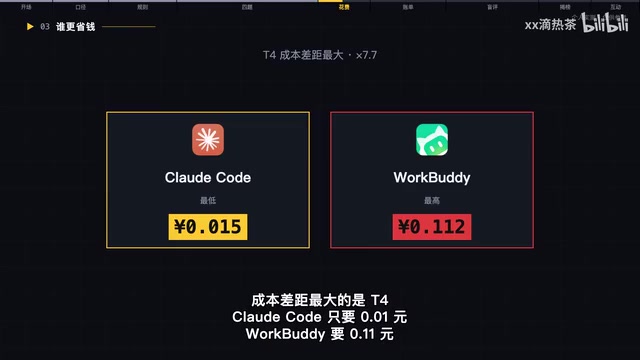
四题最低花费0.35元,最高0.78元,相差2.2倍;最短用时6.2分钟,最长24分钟,相差3.9倍。UP主特别提到,T4Cloud Code只花1分钟,Workbody花了0.11元,两者相差7.7倍——不是模型变笨了,而是壳带了多少上下文、来回发了几轮、让模型写了多少字。
一个关键省钱知识:DeepSeek输入分缓存命中与未命中,价格差很多。这一轮整体缓存命中率高达97.6%,输入几乎白送。若不计缓存,同样Token估算要从6.77元涨到50.01元;按高峰/空闲时段本地复算约9.21元。但输出共120万Token才是真正要盯的部分——有些Agent喜欢把整段上下文再发一遍,轮数一多,输入缓存再便宜也会堆起来。
Token缓存命中(Cache Hit)与未命中(Cache Miss) 是大模型API计费中的关键概念。当请求的输入前缀与之前某次请求完全一致时,服务端可以复用已缓存的计算结果,这部分输入Token按缓存命中价计费,通常远低于未命中价;只有新增或变化的输入部分才按未命中价计费。本文中整体缓存命中率高达97.6%,意味着绝大部分输入Token都以极低价格结算,输入成本几乎可以忽略。但缓存命中依赖于请求前缀的稳定复用,如果Agent每轮都把整段上下文重新组织或改写,缓存命中率就会下降,输入成本随之上升。因此,缓存命中率不仅是计费问题,也反映了Agent的上下文管理策略。
输出Token 指模型实际生成并返回的文本量,按输出价计费,通常比输入价贵数倍。本文中输出共120万Token,是真正需要盯住的部分。有些Agent倾向于把整段上下文再发一遍或生成冗长的中间步骤,轮数一多,输出Token就会快速累积。与输入不同,输出Token无法通过缓存摊薄,因此控制输出长度、减少不必要的来回轮次,是降低Agent使用成本的关键。
盲评揭晓:从“拉完了”到“夯”
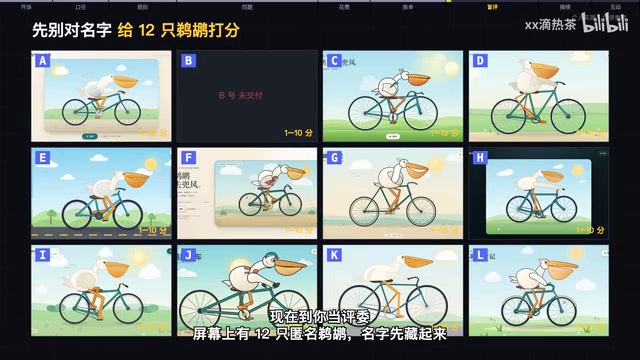
12个Agent匿名编号A到L(其中有一个空号),UP主先盲评1-10分,再揭晓编号。有一家因画图题未交付文件,按规则直接判负、速度和花费清零;Workbody四题都交了,但最慢24分钟,分数被时间和账单拖下来。
最终分档:拉完了档三家,NPC档五个平台,人上人档两家,最高分档两家。总榜冠军“失败”得分80.0分,总成本0.35元,总耗时6.2分钟。UP主又按质量优先、预算优先各算一遍,第一名都没换人。
结论:模型决定上限,壳决定体验
这场横评的核心启示是:模型决定能力上限,但壳决定等多久、花多少钱。如果你更看重质量,就把质量权重拉高;如果只看预算,就把花费权重拉高。UP主也提醒,结果只代表这一轮这4道题,换个任务或版本排名可能完全不同。
配置、题目和逐次账单都放在置顶回复,感兴趣可以复现。
Agent壳(Agent Harness/Scaffold) 指包裹在大模型之外、负责组织提示词、管理工具调用、维护上下文、控制轮次和错误重试的软件框架。同一个模型被装进不同的壳里,实际表现可能差别很大:壳决定了给模型多少上下文、允许它调用哪些工具、是否自动重试、是否压缩历史记录等。本文中12个Agent均使用DeepSeek V4.1 Flash,但花费相差2.2倍、速度相差3.9倍,根源就在于壳的上下文管理和轮次设计不同。壳不改变模型本身的能力上限,但深刻影响交付体验——等多久、花多少钱、能不能稳定交出文件。
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。