13大AI模型编程能力实测:谁才是最强编程助手?

Gemini 2.5 Pro与Claude 3.7 Sonnet在13大AI模型编程评测中并列满分第一
一项针对13大主流AI模型的编程能力横向评测显示,Google的Gemini 2.5 Pro和Anthropic的Claude 3.7 Sonnet以满分9.0并列第一,远超O1 Pro(7.2分)等竞品。评测通过高难度算法题从代码正确性、解题思路、多语言转换等8个维度综合打分,结果表明深度推理能力是编程的核心竞争力,而价格并不等于实力。
引言:AI编程能力大比拼
2025年以来,各大AI厂商密集发布了新一代模型:OpenAI推出了GPT-4.1、O3、O4系列,Anthropic带来了被誉为"编程天花板"的Claude 3.7 Sonnet,Google则发布了Gemini 2.5 Pro……面对如此多的选择,开发者最关心的问题只有一个——谁的编程能力最强?
本文基于一项针对13大主流AI模型的编程能力横向评测,通过同一道高难度算法题,从代码正确性、解题思路、算法分析等多个维度进行打分,帮你找到最适合编程的AI模型。
评测方案:一道高难度算法题的全方位考验
此次评测选择了一道约200分难度的华尔数码算法题,属于相当复杂的编程任务。在编程竞赛题目的难度体系中,200分难度属于中高难度区间,通常涉及动态规划、图论、数论或复杂数据结构等知识点的综合运用。此类题目不仅考验代码实现能力,更考验对问题本质的数学建模能力——能够有效区分模型是否真正"理解"算法逻辑,还是仅凭训练数据中的相似代码进行模式复现,后者在面对细微变体时往往会产生错误。
评测对每个模型提出了统一且严格的要求:
- 根据题目描述,用Java解答此题
- 根据输入输出描述,给出5个测试用例
- 判断代码是否正确,并给出测试用例的解释说明
- 给出代码的解析思路,说明采用了什么数学方法和算法
- 将正确的Java代码转成7大编程语言,每行代码添加中文注释

这套评测标准覆盖了从问题理解、算法设计、代码实现到多语言转换的完整编程链路,能够全面检验AI模型的综合编程能力。
值得注意的是,将同一算法从Java转换为Python、C++、C、Go、Rust、JavaScript等7种语言,并非简单的语法替换,而是需要深刻理解各语言的内存管理模型、类型系统和标准库差异。例如,Java的ArrayList在C++中对应vector,在Python中则直接使用list;Java的整数溢出处理方式与C++存在本质差异。高质量的多语言转换要求模型不仅掌握语法映射,还需理解各语言的惯用写法(idiom)和性能特性,这正是区分顶级模型与普通模型的重要维度之一。
参赛选手:13大顶级AI模型一览
本次参与评测的13大模型涵盖了当前全球最强的AI产品:
| 厂商 | 模型 | 特点 |
|---|---|---|
| OpenAI | GPT-4.5 | 适合文件处理和AI绘画 |
| OpenAI | GPT-4o | 4o的全面升级版 |
| OpenAI | GPT-4.1 | 最新API模型,百万token上下文 |
| OpenAI | O4 Mini / O4 Mini High | 最新推理模型 |
| OpenAI | O3 | 深度思考模型 |
| OpenAI | O1 Pro | 200美元/月的旗舰模型 |
| DeepSeek广告 | DeepSeek R1 | 满血版推理模型 |
| xAI | Grok 3 Thinking | 马斯克发布的最新模型 |
| Anthropic | Claude 3.7 Sonnet | Cursor主力模型,编程天花板 |
| Gemini 2.5 Pro (0325) | 专为复杂任务打造,推理能力极强 |
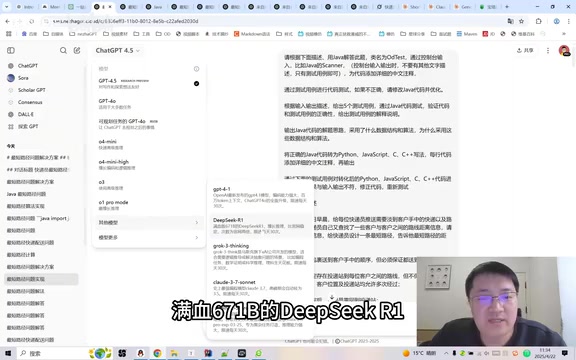
这些模型在技术路线上可分为两大阵营:标准语言模型(如GPT-4o、GPT-4.5)采用单次前向传播生成答案;推理模型(如O系列、Claude 3.7 Sonnet扩展思考模式、Gemini 2.5 Pro)则在输出前进行"链式思考"(Chain-of-Thought),通过内部多步骤推演来分解复杂问题。这种架构差异在编程任务中的影响将在评测结果中得到充分体现。
评分维度与标准:8大维度综合打分
评测从以下8个维度对每个模型的输出进行综合评分(满分9分):
- 代码正确性 —— 生成的代码能否通过测试
- 代码完整度 —— 是否包含完整的输入输出处理
- 解题思路 —— 是否清晰阐述了解题逻辑
- 算法分析 —— 是否说明了采用的算法和数学原理
- 复杂度分析 —— 是否给出时间和空间复杂度
- 测试用例 —— 是否提供了充分且有边界考虑的测试用例
- 代码注释 —— 7大语言的代码注释是否完整
- 自测与总结 —— 是否用测试用例验证了代码并做出总结
评测结果:Gemini 2.5 Pro与Claude 3.7 Sonnet并列第一
经过全面评测,最终得分排名如下:
| 排名 | 模型 | 得分 |
|---|---|---|
| 🥇 1 | Gemini 2.5 Pro | 9.0 |
| 🥇 1 | Claude 3.7 Sonnet | 9.0 |
| 🥉 3 | Grok 3 (Deep Think) | 7.8 |
| 4 | O1 Pro | 7.2 |
| 5 | O4 Mini High | 7.1 |
| 6 | O4 Mini | 5.0 |
Gemini 2.5 Pro和Claude 3.7 Sonnet以满分9.0并列登顶,展现出了当前AI模型在编程领域的最高水平。
Gemini 2.5 Pro:Google的编程王牌
Gemini 2.5 Pro(0325版本)的表现堪称完美,具体输出包括:
- 详细的解题思路和算法选择说明
- 完整的复杂度分析
- 带详细注释的Java代码
- 5个精心设计的测试用例,充分考虑了边界情况
- 7大编程语言的完整转换(Python、C++、C等),每种语言的注释都非常完整
- 最后还通过5个测试用例对所有语言的代码进行了自测验证,并做了总结
作为Google专为复杂任务打造的推理模型,Gemini 2.5 Pro在编程场景中的表现名副其实。其核心优势在于推理模型特有的"链式思考"机制——在生成最终代码前,模型会系统性地分析问题边界、推导算法正确性并验证中间结果,而非依赖训练数据中的相似代码进行模式复现。

Claude 3.7 Sonnet:不愧是编程天花板
Claude 3.7 Sonnet同样拿到了满分。有意思的是,它在回答过程中持续思考了2分27秒,这正是其扩展思考(Extended Thinking)模式在深度推理上投入大量计算资源的直观体现。其输出包含:
- 完整的Java代码实现,注释详尽
- 清晰的解题思路和数据结构/算法选择说明
- 5个详细的测试用例及测试说明
- 7大语言的代码转换
- 自测验证和总结
Claude 3.7 Sonnet被选为AI代码编辑器Cursor的主力模型,核心原因在于其超长上下文窗口(200K tokens)能够容纳大型代码库,同时扩展思考模式在处理复杂重构任务时表现出色。Cursor作为目前最受开发者欢迎的AI原生代码编辑器,基于VS Code深度改造,支持代码补全、自然语言生成代码、跨文件上下文理解等功能——Claude 3.7 Sonnet在本次评测中的满分表现,印证了这一选型决策的合理性,也配得上"编程天花板"的称号。
关键发现与深度分析
推理能力是编程的核心竞争力
从结果来看,具备深度推理能力的模型在编程任务中表现明显更好。推理模型与传统语言模型在架构设计上存在本质区别:标准语言模型采用单次前向传播生成答案,而推理模型在输出前会进行多步骤内部推演,系统性地分解复杂问题。Gemini 2.5 Pro和Claude 3.7 Sonnet都是以推理见长的模型,而得分较低的O4 Mini(5.0分)则是轻量级模型,推理深度有限。这一结果表明,在面对高难度算法题时,模型的推理架构比参数规模更能决定最终表现。
价格不等于实力
O1 Pro作为OpenAI每月200美元的旗舰模型,得分仅7.2,不仅低于两位冠军,甚至不如马斯克的Grok 3(7.8分)。这说明模型的定价策略与其在特定任务上的表现并不完全对等。O1 Pro的高定价更多反映的是其在科学研究、数学推导等专业领域的综合能力,而非编程任务的专项优化。开发者在选型时应以任务场景为导向,而非以价格作为能力代理指标。
输出完整性决定得分上限
满分模型的共同特点是回答的完整性极高——不仅给出了正确代码,还包含思路分析、复杂度说明、多语言转换、自测验证等完整链路。这与AI编程工具生态正在从"代码补全"向"全栈编程协作"演进的行业趋势高度吻合。选择AI编程助手时,不能只看代码正确性,还要关注模型的综合输出质量。
总结:如何选择适合你的AI编程助手
基于本次评测结果,给出以下选型建议:
- 追求最强编程能力:首选 Gemini 2.5 Pro 或 Claude 3.7 Sonnet,两者均拿到满分
- 需要性价比方案:Grok 3 Thinking 以7.8分提供了不错的编程辅助能力
- OpenAI生态用户:O1 Pro(7.2分)和O4 Mini High(7.1分)表现中规中矩
- 日常轻量编程:DeepSeek R1作为开源方案也值得考虑
AI编程能力的竞争正在白热化,模型迭代速度越来越快。今天的排名可能在下一次模型更新后就会改变,但有一点是确定的——AI正在成为每个开发者不可或缺的编程伙伴。
核心要点
- Gemini 2.5 Pro与Claude 3.7 Sonnet以满分9.0并列第一,成为当前最强AI编程模型
- 评测通过高难度算法题从代码正确性、解题思路、算法分析等8个维度进行综合评分
- O1 Pro(200美元/月)得分仅7.2,说明价格与编程实力并不完全对等
- 具备深度推理能力的模型在编程任务中表现显著优于轻量级模型
- 满分模型的共同特点是输出完整性极高,涵盖思路分析、多语言转换和自测验证全链路
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。