144.3M本地决策模型 vs 托管API:审批门选型指南
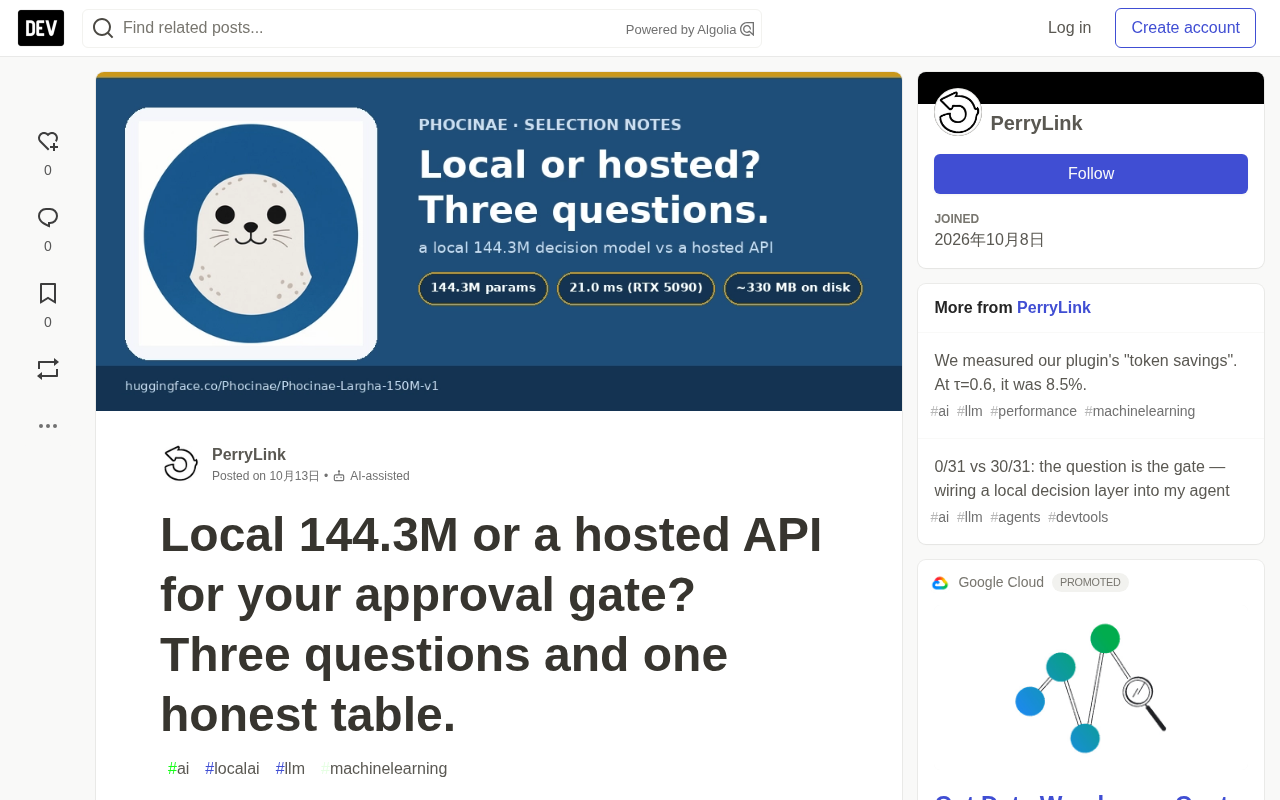
小模型本地跑审批门,大模型只接升级的不确定决策——本地与托管是路由而非替代。
文章以 Phocinae-Largha-150M-v1(144.3M 参数,Apache-2.0)为例,梳理编码代理中审批门的选型逻辑。决策模型不生成文本,而是接收状态加带类型问题(是/否、N 选一、2–10 分),一次前向传播返回答案与置信度,实现可审计、可重放的确定性决策,且零输出 token。选型取决于三个问题:决策触发频率、输入能否离开本机、答案集合是否封闭。低频多样或开放式答案留给托管模型。置信度升级门(τ=0.6)将 LLM 调用减少 55.0%,保留子集准确率从 0.906 提升到 0.9936。文章同时坦承尴尬数字:JevBench 读数 0.5455 未过门槛,工具路由是薄弱点,ECE 0.2519 需先重新校准,且模型明确不是安全判官。
编码代理在后台处理的事务,有相当一部分并不是"思考",而是权限判断:这条命令能跑吗?这张工单该归财务还是客服?这段输出可以发布吗?每一个都是小而结构化的决策。如果用聊天 API 来逐个处理,代价会出现在三个地方——每次调用的 token 消耗、网络往返延迟,以及决策上下文离开本机。
本文以 Phocinae-Largha-150M-v1(144.3M 参数,Apache-2.0 许可)为实例,梳理一套审批门(approval gate)的选型逻辑:什么该留在本地、什么交给托管模型,以及两边各自的数字和注意事项。
决策模型到底做什么
决策模型不聊天。你给它一个 状态(情境的简短描述)加上带类型的问题——noul(是/否)、choice(从 N 个中选一个)、score(2–10 分)——一次前向传播返回每个问题的答案和置信度。答案集合在调用之前就已存在:没有任何内容被生成,所以也不会漂移。
在模型卡自己的使用示例中,一次决策报告 input_tokens: 146, output_tokens: 0——零输出 token,因为没有输出文本。这正是它在"门"这个场景的关键价值:确定性、可审计、可重放的决策。
状态(state)与带类型问题(typed question) 是这套协议的两个基本输入。状态是情境的简短文本描述,比如"用户请求删除 /var/log 下的文件"或"这张工单提到退款和发票号";带类型问题则限定了模型的输出空间——noul 只允许是/否,choice 从预先给定的 N 个选项中选一个,score 落在 2–10 的整数区间。关键在于,每次前向传播一次性接收一个状态加上最多五个问题,返回每个问题的答案与置信度两个字段。置信度不是模型自报的概率,而是经过校准的列(见下文 ECE 说明),可以直接拿来做阈值判断。这套接口与传统聊天 API 的根本差异在于:输出分布被问题类型预先约束,模型没有自由发挥的余地,因此不会出现措辞漂移、格式错误或幻觉文本,这也正是可审计与可重放的形式基础。
三个问题帮你选对赛道
1. 这个决策多久触发一次?
如果同类型的决策一天出现几十次,调用托管 API 是划算的交易——低频、多样、方便。如果一天触发数千次——审批、分流、筛查、路由——算术就变了形状。本地前向传播没有按调用计费;成本转移到你控制的硬件上,且不随调用量增长。
2. 输入能离开这台机器吗?
审批门看到的可能是命令行、文件路径、日志尾部,有时还有客户内容。如果策略或常识要求这些上下文留在本机,决策就必须在本机做。这是三个过滤条件中最硬的一个,因为没有任何谈判余地。
3. 答案集合是封闭的吗?
如果可能的答案可以提前枚举——允许/询问/拒绝、队列 A 或 B、2–10 的严重度分数——带类型的决策模型就适配。如果答案是真正开放的——"写一份事故摘要""解释这个堆栈跟踪"——那就保留大模型。分界线不是模型大小,而是答案在你调用之前是否已经存在。
关于延迟和硬件有一条实用脚注:GPU fp16 下公布的 p50 为每次决策 21.0 ms(RTX 5090)。CPU 上更慢——单线程每个案例(一个状态加五个问题)1.64 s,8 线程约 8–20 决策/秒。这属于后台门的领域,不是交互式打字延迟。
数字,包括那些尴尬的
同一协议下的读数,每一行都带自己的注解——全部来自公开模型卡:
| 读数(带类型决策) | 值 | 发布说明 |
|---|---|---|
| Largha-150M-v1, en | 0.906 | 400 案例 / 2000 决策;在该数据集训练集上拟合的专家模型;模型卡指出这高于 0.735 的教师自一致参考,数据集卡标记远高于参考的分数存在标签特定过拟合风险 |
| Laya | 0.766 | 自测量,原生接口 |
| JEV | 0.727 | 通用模型,零样本 |
| meraGPT | 0.768 | 通用模型,零样本 |
谱系说明: 微调混合中包含一个 500 条的错误修正池,这些错误是从模型在带类型决策测试行上的预测中挖掘的。我们报告的 0.906 是拟合读数,不是零样本结果。
同样需要一起说的是那个尴尬的数字:JevBench public-231 读数为 0.5455(126/231)——低于其 58.4% 的接受门槛,未通过。 这个数字来自一个公开的 231 条集合,测量环境和协议与上面的 400 案例自评估不同——两者不能合并。模型卡如实公布了它,且那些 JevBench 行被排除在训练之外。
还有一个中文读数:0.848——在机器翻译的案例上测量,训练混合本身包含约 2400 条机器翻译中文行和约 1400 条母语中文行。把它当作拟合的中文结果,而非零样本迁移。
ECE(Expected Calibration Error,期望校准误差) 是衡量"模型说 0.8 置信度时,实际正确率是否真在 0.8 附近"的指标。数值越低表示置信度越可信,越高则说明模型自报的置信度与实际表现脱节。本文中出货的置信度列 ECE 为 0.2519,意味着模型在说"很有把握"时经常并没把握——如果直接拿这列做阈值门,会大量误放不确定决策。内置的重新校准列把 ECE 压到 0.0168,靠的是温度缩放(temperature scaling):在 softmax 前引入一个标量温度常数,重新拉伸 logits 分布,使概率更贴合真实命中率。温度常数是从验证集上拟合得出的,项目随包附带了该常数和校准所需列。因此实践上,任何基于 τ 的升级门都必须先走一遍重新校准,否则阈值形同虚设。
混合而非替换:升级门设计
让两边都保持诚实的方案是一个置信度门。每次决策返回一个校准过的置信度;在 τ=0.6 时,该门升级了 45.0% 的官方集决策,将 LLM 调用减少了 55.0%,保留子集准确率从 0.906 提升到 0.9936(全路由准确率 0.8135)。但模型卡上的原文小字是:"τ 在评估集上扫描得出——每个领域需要重新扫描。"
所以本地 vs 托管不是二选一。小模型承担稳态流量,托管模型只接收门标记为不确定、新颖或高风险的调用。升级不是失败——它是路由。
一个如果你要基于这个门构建就需要知道的诚实细节:模型卡上,出货的置信度列 ECE 为 0.2519(en);内置的重新校准列将其降到 0.0168。如果你根据置信度设置阈值,先重新校准——项目附带该列和完成校准所需的温度常数。
置信度门(confidence gate)与 τ 阈值 的原理很简单:每个本地决策返回置信度,若低于 τ 则升级给托管模型,否则直接采纳。τ=0.6 是在评估集上扫描得到的操作点,其效果——升级 45.0%、减少 55.0% 的 LLM 调用、保留子集准确率 0.9936——说明升级不是局部失效,而是一种分流机制。需要留意的两点:一是 τ 必须按领域重新扫描,医疗、金融、运维的置信度分布不同,直接照搬 τ=0.6 会失衡;二是升级率本身是运维指标,45% 的升级率意味着近一半流量仍要走托管调用,这直接决定成本结构。全路由准确率 0.8135 是指不设门、所有决策混合采纳时的整体表现——它低于保留子集的 0.9936,因为门放行的高置信决策中仍混有错误,这提醒我们提升保留子集质量并不等于提升全系统质量。
选型前必读的注意事项
- 工具路由是薄弱点。 项目的服务端会混淆语义接近的工具名——模型卡中可复现的案例在约 0.33 的置信度下返回
fetch_url而非web_search。低置信度选择应升级处理,绝不能作为最终结果。 - 不是安全判官。 模型卡的原话,在门的场景很重要:作为第一线信号配合升级——与自己的规则和人工路径配对,绝不能作为唯一守卫。
- 长文档推理不在范围内。 基础上下文 8192 token,模型卡的"它不是什么"列表中写着"不用于长文档推理"。把门的输入限制在状态和问题上,而不是文章。
- 这些是单一设置下的测量。 延迟和质量数字来自发布运行;你的硬件和流量会不同,值得自己测量。
- 模型卡在公开自我修正。 训练重叠披露在 10 月 10 日被更正,当前数字是在当前权重上重新测量的,并有修订历史。引用任何单一数字之前先读披露——包括我的。
工具路由(tool routing) 之所以是薄弱点,与模型规模直接相关。144M 参数要在一批语义相近的工具名之间区分——比如 web_search 与 fetch_url、refund_order 与 cancel_order——需要在嵌入空间中精确切分高度重叠的语义邻域,而小模型在这种细粒度对比上容易只抓到一个共享关键词就下判断。模型卡给的可复现案例是在约 0.33 置信度下返回了错误工具。好在低置信度是可见信号:只要严格遵守"低置信度选择必须升级、不得直接执行"的规则,工具路由错误可以被门拦下。这也是本文反复强调升级路径的价值——薄弱点不需要被消灭,只需要被识别并路由出去。任何直接采纳本地工具路由结果、不经置信度检查的部署都会放大这类错误。
值得试的,和不该试的
适合本地门的场景:
- 决策结构化且重复——命令审批、工单分流、输出筛查、文档路由;
- 输入不能离开机器——本地部署、气隙环境、受监管上下文;
- 按调用计费的形状不对,或者你希望稳态离线可用;
- 或者你想要一个能升级不确定案例的第一线门,而不是回答所有问题。
保留托管模型的场景:
- 答案是开放式文本——摘要、解释、长文档推理;
- 决策罕见且多样,没有模式可供摊销;
- 或者调用本身就是升级尾部——门明确拒绝猜测的那部分。
pip install phocinae-server
hf download Phocinae/Phocinae-Largha-150M-v1 --local-dir ./largha
PHOC_MODEL_DIR=./largha python -m phocinae.main   # 127.0.0.1:8155
第三方基准测试的总结值得保留:42 个真实决策,Jev(托管)整体 71.4%,而 Clef-Flash(9B,本地在他 3090 上运行)66.7%。他的框架是值得记住的:这个练习不告诉你哪个模型最好,它告诉你哪些调用在浪费钱。
透明声明:本文在 AI 辅助下起草;所有数字来自公开链接来源,未为此文运行新基准。
相关推荐

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。
ChatGPT 贴纸功能掀起 iMessage 与 WhatsApp 创意风暴
ChatGPT 图像生成功能正在 iMessage 和 WhatsApp 中催生个性化贴纸创作热潮,通用 emoji 使用量降至十年最低。本文分析这一趋势背后的技术逻辑、传播机制与对内容创作者的意义。