15岁开发者手写SLM训练器,寻求GPU真实硬件测试
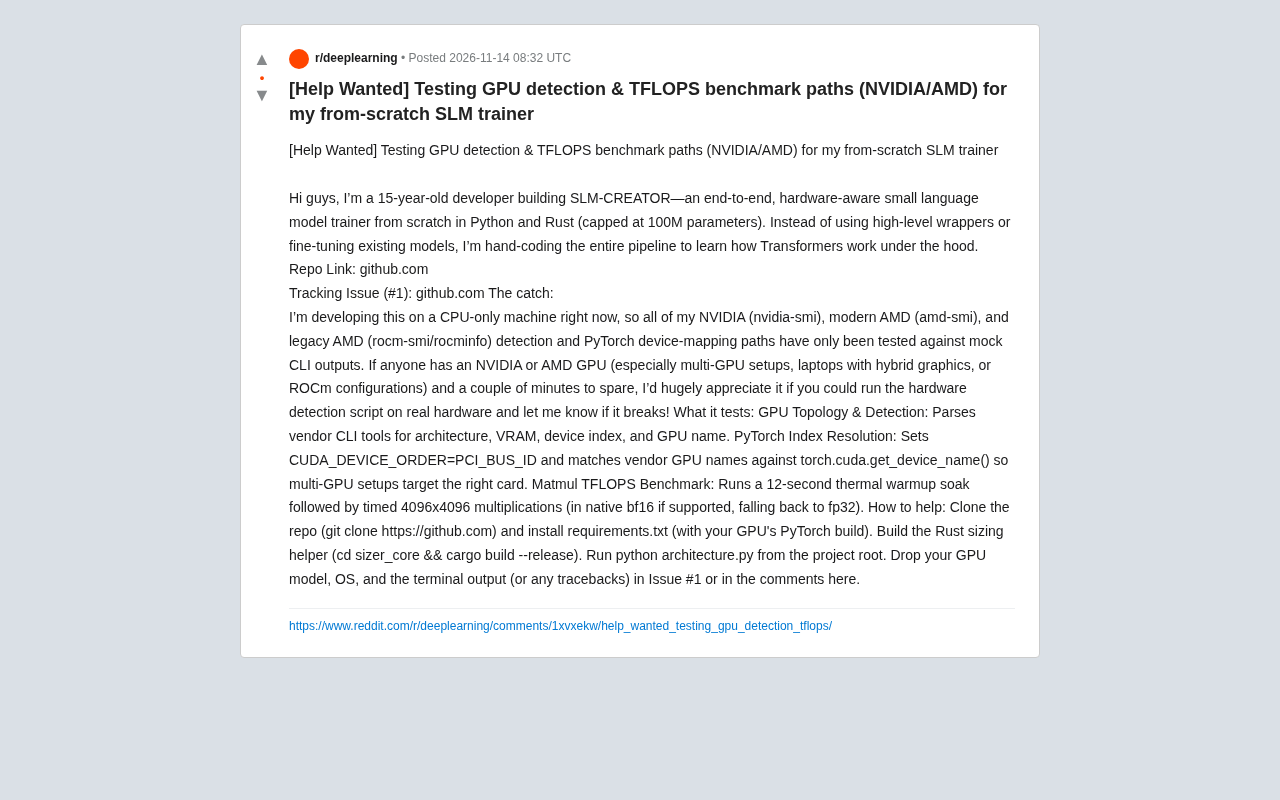
15岁开发者从零手写SLM-CREATOR训练器,求助真实GPU测试硬件检测脚本。
一位15岁开发者正在用Python和Rust从零构建参数量上限1亿的小语言模型训练器SLM-CREATOR,拒绝调用高层封装库,以深入理解Transformer内部机制。由于只有纯CPU机器,所有GPU相关代码路径(包括nvidia-smi、amd-smi、rocm-smi/rocminfo解析)都仅在模拟CLI输出上验证过。他在社区求助,希望有NVIDIA或AMD显卡的用户运行硬件检测脚本,重点覆盖多卡配置、混合显卡笔记本和ROCm环境。脚本测试GPU拓扑发现、PyTorch设备索引对齐(通过CUDA_DEVICE_ORDER=PCI_BUS_ID)以及4096×4096矩阵乘法TFLOPS基准(含约12秒热身,优先bf16回退fp32)。该项目凸显了AI工具链在硬件检测层的碎片化问题。
一位15岁的开发者正在从零构建名为 SLM-CREATOR 的小语言模型训练器,项目采用 Python 和 Rust 混合开发,参数量上限设定在 1 亿。与常见的「调用封装库」或「微调现成模型」路线不同,他选择手写整条流水线,目的是真正理解 Transformer 的内部运作机制。
项目现状:CPU 上开发,GPU 路径全靠模拟
目前最现实的障碍是硬件。开发者手头只有一台纯 CPU 机器,因此所有与 GPU 相关的代码路径——包括 NVIDIA 的 nvidia-smi 解析、现代 AMD 的 amd-smi 解析、以及旧版 AMD 的 rocm-smi/rocminfo 解析——都只在模拟的 CLI 输出上验证过。换句话说,代码能跑通「假数据」,但没人知道它在真实显卡上会不会当场崩溃。
他在社区发帖求助,希望有 NVIDIA 或 AMD 显卡的用户花几分钟跑一下硬件检测脚本,把输出或报错贴回来。特别欢迎多卡配置、混合显卡笔记本和 ROCm 环境——这些恰恰是模拟数据最难覆盖的场景。
脚本到底测了什么
GPU 拓扑与设备发现
脚本会调用各家厂商的命令行工具,解析出架构、显存容量、设备索引和 GPU 名称。这部分看似简单,实际坑很多:不同驱动版本输出的字段格式不一致,多卡机器的枚举顺序也未必符合直觉。
nvidia-smi、amd-smi 和 rocm-smi 分别是 NVIDIA、现代 AMD 和旧版 AMD(ROCm 栈)提供的命令行管理工具,用于查询 GPU 状态、拓扑和配置。nvidia-smi 输出格式相对稳定,但字段随驱动版本略有变化;amd-smi 是较新的工具,旨在统一 AMD GPU 管理接口,而 rocm-smi 和 rocminfo 属于 ROCm 软件栈,输出格式与 amd-smi 不同,且不同 ROCm 版本间也可能存在差异。这些工具的报告字段包括设备索引、PCI 总线地址、显存大小、架构代号和 GPU 名称,但字段命名和排列顺序并不统一,例如显存单位可能为 MiB 或 MB,设备索引可能从 0 或 1 开始。
多卡配置下,枚举顺序可能受驱动、BIOS 设置和操作系统影响,未必与物理插槽顺序一致。混合显卡笔记本中,集成显卡可能被厂商工具报告但不在 CUDA 可见设备列表中,导致索引错位。因此,解析这些 CLI 输出时需做字段归一化和容错处理,并尽可能结合 PCI 总线 ID 进行交叉验证。
PyTorch 设备索引对齐
这是整个检测流程里最微妙的一环。脚本会设置 CUDA_DEVICE_ORDER=PCI_BUS_ID,然后把厂商工具报告的设备名与 torch.cuda.get_device_name() 的返回值做匹配。原因是 PyTorch 默认的枚举顺序可能与 PCI 总线顺序不同,在多卡机器上如果不做这层对齐,训练任务很可能被分配到错误的卡上——错误不报,但性能对不上。
对于混合显卡笔记本,这个问题的破坏力更大:集成显卡和独立显卡的索引关系一旦搞错,脚本可能把模型加载到不该用的设备上。
CUDA_DEVICE_ORDER 是 CUDA 运行时的一个环境变量,用于控制 CUDA 可见设备的枚举顺序。默认情况下(FASTEST_FIRST),CUDA 会按照设备性能或驱动报告的任意顺序排列设备,这可能与物理 PCI 总线顺序不一致。而 PyTorch 的 torch.cuda 模块会遵循 CUDA 的设备顺序,因此当代码假设 device 0 对应第一块物理 GPU 时,实际可能指向另一块卡。设置 CUDA_DEVICE_ORDER=PCI_BUS_ID 会强制 CUDA 按 PCI 总线 ID 排序设备,使设备索引与物理插槽顺序一致。即便如此,PyTorch 的 torch.cuda.get_device_name() 返回的是设备名称字符串,仍需与厂商工具(如 nvidia-smi)的输出进行匹配,因为多卡同型号时名称可能相同,此时需结合 PCI 总线 ID 或 UUID 来精确对齐。
在混合显卡笔记本上,集成显卡通常不被 CUDA 枚举,但可能被其他框架(如 DirectML 或 ROCm)识别,导致不同工具报告的设备索引体系不同。因此,跨厂商、跨环境的设备索引对齐需要同时考虑枚举顺序、设备名称和唯一标识符,仅靠环境变量不足以完全消除歧义。
Matmul TFLOPS 基准测试
性能测部分采用「先热身再计时」的思路:先跑一段约 12 秒的预热让 GPU 进入热稳定状态,然后对 4096×4096 的矩阵乘法计时。原生支持 bf16 的卡会用 bf16 跑,否则回退到 fp32。这个设计考虑到了真实使用场景——短时间突发测试会高估持续吞吐,热身后的数据才更接近训练时的实际表现。
bf16(bfloat16)是一种 16 位浮点格式,拥有与 fp32 相同的 8 位指数位,但尾数位仅 7 位,因此动态范围与 fp32 一致,精度低于 fp16。在深度学习训练中,bf16 能避免梯度下溢或上溢,且现代 NVIDIA GPU(Ampere 架构及以后)和 AMD GPU(CDNA 架构)原生支持 bf16 矩阵乘法,吞吐量通常是 fp32 的数倍。若 GPU 不支持 bf16,则回退到 fp32 进行基准测试,此时测得的 TFLOPS 会显著偏低,反映的是 fp32 路径的性能而非训练常用混合精度的性能。
TFLOPS(每秒万亿次浮点运算)是衡量矩阵乘法性能的常用指标,计算公式为 2×M×N×K / 耗时(秒)/ 1e12,其中因子 2 代表一次乘加运算。对于 4096×4096 的方阵乘法,理论浮点运算量为 2×4096^3 ≈ 137.4 GFLOP。热身阶段(约 12 秒)旨在让 GPU 时钟提升至稳态频率并避免因功耗管理导致的降频,从而获得更接近持续训练负载的吞吐数据。短时间突发测试可能因 GPU 加速频率而高估性能,热身后的计时更能反映真实训练场景。
为什么这个项目值得关注
从工程角度看,SLM-CREATOR 的核心价值不在「又一个训练框架」,而在它的学习路径:从零实现意味着必须处理硬件探测、设备映射、混合精度、算子性能这些通常被高层 API 隐藏掉的细节。把参数量压到 1 亿以内,则让整个系统保持在个人硬件可承受的范围内,也让调试变得可行。
从社区角度看,这个求助帖本身是个典型样本:AI 工具链的碎片化在硬件检测这一层暴露得最彻底。NVIDIA、AMD 新卡、AMD 旧卡三套工具链并行,各自的输出格式和字段语义都不统一,任何想写「硬件无关」代码的人最终都要面对这堆兼容性泥潭。
如何参与测试
开发者给出了清晰的操作路径:克隆仓库、按本机 GPU 安装对应的 PyTorch 版本和 requirements.txt、进入 sizer_core 目录用 cargo build --release 编译 Rust 辅助模块,然后在项目根目录运行 python architecture.py。把 GPU 型号、操作系统和终端输出(包括 traceback)贴到 Issue #1 或帖子评论区即可。
对于手里有卡的开发者来说,这是一次成本很低但价值明确的贡献——几分钟的运行,能帮一个从零手写训练器的项目跨过「只在模拟环境验证过」这个尴尬阶段。
相关推荐
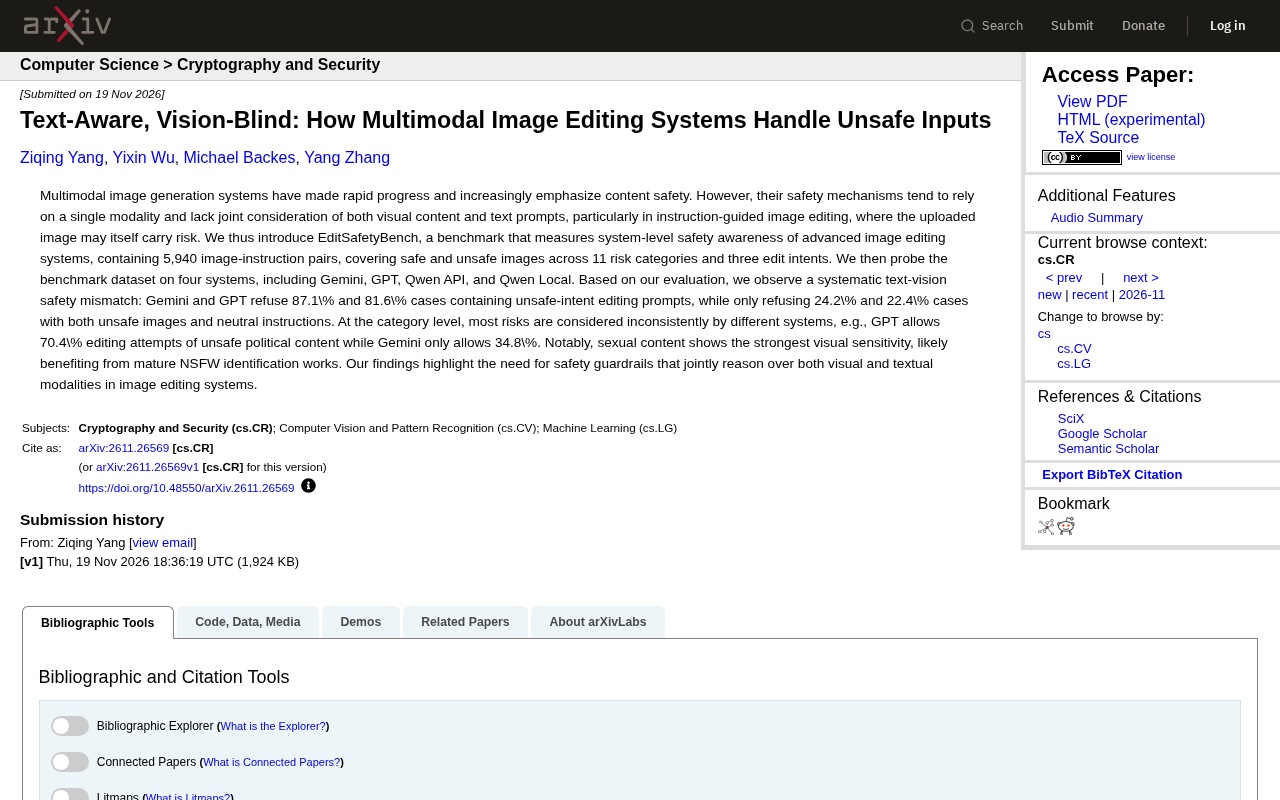
多模态图像编辑的安全盲区:文本敏感、视觉失明
EditSafetyBench基准测试Gemini、GPT、Qwen等图像编辑系统,发现文本-视觉安全错配:系统对不安全提示拒绝率高,对不安全图像却大幅放行,呼吁多模态联合安全护栏。
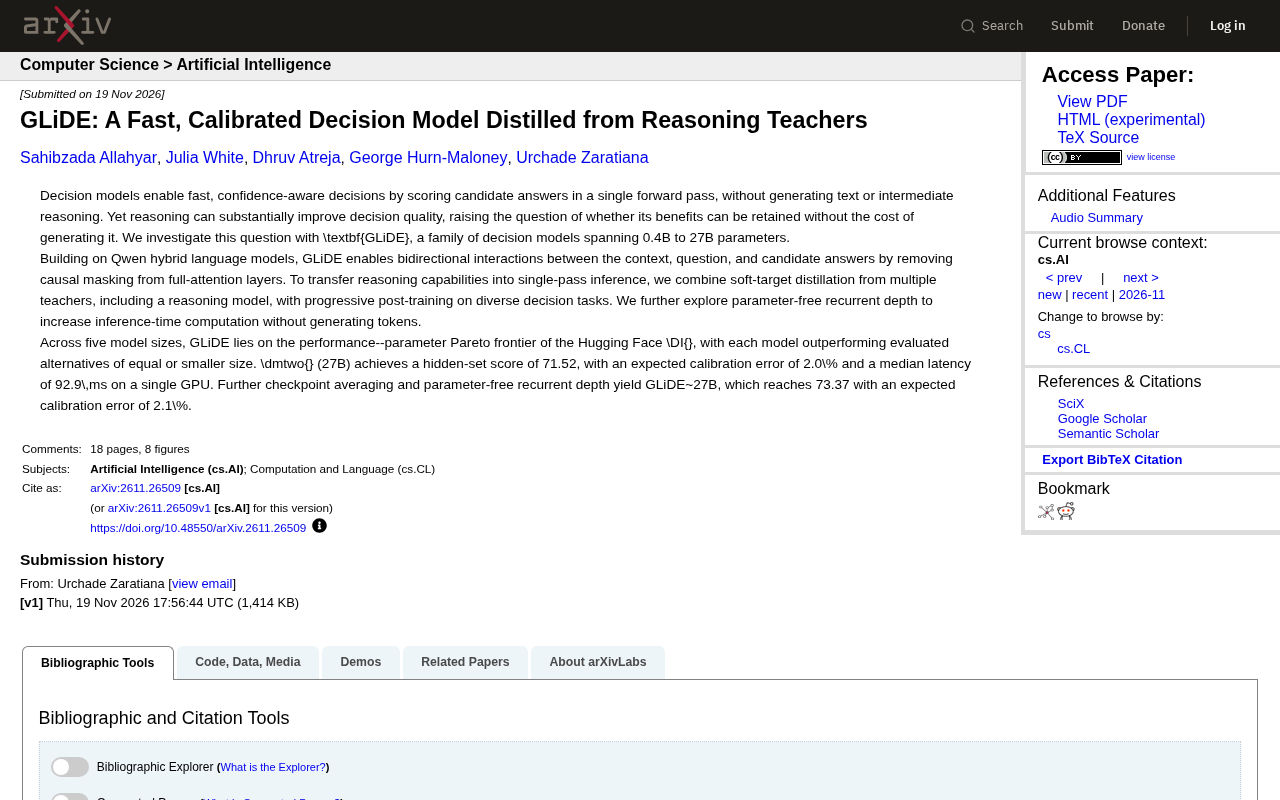
GLiDE:从推理教师蒸馏的快速校准决策模型
GLiDE 是一系列从推理教师蒸馏而来的决策模型,参数覆盖 0.4B 到 27B,通过移除因果掩码和软目标蒸馏实现单次前向的快速校准决策,27B 模型隐藏集得分 71.52,校准误差 2.0%,延迟 92.9ms。
用Claude Code几分钟搭建专业网站:五步实战指南
详解如何用Claude Code在几分钟内搭建专业网站:从规划提示词、精准迭代、MCP接入图片生成,到参考图重做设计与一键发布上线的完整五步流程。