16G AMD显卡本地跑通YuE音乐生成:9070XT移植实测
16G显存AMD 9070XT仅改五处代码,成功本地生成完整中文歌,性能超官方方案。
B站UP主用16G显存的AMD 9070XT完整跑通了开源音乐生成模型YuE,本地产出了一首2分55秒的中文歌曲,峰值显存仅11-12G,远低于官方要求的24G门槛。整个从CUDA迁移到ROCm的过程仅涉及五处源码改动,因为ROCm的HIP层已经将`torch.cuda`接口全部兼容。迁移过程中最深的两个坑是MIOpen运行时编译缺失头文件,以及包管理器将Torch和TorchAudio配成版本不匹配的组合。意外收获是调整VAE解码的分块帧数后,整体耗时从613秒降到393秒,提速35.9%,甚至快过官方命令行方案。唯一必须严格避开的禁区是FP8量化,会静默产出相对误差高达90%-117%的垃圾音频。完整移植方案已开源在GitHub,含六步部署流程。
一张16G A卡,写出一首完整中文歌
一直以来,AI音乐生成模型几乎是N卡的专属领地。官方推荐配置动辄要求24G显存的NVIDIA显卡,AMD用户基本被挡在门外。这次B站UP主的实测打破了这个惯例——用一张16G显存的AMD 9070XT,从歌词到波形完全本地生成了一首2分55秒的完整中文歌《那年夏天的诺言》,词、曲、演唱、伴奏全部由模型在本机产出。
主角是开源音乐生成模型 YuE(原文中的"U1""UAR"应为YuE的口误转写)。它采用两段式架构:先用符号规划写出一份可编辑的ABC乐谱,再合成为音频,旋律和配器都可以在中间环节修改。模型权重来自月夜2(m-a-p)团队、香港科技大学与MAP联合发布,采用非商用许可,仅允许研究和学习使用。
更关键的是,整个实测不是"只点亮能力标志",而是真实跑通并铲出文件——出歌、音频转谱、乐谱渲染、参考音色四项能力全部落地,峰值显存仅用到11-12G,远低于官方要求的24G门槛。
CUDA到ROCm:真正要改的其实很少
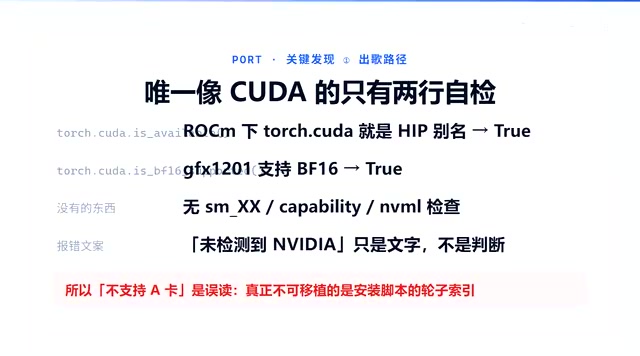
最反直觉的发现是:整条出歌链路里,真正属于"N卡专属"的东西少得惊人。要移植的T8工作流仓库(作者T8star)里全文甚至没有出现"AMD"字样,但迁移到ROCm平台并没有想象中那么难。
出歌路径上唯一长得像CUDA的代码只有两行——torch.cuda.is_available() 和 is_bf16_supported()。而在ROCm环境下,torch.cuda 本身就是HIP的别名,这两行都会正常返回真值。报错文案里那句"NVIDIA"也只是文字提示,不参与实际判断逻辑。
模型权重与上游的版本锁定逐位一致:YuE 2 3B 和 VAE 的哈希完全相同,官方仓库下载的字节与镜像下载的字节也一模一样。所以真正需要动的,只有安装脚本里的轮子——从CUDA的PyTorch换成AMD的ROCm索引。源码层面总共只改了五处,每一处都有明确成因。
ROCm(Radeon Open Compute)是AMD针对GPU通用计算推出的开源软件栈,功能上对应NVIDIA的CUDA。ROCm的核心组件HIP(Heterogeneous-computing Interface for Portability)提供了一套与CUDA高度相似的API,使得大量CUDA代码可以几乎不改动地移植过来。PyTorch的AMD版本正是基于HIP构建的,因此在ROCm环境下,torch.cuda 命名空间被保留并映射到HIP的对应实现——这就是为什么那两行CUDA判断代码在AMD卡上也能正常返回真值。理解这一层"API别名"机制是理解整个移植难度远低于预期的关键:绝大多数深度学习框架已经在抽象层面屏蔽了底层差异,真正的不兼容点往往只集中在少数依赖硬件特定指令集或运行时库的角落。
五处改动与两个最深的坑
五处改动各有针对:解码时注意力后端被误判成flash需要修正;VAE分块帧数隐含着24G卡的假设;音频工具链在导入时求值会触发分布式算子;模型仅剩的FP32模块会导致编译失败;音频保存需要换成soundfile后端来绕开MIOpen。
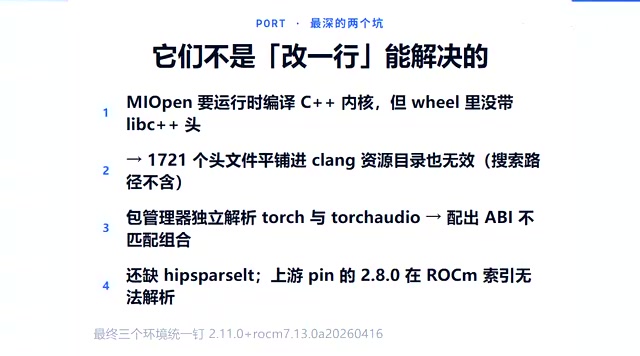
其中两个坑最深。第一个是MIOpen需要在运行时编译C++内核,但环境里没有携带标准库头文件,即便把1700多个头文件平铺进Clang资源目录也无济于事。第二个是版本地狱:包管理器会独立解析Torch和TorchAudio,配出接口不匹配的组合,最终必须把三个环境统一锁定在同一个版本上。
作者还总结了两条工程纪律:补丁必须幂等可重放——在干净的上游代码上跑,八条锚点全部命中,重跑时全部跳过,铲出的文件与原版逐字节一致;同时必须保留原文件的换行符,否则两行的修复会被扩散成整个文件的改动。
MIOpen是AMD GPU的深度学习原语库,相当于NVIDIA的cuDNN,负责卷积、归一化、激活函数等算子的高性能实现。与cuDNN将内核预编译进库不同,MIOpen在首次遇到新的算子配置时会在运行时动态编译C++内核(称为"kernel fusion"或JIT编译),这一机制需要本地存在完整的C++工具链和系统头文件。这也是为什么即便把1700多个头文件手动平铺进目录也无法解决问题——MIOpen的编译流程对头文件的组织结构和依赖路径有严格预期,简单复制文件并不等于重建了完整的编译环境。这个坑在容器化部署中尤其常见,因为为了精简镜像体积,标准库头文件往往被裁剪掉。
分块帧数:意外带来35.9%的提速
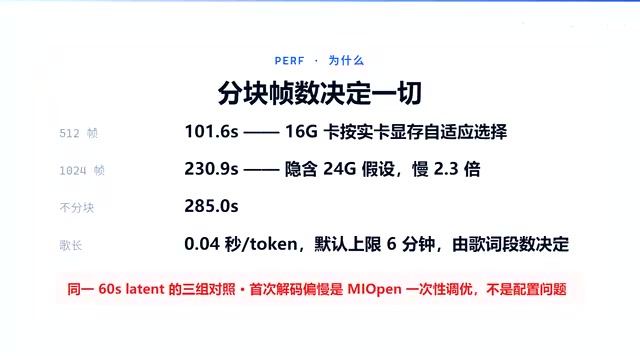
第二处改动带来了最大的惊喜。同一个请求,耗时从613秒降到393秒,快了35.9%。其中VAE解码从313秒降到107秒,折合每音频秒从3.5秒降到2.25秒,甚至快过官方命令行只跑出的423秒。
原因在于分块帧数。在16G卡上,1024帧会命中一个慢得多的内核。同一段60秒音频,512帧只需101秒,1024帧却要231秒,不分块反而是285秒。这说明硬件与内核选择的匹配,有时比单纯堆显存更影响实际性能。
正确性也有硬信号背书:同一个种子、同一份歌词,官方命令行和T8这条完全不同的代码路径,产出的音频时长逐位一致——都是174.91866秒,说明整个移植过程没有引入任何行为偏差。
四项能力实测与必须避开的禁区
四项能力的实测数据清晰:出歌产出175秒音频;音频转谱4秒素材耗时36秒输出ABC和MIDI乐谱;乐谱渲染输出可打印PDF和钢琴试奏音频;参考音色47秒完成。
需要划清边界的是:转谱由Sheet Sage配合谱面工具、再由abcjs渲染成乐谱;而参考音色是T8作者加的后处理——分离人声、换音色再重混,跟YuE模型本身零代码引用,这与官方"翻唱"(在谱面之后重新生成一版演唱)完全是两回事。
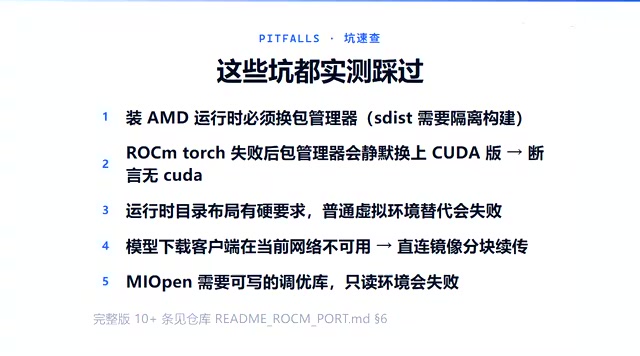
最后是几个必须避开的禁区。安装AMD运行时要更换包管理器,否则安装失败时它会静默换上CUDA版,所以要断言版本里没有CUDA运行时。目录布局有硬性要求,普通虚拟环境替代会失败。最危险的一条:绝对不要打开FP8量化。能力门会放行、矩阵乘法也能跑,但结果相对误差高达90%到117%——这不是精度损失,而是计算错误,会静默产出垃圾音频。
FP8(8位浮点)量化是一种将模型权重和激活值压缩到8位表示的技术,目的是减少显存占用和加速推理。FP8有两种常见格式:E4M3(4位指数、3位尾数)和E5M2(5位指数、2位尾数),分别适用于不同的数值范围场景。在支持良好的硬件和驱动组合上,FP8量化可以在几乎不损失精度的情况下显著提速。然而,FP8的硬件支持非常新,不同GPU架构的实现存在差异,软件栈的适配也不完整。文章中描述的90%-117%相对误差并非轻微精度退化,而是计算逻辑本身出错——可能是量化缩放因子计算错误或格式转换存在缺陷,导致数值完全失真。危险之处在于模型不会报错,会正常产出音频文件,只是内容是噪声。
结语:开源生态的边界正在被拓宽
从许可角度看,YuE权重为非商用,仅供研究学习,生成作品建议标注"AI生成",模型输入只接受风格和歌词(可选一份乐谱),不接受音频参考。整个移植方案已开源在GitHub,包含克隆上游仓库、安装三个ROCm运行时、应用移植补丁、拉取12.2G模型并校验哈希、双击启动脚本跑能力自检的完整六步流程。
这次实测的价值不止于"AMD也能跑",更在于它证明了很多所谓的硬件门槛,本质上是软件默认配置带来的假象。当一张16G的消费级A卡就能本地生成完整歌曲,本地化AI创作的门槛正在实实在在地降低。
相关推荐
Claude Code与Codex企业级实战:AI工程化编程如何搞定复杂项目
从氛围编程到AI工程化编程,本文解析Claude Code与Codex企业级项目实战:三种开发模式递进、国产大模型选型、SuperPower插件流程,以及Open Router聚合平台背后的AI行业盈利逻辑。
开源桌面端CC-HAHA上手:让AI自动操作你的电脑
开源桌面客户端 CC-HAHA 新增 computer use 电脑操控功能,让 AI 通过虚拟鼠标自动操作电脑。本文详解三步配置流程、实际效果演示,并分析不同模型在操作电脑能力上的差异与局限。
Claude Code桌面版实操:中文汉化+免登录+接入DeepSeek全攻略
手把手教你安装 Claude Code 桌面版,实现免账号使用、中文汉化,并通过 CC Switch 接入国产模型 DeepSeek,还包含自定义 Skill 导入的完整实操步骤,帮你低成本跑通 Claude Code 工作流。