16G内存Mac mini跑通330亿参数视频大模型:苹果VPIPE实测

VPIPE用权重流式传输让16GB Mac mini跑通330亿参数有声视频大模型。
文章介绍B站UP主实测:借助苹果原生推理引擎VPIPE的权重流式传输技术,16GB内存的入门级Mac mini成功运行了原始体积高达115GB的MiniMax H3多模态视频大模型,并生成带立体声的AI视频。其核心思路是把SSD当显存用,50层模型像履带一样按需轮流加载,配合分阶段清场与自适应驻留策略控制内存峰值。Mac mini的统一内存架构与主动散热风扇是效率前提。实操上先跑约15分钟的8bit分组量化与注册,再加载文生视频工作流调整三个节点,挂Turbo LoRA后4到8步即可出片,480p约5秒视频实测约4分钟。VPIPE体积不到30MB,核心计算直接编译为Metal原生内核,效率反超庞大Python框架。
苹果芯片的统一内存架构,让入门级Mac mini也能挑战330亿参数的多模态视频大模型。B站UP主实测显示,借助苹果原生推理引擎VPIPE的权重流式传输技术,16GB内存的Mac mini成功生成了带立体声的AI视频。这背后是一套与常规本地推理完全不同的工程思路。
为什么16GB内存能跑几十GB的模型?
MiniMax H3原始BF16模型体积高达115GB,常规压缩后全载入内存也至少要几十GB。在16GB Mac mini上直接运行,理论上会因内存溢出(OOM)闪退。VPIPE的解法是六个字:权重流式传输(Weight Streaming)。
UP主用了一个直观的比喻:传统本地AI运行像必须把整部60GB的4K电影下载到手机内存才能播放;而流式传输像在线看流媒体,内存不需要装下整部电影,算多少从硬盘读多少。MiniMax H3内部有50个结构相同的计算层(Blocks),数据按顺序从第一层算到最后一层,VPIPE正是利用这个串行特性做文章。
三阶段内存管理策略
VPIPE做了三件关键的事。第一,分阶段彻底清场:负责理解提示词的320亿参数文本编码器(Qwen VL 32B)算完后,立刻从内存彻底卸载,绝不让它和视频模型抢内存。第二,模型常驻硬盘按需动态搬运:几十GB权重安静躺在SSD上,计算开始时先把当前层读进内存。第三,智能自适应驻留(Adaptive Residency):算完的层如果内存还有富余就留住常用块,内存紧张就立刻释放旧层换入下一层,像履带一样把50层轮流滚完一遍。
BF16 与量化格式:BF16(Brain Floating Point 16)是一种 16 位浮点格式,与 FP16 一样占 2 字节,但保留与 FP32 相同的 8 位指数位,只牺牲尾数精度。这让它动态范围大、训练稳定,是大模型权重存储与推理的常用默认格式。代价是体积庞大——一个 330 亿参数模型按 BF16 存储约需 66GB 显存/内存,这也是文中 115GB 原始模型体量的来源。量化则把每个权重从 16 位压缩到 8 位甚至 4 位整数,体积随之砍半或降至四分之一,推理时再反量化回高精度参与计算。8bit 量化通常画质损失极小,4bit 更省空间但精度余量更小,这正是文中建议“空间够就优先选 8bit”的原因。
OOM 与内存溢出:OOM(Out Of Memory)指程序申请的内存超过系统可用上限,操作系统或运行时无法满足分配请求,通常会直接终止进程,表现为应用闪退或报错。在本地大模型推理中,模型权重、激活值、KV 缓存和中间张量都占用内存,一旦某一层的计算所需超出剩余容量就会触发 OOM。权重流式传输的核心价值,就是把“同时驻留全部权重”的峰值需求,拆解为“一次只驻留一层”的低峰值需求,从而让 16GB 这类小内存设备也能在理论上跑通远超内存容量的模型,代价是增加了硬盘读取的 IO 开销。
Mac mini的硬件优势:统一内存与主动散热
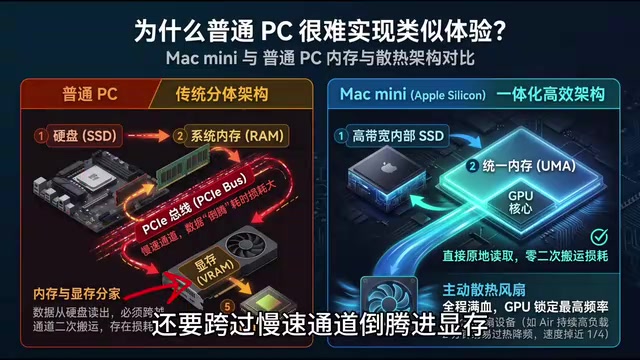
普通Windows PC很难这么玩,因为内存和显存分家,数据从硬盘读出后还要跨过慢速通道搬进显存。Mac mini有两个天然优势。
一是统一内存架构,加上高带宽内部SSD,数据从硬盘读进统一内存后GPU核心直接原地读取,没有二次搬运损耗。二是Mac mini自带主动散热风扇——无风扇的MacBook Air持续跑这种高负载视频生成,两分钟就会过热降频,速度掉将近四分之一;带风扇的Mac mini可以全程锁死GPU最高频率,把流式传输的效率发挥到极致。
上手准备:硬盘空间是最容易踩的坑
机器要求任何Apple Silicon M系列芯片的Mac,内存最低16GB起步,内存越大能驻留的层块越多、速度越快。
硬盘空间才是重点。UP主演示的是画质更好的8bit量化方案:转换准备阶段原模型和量化输出同时存在,磁盘峰值需要预留约180GB;等量化完成删掉115GB原文件后,最终只需保留约65GB。如果硬盘吃紧,可以把工作流改成4bit方案,峰值只需155GB,最终保留约45GB。不过在流式加载下8bit和4bit生成速度差不多,8bit画质更稳,空间够就优先选8bit。
UP主提到一个容易忽略的细节:原模型和输出目录必须在同一磁盘分区,因为VPIPE会对不需要量化的音视频解码器VAE使用硬链接来省空间,跨分区硬链接失效就会多占一倍空间。
两步实操:量化瘦身与出片
VPIPE整个安装包不到30MB,不需要折腾Python环境。安装后用聚焦搜索打开VPipe Manager,设置工作目录,在Pipelines选项卡添加工作流,切到Web UI启动服务器即可,甚至可以用手机扫码连上去控制。
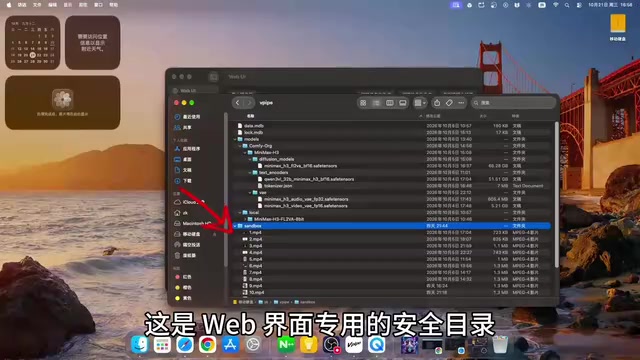
第一步:一次性量化与注册
在控制台加载Prepare Minimax H3 8bit工作流,点击运行。在UP主的Mac mini上这个过程大约15分钟,只需第一次使用时跑一遍。工作流做两件事:把原版MiniMax H3注册进数据库,以及把BF16模型转换成针对苹果芯片优化的8bit仿射分组量化格式。
分组量化的逻辑是把权重矩阵切成每64个参数一组的小格子(Group Size等于64),每组单独配一套缩放比例和中心偏移量,体积砍半的同时几乎看不出画质损失。这里有个针对MiniMax H3的硬核细节:模型130亿参数里负责每一步条件控制的调制层、模型主体以及320亿参数文本编码器,全部被量化为8bit,而不少普通量化工具会漏掉调制层这一块。
分组量化与仿射量化:分组量化(Group-wise Quantization)把权重矩阵按固定大小(此处 Group Size 为 64)切成若干小组,每组独立计算一套量化参数,而不是整个矩阵共用一套。仿射量化(Affine Quantization)为每组存储一个缩放因子(scale)和一个零点偏移(zero-point),反量化时用 w ≈ scale × q + zero_point 还原近似值。分组越小,量化误差越低、精度越好,但额外的 scale/zero-point 元数据也越多。相比逐张量量化,分组仿射量化能在体积与画质间取得更好平衡,这也是文中 8bit 方案“体积砍半几乎看不出画质损失”的技术基础。
第二步:加载文生视频工作流出片
量化完成后卸载工作流,加载MiniMax H3 text-to-video工作流。流程图很直观:提示词经编码器送入generate video核心节点,右侧分出两条线,上面解码画面、下面解码立体声,最后在save video节点合成。需要改三个节点。
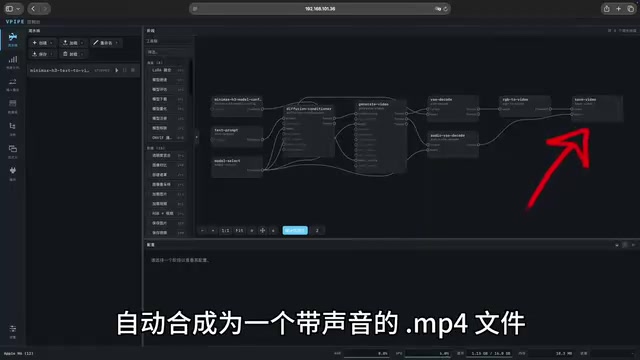
第一个是model config节点,挂载Turbo LoRA并选ema后缀版本。原始MiniMax H3需要跑16步,社区用蒸馏技术训练的Turbo LoRA只有几百MB,挂上后4到8步就能收敛,速度直接快3到4倍。ema代表指数移动平均权重,是对训练历史做平滑处理的结果,在4步极限压缩下画面细节和动作更稳定。
第二个是text prompt节点。因为MiniMax H3的声音和画面从同一个文本提示词里长出来,没有单独音频输入框,写提示词时要把发声物体或环境音一起写进去,比如“沉稳有节奏的踏沙声、海风吹拂声与远处的舒缓海浪白噪音”,模型就会自动生成风声。
第三个是generate video节点。宽高两个数字都必须是32的倍数,比如默认960×544或480p的832×480,不是32倍数系统会自动向上取整。帧率默认24,底层解码器按16n+5切块,填120帧会对齐成124帧(约5.17秒),属正常现象。挂了Turbo LoRA后步数控制在4到8步,不要超过8步,否则可能出现画面过锐化或伪影。
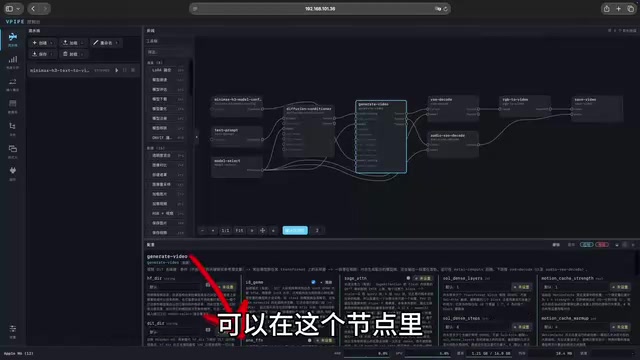
M4或M6芯片的Mac mini可以在该节点打开相关选项,让苹果神经网络引擎ANE帮GPU分担近一半的投影计算,速度能再快20%以上。据UP主实测,480p约5秒、4步的有声视频大约需要4分钟;960×544分辨率、5到6步的配置大约在5到11分钟。配合带preview的工作流和约23MB的轻度设定,还能在网页上实时看到视频从噪点变清晰的过程。
LoRA 与蒸馏加速:LoRA(Low-Rank Adaptation)是一种低秩适配微调方法,它冻结原模型权重,只训练并挂载少量低秩矩阵来注入新能力,因此文件往往只有几百 MB。文中 Turbo LoRA 并非教模型新知识,而是通过蒸馏训练把原本需要 16 步的采样过程压缩到 4 到 8 步即可收敛,相当于给模型装了一个“加速补丁”。EMA(指数移动平均)则是在训练过程中对权重做滑动平均,取平滑后的版本作为最终权重,通常能降低噪声、提升稳定性,在极少步数的极限压缩下对画面细节和动作连贯性帮助明显,因此推荐选用 ema 后缀版本。
体积不到30MB,效率为何反超Python框架
同样在Mac上跑本地模型,VPIPE体积不到30MB,效率却比很多动辄十几GB的Python框架高很多,原因在工程设计。其一,零Python与零第三方框架开销:常规MLX像高级语言工具箱,Metal像直接操控硬件的汇编语言,VPIPE推理时不走Python解释器、不链接庞大外部运行库,核心计算逻辑直接编译成内嵌Metal原生计算内核,还内联复用了MLX的Steel矩阵算子模板。其二,C++线程流水线驱动画面、音频、文本的流转,配合苹果芯片矩阵加速单元,把硬件算力榨到极致。
这套方案的启示在于:本地大模型的门槛不只取决于内存容量,更取决于数据搬运的工程设计。权重流式传输把SSD变成显存的延伸,让16GB内存的入门Mac mini也能拥有属于自己的330亿参数有声视频工作站——不需要配环境,不需要调用付费API。
(本文基于B站UP主实测视频整理,工具包与工作流以原作者发布为准。)
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。