16岁入门机器学习:从零到实战的完整学习路径

写在前面:一个16岁少年的提问
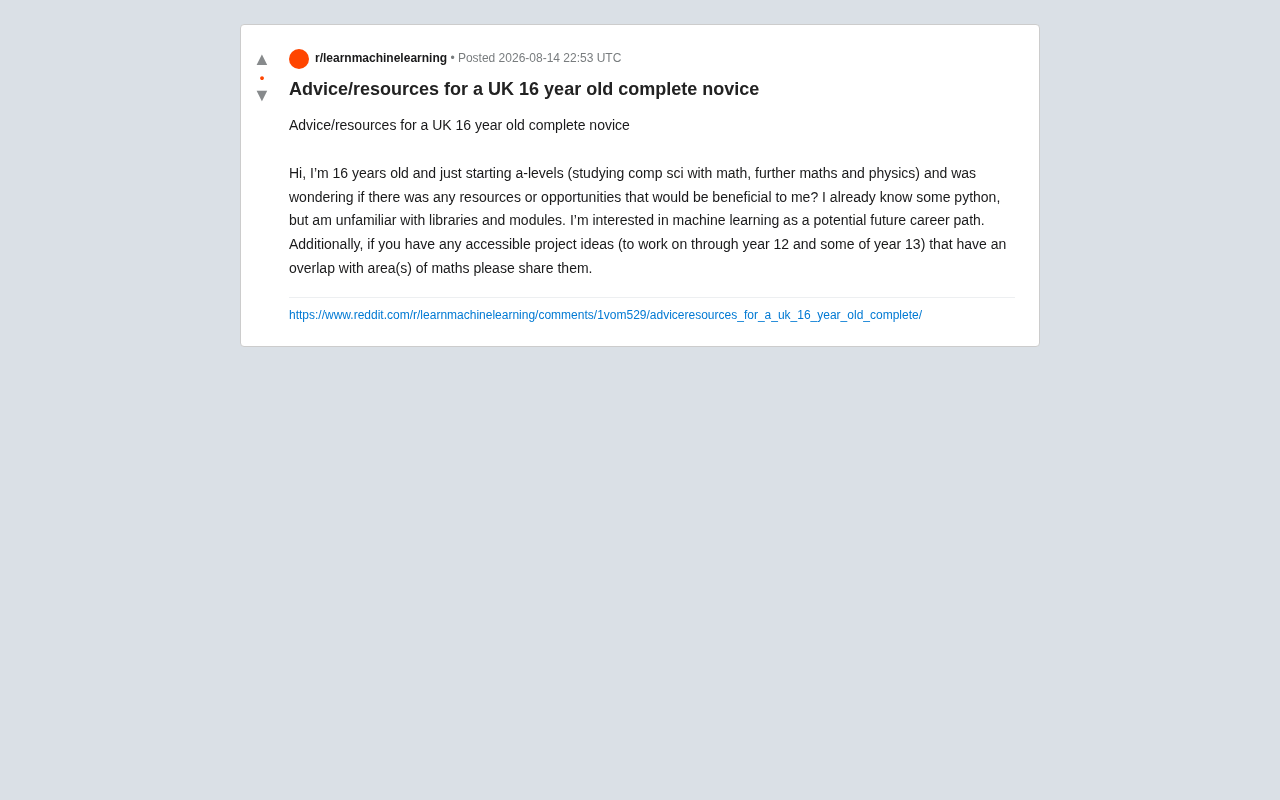
在Reddit的机器学习社区里,一位来自英国、正在准备A-Level考试(选修计算机科学、数学、进阶数学和物理)的16岁学生提出了一个很有代表性的问题:作为一个了解一点Python、但对库和模块不熟悉的完全新手,应该如何入门机器学习?有没有适合Year 12到Year 13阶段、并且能与数学结合的项目建议?
A-Level(Advanced Level)是英国的高中阶段学术资格考试,通常在Year 12和Year 13(即16-18岁)完成。学生一般选修3-4门科目进行深入学习,其中Further Maths(进阶数学)涵盖了大学预科级别的线性代数、复数、微分方程等内容,这些在很多国家的教育体系中要到大学才会系统接触。选修这一科目的学生在申请牛津、剑桥等顶尖大学的理工科专业时具有显著优势。值得一提的是,A-Level课程体系在全球范围内被广泛认可,除英国本土外,新加坡、香港、马来西亚等地也采用类似体系。与美国AP课程体系中的AP Calculus BC和AP Statistics相比,A-Level Further Maths在线性代数方面的覆盖深度更大——矩阵变换、特征值分解等内容都是标准教学模块。这意味着选修Further Maths的英国学生在机器学习的数学准备上,实际上比许多国家的同龄人更具先发优势。
这个问题看似简单,但背后隐藏着许多初学者共同的困惑:面对庞杂的资源,从哪里开始?如何把数学基础转化为实际的机器学习能力? 本文将结合这个真实场景,梳理一条清晰、可执行的入门路径。
为什么这个起点非常有优势
先说一个容易被忽视的事实:这位提问者的处境其实相当理想。
机器学习的两大支柱是编程能力和数学基础。而他恰好同时在系统学习进阶数学(Further Maths)和物理——这意味着他会较早接触到线性代数、微积分、概率统计的核心概念,而这些正是机器学习的数学地基。
很多成年人转行机器学习时,最大的障碍恰恰是数学。梯度下降需要微积分,神经网络的前向传播本质是矩阵运算(线性代数),模型评估离不开概率与统计。梯度下降(Gradient Descent)是机器学习中最核心的优化算法之一,其本质是利用多元微积分中的偏导数概念,沿着损失函数下降最快的方向迭代更新参数。具体来说,对于一个损失函数L(θ),算法通过计算∇L(即各参数的偏导数组成的梯度向量),然后按θ = θ - α·∇L的规则更新参数,其中α是学习率。这个过程在几何上就是在高维"山谷"中寻找最低点。A-Level数学中学到的求导法则、链式法则,正是理解反向传播算法的数学基础。
反向传播(Backpropagation)算法是训练神经网络的核心方法,由Rumelhart、Hinton和Williams在1986年的论文中推广。其数学本质是链式法则(Chain Rule)的系统化应用——在一个多层网络中,输出层的误差需要逐层向后传递,而每一层参数的梯度都可以通过将后续层的梯度与当前层的局部梯度相乘来高效计算。A-Level Further Maths中学到的复合函数求导法则正是理解这一过程的关键。没有反向传播的高效梯度计算,训练一个百万参数的网络在计算上将完全不可行——暴力计算每个参数的梯度需要的时间会随参数数量呈平方增长,而反向传播将其降为线性增长。
当同龄人还在为"为什么要学这些数学"而困惑时,这位学生已经在学校课程中打好了基础。把学校的数学课当作机器学习的免费预备课程,是他最大的红利。
把Python从"会一点"提升到"能用"
提问者提到自己"知道一些Python,但不熟悉库和模块"。这是关键的下一步。Python之所以成为机器学习的事实标准语言,并非因为它的执行速度快(实际上Python是最慢的主流语言之一),而是因为它拥有无与伦比的库生态和极低的语法门槛。2024年Stack Overflow开发者调查显示,Python已连续多年位居最受欢迎语言榜首。在机器学习领域,从数据处理到模型训练再到部署,整个工作流都可以在Python生态内完成,这种端到端的便利性是R、Julia等竞争语言难以企及的。机器学习几乎完全依赖Python生态:
- NumPy:数值计算与数组运算,理解它就理解了向量化思维。向量化(Vectorization)是科学计算中的核心编程范式——传统的Python循环在处理大规模数据时极其缓慢,因为Python是解释型语言,每次循环都有显著的开销。NumPy通过将运算下沉到底层的C/Fortran代码,对整个数组一次性执行操作,速度可提升100倍以上。例如,计算两个含百万元素向量的点积,用Python循环可能需要数百毫秒,而NumPy只需不到1毫秒。学会"用矩阵运算代替循环"不仅是性能优化技巧,更是理解神经网络批量计算的思维基础;
- Pandas:数据处理与清洗,真实项目80%的时间花在这里。业界有句广为流传的话:数据科学家80%的时间花在数据准备上。真实世界的数据充满缺失值、异常值、格式不一致、重复记录等问题。Pandas提供了强大的数据操作能力——包括缺失值填充(fillna)、数据透视(pivot_table)、分组聚合(groupby)、合并连接(merge/join)等功能。一个机器学习模型的效果上限往往取决于数据质量而非算法选择,因此数据清洗能力是区分"能跑通教程"和"能解决真实问题"的关键分水岭;
- Matplotlib / Seaborn:数据可视化,帮助建立对数据的直觉。Matplotlib是Python中最基础的绑图库,灵活但语法相对繁琐;Seaborn则在Matplotlib基础上提供了更高层的统计图表接口,用一行代码就能生成热力图、箱线图、小提琴图等复杂可视化。在机器学习中,可视化不仅用于展示结果,更重要的是用于诊断——例如通过绘制学习曲线判断模型是过拟合还是欠拟合,通过混淆矩阵热力图分析分类错误的模式,通过特征分布直方图发现数据异常。培养"先画图再建模"的习惯,是优秀数据科学家的标志之一;
- Scikit-learn:经典机器学习算法的一站式工具箱,入门首选。Scikit-learn由David Cournapeau在2007年作为Google Summer of Code项目启动,现已成为最广泛使用的传统机器学习库。它的核心设计理念是统一的API接口——无论是线性回归、随机森林还是支持向量机,所有模型都遵循fit()→predict()的调用模式。这种一致性极大地降低了学习成本,使得初学者可以专注于理解算法本身而非纠结于不同的代码接口。Scikit-learn也刻意不包含深度学习功能,保持了库的精简和稳定。
建议不要孤立地"学库",而是在解决问题的过程中查文档、用起来。真正掌握一个库靠的是反复使用,而非通读教程。
推荐的机器学习学习资源路径
针对完全新手,资源过多反而是负担。这里给出一个从易到难的阶梯,避免"教程地狱"(不断收藏却从不动手)。"教程地狱"(Tutorial Hell)是编程学习社区中广泛讨论的现象,指学习者持续消费教程内容——不断观看视频、收藏博客、购买课程——却始终无法独立完成一个项目。其心理根源是对"准备不足"的恐惧:总觉得还需要再学一门课才能开始动手。打破这个循环的有效方法是"70%准备就开始做"——当你觉得自己大概理解了一个概念,就立刻尝试用代码实现它,遇到问题再回头查资料。这种"做中学"的模式虽然初期会频繁碰壁,但知识留存率远高于被动学习。认知科学中的"必要难度"(Desirable Difficulty)理论也支持这一点:适度的困难和犯错实际上强化了长期记忆的编码过程。
第一阶段:建立直觉(几个月)
- 3Blue1Brown 的线性代数与神经网络系列视频:3Blue1Brown是由Grant Sanderson创办的数学教育YouTube频道,以其精美的动画可视化著称。该频道使用自研的开源动画引擎Manim(Mathematical Animation Engine)来制作视频,能够将抽象的数学概念转化为直观的几何图像。其《线性代数的本质》系列用动画展示矩阵变换如何"扭曲"空间,让观众真正理解行列式、特征值的几何含义;《神经网络》系列则从零解释了前向传播、反向传播和梯度下降的完整数学过程。这种"先建立直觉、再处理公式"的教学理念,与传统教科书的路径截然不同,特别适合自学者。用可视化方式讲解矩阵、向量和神经网络,与在校学习的数学形成呼应,强烈推荐;
- Kaggle Learn 的免费微课程:Python、Pandas、机器学习入门模块短小精悍,边学边在浏览器里写代码。Kaggle Learn的每个微课程通常只需4-6小时即可完成,每节课都包含简短的理论讲解和嵌入式编程练习。这种"学5分钟、练5分钟"的紧凑节奏非常适合注意力有限的初学者,也与认知科学中"间隔练习"的高效学习原则相吻合;
- Andrew Ng 的《Machine Learning》课程(Coursera):经典中的经典,数学门槛适中,非常适合有数学基础的高中生。Andrew Ng(吴恩达)的这门课程最初于2011年在斯坦福大学开设,后搬上Coursera平台,成为在线教育史上最具影响力的课程之一,全球注册学习者超过500万。2022年,课程进行了重大更新,从Octave/MATLAB迁移到Python,并增加了深度学习基础内容。课程的核心优势在于吴恩达极强的化繁为简能力——他能将复杂的数学推导拆解为直觉级别的理解,同时保持足够的严谨性。对于具备A-Level数学水平的学生来说,课程中涉及的线性代数和微积分不会构成障碍,反而能看到这些数学工具在实际问题中的优雅应用。
第二阶段:动手实践(贯穿Year 12-13)
当基础概念清晰后,重心应转向实战。此时可以:
- 在 Kaggle 上参加入门级竞赛(如泰坦尼克号生存预测),从别人的公开笔记本中学习。Kaggle是全球最大的数据科学竞赛平台,2017年被Google收购。泰坦尼克号生存预测(Titanic: Machine Learning from Disaster)是Kaggle上最经典的入门竞赛,要求参赛者根据乘客的年龄、性别、船票等级等特征预测其在海难中的生存概率。这个竞赛之所以适合入门,是因为数据集小(仅891条训练记录)、特征含义直观、且有数千个公开的Notebook供学习参考。更重要的是,它涵盖了完整的机器学习工作流:探索性数据分析→特征工程→模型训练→预测提交→分数反馈,让新手在一个完整的闭环中体验整个过程。在这个竞赛中,真正拉开参赛者差距的往往不是模型选择,而是特征工程(Feature Engineering)——例如从乘客姓名中提取称谓(Mr、Mrs、Miss、Master等)可以间接编码年龄和社会地位信息,将船舱号的首字母提取出来可以反映甲板位置,将家庭成员数量组合成"是否独自旅行"的二元特征也能提升预测效果。特征工程本质上是将领域知识编码为模型可以利用的数值信号,这项能力高度依赖创造力和对数据的深入理解,至今仍是机器学习中最难自动化的环节之一;
- 阅读 Scikit-learn 官方文档中的示例,逐个复现;
- 尝试 fast.ai 的实践导向课程,它强调"先跑起来,再理解原理"。fast.ai由Jeremy Howard和Rachel Thomas创办,其核心教学哲学是"自顶向下"(top-down)学习法——先让学生在第一节课就跑通一个完整的深度学习模型(如图像分类器),获得成就感和全局视野,然后在后续课程中逐层剥开底层原理。这与传统学术界"先学三个月线性代数再碰模型"的路径完全相反。fast.ai同时开发了同名的Python库,对PyTorch进行了高层封装,使得用几行代码就能训练出效果不错的模型。这种方法特别适合已经有一定编程基础、想快速获得实践体验的学习者。Jeremy Howard本人曾是Kaggle全球排名第一的竞赛选手,他的实战经验使得fast.ai课程中充满了"教科书不会告诉你"的工程技巧。
与数学结合的机器学习项目建议
提问者特别希望找到与数学有交集的项目。这是个绝佳的方向,因为把课堂数学"翻译"成代码,能同时加深对两者的理解。以下是几个难度适中、可持续推进的项目思路:
1. 从零实现线性回归
不用任何机器学习库,仅用NumPy,自己写出梯度下降来拟合一条直线。这个项目直接连接了微积分(求导)、线性代数(矩阵运算)和编程。当你亲手推导并实现损失函数的梯度时,机器学习就不再是黑盒。
线性回归虽然是最简单的模型之一,但它包含了机器学习的所有核心要素:假设函数、损失函数、优化算法和模型评估。损失函数(Loss Function)衡量的是模型预测值与真实值之间的"差距"——对于线性回归,最常用的是均方误差(MSE),即所有预测偏差的平方和的均值。选择平方而非绝对值作为度量,不仅因为平方函数处处可导(有利于梯度下降),还因为它对大偏差的惩罚更重——一个偏差为10的预测比10个偏差为1的预测在MSE下"严重"得多。从零实现的过程中,你会深刻体会到学习率选择对收敛速度的影响——学习率太大导致震荡发散,太小则收敛缓慢,这种对超参数的直觉在后续学习更复杂模型时极为宝贵。建议实现完毕后,尝试将其扩展到多元线性回归(多个输入特征),此时你会真切感受到线性代数中矩阵求逆和矩阵乘法的实际用途。
2. 概率与统计的可视化探索
用真实数据集(如天气、体育、经济数据)做探索性分析:计算相关系数、绘制分布图、验证中心极限定理。这与A-Level统计课程高度重叠,还能锻炼数据处理能力。
中心极限定理是统计学中最优美的结论之一——无论原始数据的分布形状如何(可以是极度偏斜的、有多个峰的、甚至是离散的),只要样本量足够大,样本均值的分布就会趋向正态分布。用Python模拟这个过程(从均匀分布、指数分布等不同分布中反复抽样并计算均值),亲眼看到直方图逐渐变成钟形曲线,是一种令人印象深刻的学习体验。这个定理在机器学习中有着深远的实际意义——它是许多统计检验方法的理论基础,也解释了为什么正态分布假设在大样本情况下往往"够用"。进一步地,你可以探索相关系数(Pearson r)与因果关系的区别——"相关不等于因果"是数据科学中最重要的思维警醒之一。例如冰淇淋销量和溺水事件高度正相关,但显然吃冰淇淋不会导致溺水,真正的共同原因是高温天气。
3. 用物理数据做预测
结合物理背景,收集或模拟一组物理实验数据(如单摆周期、抛体运动),用机器学习模型去拟合规律,再与理论公式对比。这种跨学科项目在大学申请中也很有说服力。
例如,你可以用传感器(如手机的加速度传感器或Arduino套件)采集单摆运动数据,让机器学习模型自动"发现"周期T与摆长L的平方根关系(T ∝ √L),然后与物理课上推导的理论公式进行对比。这种"让数据说话"与"从原理推导"两种认知路径的交汇,正是科学研究的魅力所在。更进一步,你可以故意引入物理理论忽略的因素(如空气阻力、摆角过大时的非线性效应),观察机器学习模型能否捕捉到这些偏差。这类项目还可以延伸到"符号回归"(Symbolic Regression)这一前沿方向——让算法不仅拟合数据,还自动发现简洁的数学公式,这与物理学追求"最简优美定律"的精神高度一致。
4. 手写数字识别(MNIST)
这是机器学习的"Hello World"。MNIST(Modified National Institute of Standards and Technology)数据集由Yann LeCun等人于1998年整理发布,包含70,000张28×28像素的手写数字灰度图像(60,000张训练集、10,000张测试集)。它在机器学习领域的地位相当于编程中的"Hello World"——几乎每一本深度学习教材都以它作为第一个实战案例。虽然现代模型在MNIST上已经能达到99.8%以上的准确率,但它仍然是理解图像分类流程(像素输入→特征提取→分类输出)的最佳教学工具。Yann LeCun本人也因在卷积神经网络(CNN)方面的开创性工作,与Geoffrey Hinton、Yoshua Bengio共同获得了2018年图灵奖(被誉为"计算机领域的诺贝尔奖")。
可以先用Scikit-learn快速实现,再进阶到用简单神经网络。它能让你直观感受到从数据到模型再到预测的完整流程。进阶学习者通常会转向更具挑战性的Fashion-MNIST(将数字替换为衣物图片)或CIFAR-10(包含飞机、汽车、鸟等10类32×32彩色图像)数据集。从MNIST到ImageNet(1400万张图片、2万多个类别)的跨越,标志着从"玩具问题"到"真实世界挑战"的质变——2012年AlexNet在ImageNet竞赛上以深度卷积神经网络大幅击败传统方法,开启了深度学习时代;2015年ResNet引入残差连接,使得训练超过100层的网络成为可能;2020年后Vision Transformer(ViT)又证明了不使用卷积、仅靠注意力机制也能在图像任务上达到顶尖水平。理解这条演进线索有助于初学者建立全局视野——MNIST是起点,但远不是终点。
给年轻学习者的几点实用建议
结合社区经验,最后给出几条超越具体资源的忠告:
第一,重实践轻收藏。 初学者最容易陷入"收集资源却不动手"的陷阱。宁可只用一门课,也要把里面的每个练习做完。认知心理学中的"生成效应"(Generation Effect)表明,主动生成答案(即使生成的是错误答案)比被动阅读正确答案能产生更深的记忆编码。换言之,自己挣扎着写出一段有bug的代码,然后调试修复,比看完一段完美的示例代码学到的东西要多得多。
第二,用项目驱动学习。 与其被动看完一整门课,不如带着一个想解决的问题去学——需要什么就学什么,记忆和理解都会更牢固。这种"问题导向学习"(Problem-Based Learning)最早由加拿大McMaster大学医学院在1960年代提出,后来被广泛应用于工程和计算机教育中。其核心逻辑是:当你有一个具体的、你关心的问题要解决时,学习动机和知识吸收效率都会大幅提升。
第三,善用免费生态。 Kaggle、Google Colab(免费GPU)、GitHub 都是零成本的强大工具。Google Colaboratory(简称Colab)是Google提供的免费云端Jupyter Notebook环境,用户无需在本地安装任何软件,只需一个浏览器和Google账号即可开始编写和执行Python代码。Colab免费提供GPU(通常是Tesla T4)和TPU计算资源,这对于深度学习训练来说极为宝贵——一块T4 GPU在市场上的单价约2500美元。Colab还与Google Drive无缝集成,方便保存和分享代码。对于新手来说,Colab最大的价值在于消除了"环境配置"这个最常见的入门障碍——许多初学者还没写第一行机器学习代码就被Python版本冲突、CUDA安装、包依赖地狱等问题劝退。在Colab上写代码无需配置本地环境,非常适合新手。此外,GitHub不仅是代码托管平台,更是学习的宝库——搜索"machine learning from scratch"可以找到大量从零实现经典算法的开源项目,阅读别人的代码是提升编程能力最快的途径之一。
第四,不必急于求成。 从Year 12到Year 13有近两年时间,稳步推进即可。机器学习是一场马拉松,扎实的数学与编程基础远比追逐最新的模型热点重要。当前AI领域的技术更新速度极快——从GPT到Diffusion Model到多模态大模型,新概念层出不穷——但所有这些前沿技术的底层仍然是线性代数、概率论、优化理论和基本的编程能力。打牢这些基础,你在面对任何新技术时都能快速理解其原理,而不是只会调用API而无法深入。
对于一个16岁、拥有数学天赋和明确兴趣的学生来说,现在开始已经是绝佳时机。保持好奇、坚持动手,两年后回望,积累将远超想象。
核心要点
核心要点
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。