18个模型跑113个编程任务:智能路由能把解题率拉到97.6%

18模型实测显示智能路由可使编程解题率达97.6%、成本降至1.88美元,远超最强单模型。
一项针对18个AI模型在DeepSWE基准上的编程能力实测发现,若为每个任务动态分配最优模型,理论解题率可达97.6%,单任务成本仅1.88美元;而表现最好的单一模型解题率仅74.1%,成本却高达6.52美元。这组数据表明「追求单一最强模型」是一种资源浪费策略,因为不同编程任务对模型能力的诉求差异极大,没有任何模型能在所有维度上保持最优。研究团队据此提出下一个技术前沿是「智能路由器」——一种能在任务到达时自动判断其性质并调度给最适合模型的系统,但其落地需解决任务分类准确性、预测偏差和调度延迟等现实工程挑战。
一次针对18个模型的编程能力实测
一个技术团队在 DeepSWE 基准上做了一次颇具启发性的实验:他们让 18 个不同的模型去处理 113 个真实的编程任务,然后回过头来问了一个简单却关键的问题——如果每个任务都被分配给最擅长它的那个模型,结果会怎样?
答案相当惊人:这种理想化的「任务-模型最优匹配」能达到 97.6% 的解题率,每个任务成本仅 1.88 美元。而作为对照,单打独斗表现最好的那个模型,解题率只有 74.1%,每任务成本却高达 6.52 美元。
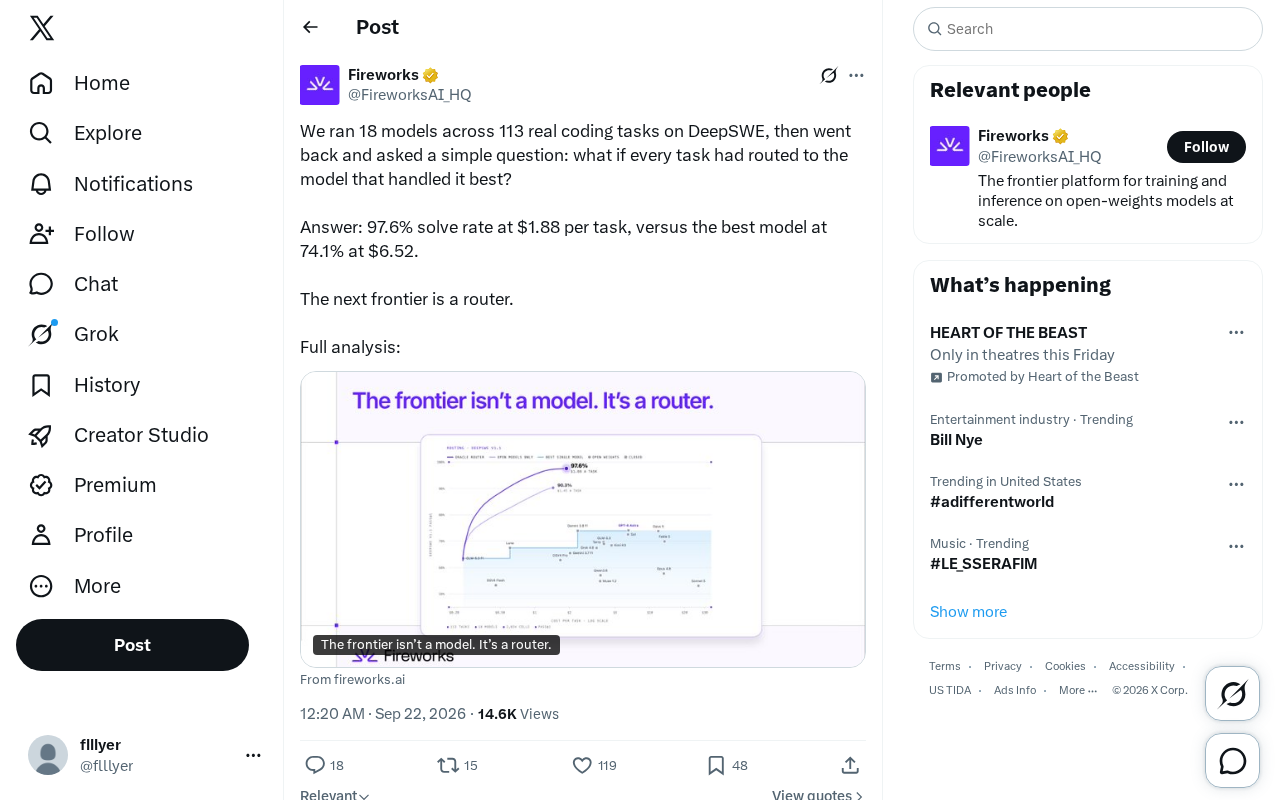
换句话说,通过为不同任务挑选合适的模型,团队不仅把解题率提升了超过 23 个百分点,还把单任务成本压到了原来的不到三分之一。这组数据揭示了一个被很多人忽略的事实:没有哪一个模型能在所有编程任务上都是最优解。
为什么「单模型最优」是个伪命题
当前行业普遍在追逐「最强模型」这一目标,仿佛只要找到那个综合评分最高的模型,就能一劳永逸地解决所有问题。但这次实验的数据给出了不同的视角。
表现最好的单个模型解题率仅 74.1%,意味着即便是「最强」,也有超过四分之一的任务无法完成。而不同任务对模型能力的诉求差异极大——有的任务需要长上下文理解,有的需要复杂的逻辑推理,有的则更看重代码生成的准确性与速度。任何单一模型都会在某些维度上存在短板。
更值得关注的是成本维度。最强模型往往也是最贵的,用它来处理所有任务,等于用杀鸡的刀去杀牛,也用杀牛的刀去杀鸡。实验中 6.52 美元 vs 1.88 美元的成本差距,正是这种「一刀切」策略造成的资源浪费的直接体现。
DeepSWE是专门面向软件工程(Software Engineering)场景的代码能力评测基准,其任务来源于真实的GitHub Issue修复场景,要求模型不仅能生成代码片段,还需理解代码库上下文、定位Bug、提交可运行的补丁。相比HumanEval等以单函数补全为主的经典基准,DeepSWE的任务更贴近开发者日常工作,也更能暴露模型在长上下文推理、多文件协作和测试验证等方面的差异。正因为任务本身的多样性和复杂性,不同模型之间的能力分化才会如此显著,使得「为每个任务选最优模型」的收益远高于单一代码生成类基准上的预期。
下一个前沿:智能路由器
这次分析给出的核心结论是明确的——下一个技术前沿是路由器(router)。
所谓路由器,就是一个能够在任务到达时判断其性质,并将其自动分配给最适合、性价比最高的模型的调度系统。它不是要造出一个更强的单体模型,而是把已有的多个模型组织成一个协同的整体,让每个模型都发挥自己最擅长的部分。
从实验数据看,理想路由所能带来的收益是巨大的:解题率逼近 98%,成本却大幅下降。当然,实验中的 97.6% 是一种「事后诸葛亮」式的理论上限——它假设我们总能预先知道哪个模型最擅长某个任务。现实中的路由器需要在任务执行前就做出准确判断,这本身就是一个极具挑战的问题。
路由器面临的现实挑战
把理想上限转化为实际系统,至少要解决几个难题:
- 任务分类的准确性:路由器需要在不实际运行任务的情况下,判断任务的难度和类型,进而预测哪个模型表现最佳。
- 预测与真实表现的差距:97.6% 是最优匹配下的天花板,实际路由决策必然存在误判,真实收益会打折扣。
- 成本与延迟的平衡:路由决策本身也需要计算开销,如何在不显著增加延迟的前提下做出好的调度,是工程上的关键。
路由器的概念并非全新——在传统软件架构中,负载均衡器(Load Balancer)和API网关早已承担类似的流量分发职责。但AI路由器面临的挑战截然不同:传统路由基于CPU占用率、响应时间等可量化的硬件指标做决策,而AI路由器必须理解任务的「语义性质」,例如这个任务是算法推理题还是代码补全题?是否涉及长上下文?输出是否需要极高精度?目前业界已出现若干早期实践,例如用小型分类模型对输入进行预判(Meta的RouteLLM、Martian等),或基于历史执行数据训练路由策略。但这些方案普遍面临冷启动问题:在没有足够历史数据的情况下,路由器本身的判断质量有限。
对开发者与团队的启示
这组数据对正在构建 AI 编程工具或 Agent 系统的团队有直接的参考价值。与其把所有预算押在单一的顶级模型上,不如考虑构建一个多模型协同的架构,用相对轻量的路由策略来分配任务。
从投入产出角度看,路由方案的吸引力在于它同时优化了两个通常相互矛盾的目标——质量和成本。传统认知里,想要更高的解题率往往意味着更高的开销,但这次实验表明,合理的路由能让二者兼得。
需要提醒的是,这份分析基于 DeepSWE 基准上的 113 个任务,样本规模有限,结论的普适性还需要更大范围的验证。但它所指出的方向——从「追求单一最强模型」转向「构建多模型智能调度系统」——很可能是 AI 编程领域接下来的重要演进路径。完整分析已由原团队公开,感兴趣的开发者可进一步查阅。
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。