18小时三连发:Strata让12GB显卡跑起DeepSeek V4.1 Flash
Strata 18 小时连发三版,让 12GB 显卡跑起 DeepSeek V4.1 Flash。
开源项目 Strata 在 18 小时内从 0.2.3 迭代到 0.2.4,核心亮点是让一张 12GB 家用显卡加 46GB 内存跑起 DeepSeek V4.1 Flash。三个版本节奏分明:0.2.3 专注工程优化,工具调用提速约 19%,上下文峰值占用从 83% 降到 61%,并正式支持 Intel Arc 的 SYCL 后端;0.2.3.1 在 21 小时内修复了安装程序按单字符读取显卡支持表导致 Windows CUDA 包崩溃的问题;0.2.4 通过内存当显存、跳过冗余计算、投机解码三条手段实现低显存运行。文章还指出速度不取决于显卡价格,瓶颈在 CPU、内存配比与 SSD,并给出按用户类型的升级建议。
本地跑大模型的门槛,很多时候不在模型本身,而在那些没人愿意写的琐碎工程里。开源项目 Strata 在 18 小时内连发三个版本,从 0.2.3 到 0.2.4,把「一张 12GB 家用显卡跑起 DeepSeek V4.1 Flash」从口号变成了可复现的安装步骤。这条更新线没有跑分大战,却把发烧友、装不上的人和想跑前沿模型的人各自的痛点逐个拆开。
三个版本,三种节奏
先把版本关系理清楚:0.2.3 是打磨,0.2.3.1 是堵漏,0.2.4 是换血。据 B 站 UP 主的拆解,这 18 小时里最值得注意的细节是引擎包从 0.2.3 到 0.2.4 一直是 0.1.18,一个字节都没变,真正升级的是外层的 Control 层。
这种应用层与引擎层的干净切分,是它敢在稳定引擎上叠加一个新模型家族的前提。引擎稳住,新特性才有地方落。
引擎包与 Control 层的分层设计
Strata 的架构大致分为两层:底层是负责实际推理的引擎包(engine package),上层是处理安装、更新、配置、UI 和硬件检测的 Control 层。二者独立版本化,意味着引擎可以在长时间内保持字节不变,而应用层持续迭代新功能。这种切分的好处是:稳定的推理核心不因上层改动而引入回归风险,新模型家族、新硬件的适配可以叠加在已验证的引擎之上。文中"引擎包从 0.2.3 到 0.2.4 一直是 0.1.18"正是这一设计的直接体现,也是理解后续所有版本变化的前提。
0.2.3:没有新模型,全在还工程债
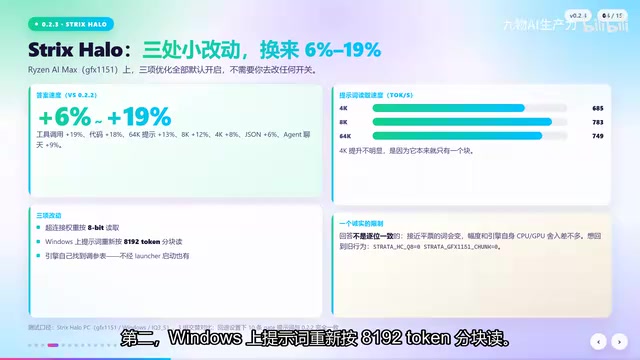
这一版没有任何新模型,评价可以是「该快的地方快了,该稳的地方稳了」。两个数字值得记:Strix Halo 上工具调用快了约 19%;上下文塞满时峰值占用从 8x3 压到 6x1,相当于 83% 到 61% 的改善。
19% 来自三件默认开启的事:超连接权重改为按 8bit 读取;Windows 上提示词重新按 8192 token 分块;引擎能自己找到调参表——即使不经过 launcher 直接启动引擎,性能也不掉。这背后是一种态度:不给用户埋一个「必须从正门进」的坑。代价也要说清楚,回答不是逐位一致的,接近评票的词会变,幅度与引擎自身的舍入相当,想退回旧行为两个环境变量就够。
Intel Arc 的意义不在性能,而在线路。英伟达、AMD、苹果之后加上 Intel 的 SYCL,四条后端线第一次都有了正式命名的引擎包。以前 Arc 是「你可以自己试试」,现在启动和更新会自动拉取、自动验签。官方也把边界写明白:这是 Linux 专属,真机只跑了 A750,B 系列放行但没实测。一个项目敢在发布说明里写「这张卡我们没跑过」,反而更容易让人相信它跑过的那些数字。
D-Flash2 这一块讲的是克制力。投机解码多了一条新路,但默认仍是 MTP,因为官方自己说还没有哪张卡证明它全面更快,只有终端里点名才启用。一个新特性在没有把握之前不给默认值,对比那些新功能默认全开、出事再说的产品,这个选择很值钱。
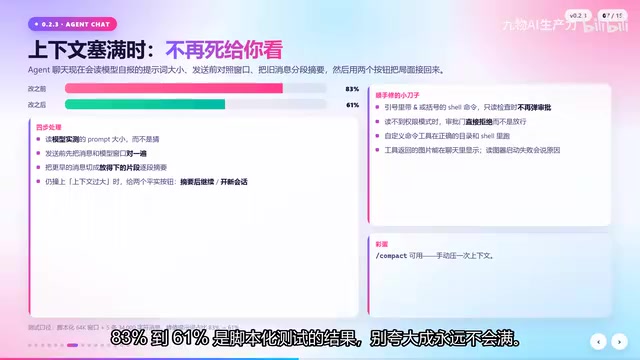
上下文管理被当成产品来修:读模型自曝的提示词大小、发送前对照窗口、把旧消息切断摘要,最后给两个按钮——摘要后继续,或者开心绘画。88% 到 61% 是脚本化测试的结果,别夸大成永远不会满,真正值得讲的是那两个按钮,把人从「重开一遍」里捞了出来。
还有两件看不见的事。证书方面,公司网、学校网后面下载不再报证书错误,统一信任操作系统自己的证书校验,失败也给人话而不是一堆堆栈。默认值方面,RTX 5070 上答案速度从 31% 到 45% tok/s,用户什么都没调,靠的是 5 个 CPU worker 加保留 1536MB 显存。绘画缓存按空闲内存自算大小,上限 8GB;两个 agent 共用一个模型时提示词复用 91%,追问从 11 秒变成 3 秒。体感上最明显的从来不是首答,是追问。
多后端与 SYCL
CUDA、HIP、Metal、SYCL 分别对应英伟达、AMD、苹果和 Intel 四家 GPU 的计算接口。SYCL 是跨平台的开放标准,Intel Arc 显卡通过它接入推理引擎。此前 Arc 用户需要自行编译或手动配置,属于"可以试试"的状态;0.2.3 起 Strata 为 SYCL 提供正式命名的引擎包,支持自动拉取和签名校验,把非主流硬件从实验性支持提升为可维护的发布线路。官方同时注明仅 Linux、真机只验证了 A750,这种对测试边界的坦白,是判断一个项目可信度的重要信号。
0.2.3.1:一个字符引发的装不上
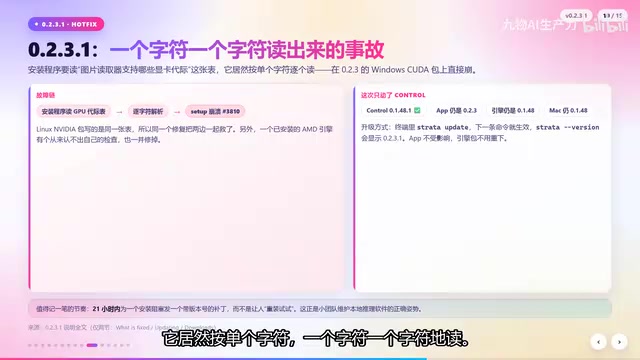
这一版值得单独讲,因为它是个故事。安装程序要读一张表,内容是图片读取器支持哪些显卡代号,它居然按单个字符一个字符地读。在 0.2.3 的 Windows CUDA 包上读到一半崩了,装不上,一切归零。Linux 包写的是同一张表,所以一个修复救了两遍。21 小时后就发了 0.2.3.1,只动 Control、App 和引擎包,一个都没碰。重点不是这个 bug 有多蠢,是响应有多快、补丁有多准。
0.2.4:12GB 显卡跑起 DeepSeek V4.1 Flash
门槛先说清楚:磁盘 239–274GB,内存 46GB 起,显卡 12GB 起。量化选择上,IQ1M 省 18GB 但英文散文明显偏弱;IQ2XS 贵 17GB,困惑度从 15.5% 收到 7.3%,写代码、跑 agent 直接上 IQ2XS。提醒一句:桌面 App 还是 0.2.3,DeepSeek广告 目前只在终端里,别装完了在桌面版里找不到它。
它凭什么能跑?三条工程手段。第一条,内存当显存用:模型是混合专家,每个 token 只用到几千个小块里的几个,那就把最常用的藏进内存,其余的从 SSD 直接读。第二条,少算没用的:跳过最后 20 层用不到的计算,16K 提示块大约省 34%,而 799 个位置里 99.5% 的首选词没变,省掉的是白算的力气。第三条,小模型帮忙猜:一次猜对就能出好几个词,但它在 CPU 是瓶颈的机器上反而拖后腿,所以默认关闭。三条合起来,才解释得通。
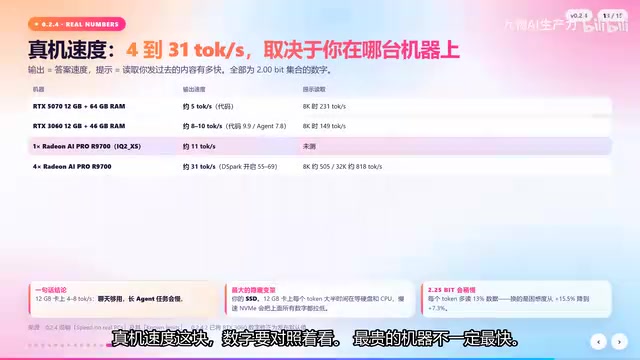
速度这块数字要对照着看,最贵的机器不一定最快。RTX 5070 是 5 tok/s,RTX 3060 反而是 8 到 10,差在 CPU 和内存的配比而不在显卡本身。想快得上多卡,4 张 R9700-31K 的 DSpark 是 55–69 tok/s。还有一句实话:12GB 卡上是 4 到 8 tok/s,上 agent 任务会慢。隐藏变量是你的 SSD,12GB 卡上每个 token 大半时间在等硬盘和 CPU,慢速 NVMe 会把上面所有数字一起拉低。
发布后两天又补了两刀:0.2.4 的终端包少了 DeepSeek 准备脚本,setup 卡在 Preparing your model,0.2.4.1 当天修掉;0.2.4.2 再收一串——使用已有模型文件时会把下载好的 UD-Q8-K-XL 判成不可读;引擎自更新签名 Feed 有新包时下次 launch 自动下载校验,四起切换三旧失败只包一行、旧引擎继续跑。还有两条减法值得夸:DeepSeek 启动不再顺手下一堆用不上的东西,Install S 出错不再关掉你的终端。
混合专家(MoE)与量化等级
混合专家(Mixture of Experts, MoE)是 DeepSeek 系列采用的核心架构:模型内部包含大量并行的"专家"子网络,但每个 token 只激活其中极少数几个,因此推理时的实际计算量和显存占用远低于参数总量。Strata 正是利用这一稀疏性,把极少用到的专家权重放在内存甚至 SSD 上,只把高频专家常驻显存。需要注意的是,MoE 的"激活参数少"并不等于"显存需求小"——全部专家权重仍需存储,这正是磁盘需求高达 239–274GB 的原因。
文中提到的 IQ1M、IQ2XS 属于 GGUF 格式下的 K-quant / I-quant 量化等级,数字越小压缩越狠、精度损失越大。困惑度(perplexity)是衡量语言模型预测能力的内置指标,数值越低越好;从 15.5% 降到 7.3% 意味着文本生成的连贯性和准确性有明显提升,对写代码、跑 agent 这类需要精确输出的任务尤其关键。
投机解码的工作机制
投机解码(speculative decoding)是一种用"小模型猜、大模型验"来加速生成的技巧:一个轻量草稿模型先快速预测接下来若干个 token,再由主模型一次性并行验证这些候选。若猜对,就能在原本只够生成一个词的时间里输出好几个词;若猜错,则退回到逐个生成。它的收益高度依赖草稿模型的命中率和硬件条件——在 CPU 是瓶颈的机器上,草稿模型本身的开销会抵消甚至超过节省的时间,所以 Strata 在 0.2.4 中将其默认关闭,只在终端里点名启用。D-Flash2 是 Strata 对这一机制的另一条实现路径,但因尚无显卡被证明全面更快,同样保持默认关闭。
三个判断与按人建议
算力被拆到了整台电脑:显存不够借内存,内存不够借 SSD。硬件支持变成了有名字的包:CUDA、HIP、Metal、SYCL 各自可校验、可自更新。失败路径也算产品:端口占用、找不到分片、上下文过大、GitHub 连不上,每一条都给了原因和下一步。
按人给建议:终端用户直接 update;0.2.0 Beta 的要重跑一次安装命令;想试 DeepSeek 先对一下显存、内存、硬盘;AMD 老平台一定要升到 0.2.4.2,否则慢三倍;IP 用户 0.2.4.2 该升。0.2.3 值得升,那是实打实的 31 到 45;0.2.3.1 只修安装,但它是装不装得上的问题。
本地 AI 真正的门槛,从来不是模型,是这些没人愿意写的琐碎。Strata 这 18 小时,把琐碎做成了产品。
相关推荐
多AI代理协作冲突终结者:Git工作树实战指南
多个AI编程代理共享仓库时互相覆盖?Git工作树是根本解决方案。本文解析Claude Code、Claude Squad、Conductor、Vibe Kanban等工具的隔离机制与取舍,并给出选型建议。
Cognition开源Devin漏洞修复插件,AI编程代理效率与成本新研究
Cognition 开源 Devin 漏洞修复插件,覆盖 PHP、Node.js、GitLab;研究揭示编码代理工具复杂度与成功率脱钩、成本翻三倍;Microsoft Agent Grid 支持 1024 代理无中心协调;Entropic 发布无容器沙箱;Python 3.15 新增采样分析器。
AI Agent自己买服务器:MCP与VPS的自动化革命
探索AI Agent通过MCP协议自主购买VPS服务器的完整流程:从ClaudeCode连接EQVPS、加密货币预付费充值,到Agent自主下单、监控服务器并在破坏性操作前请示用户。分析Agent经济的支付底座与安全边界。