20款AI编程工具硬核实测:Cursor与Codex登顶,Trae们为何翻车?
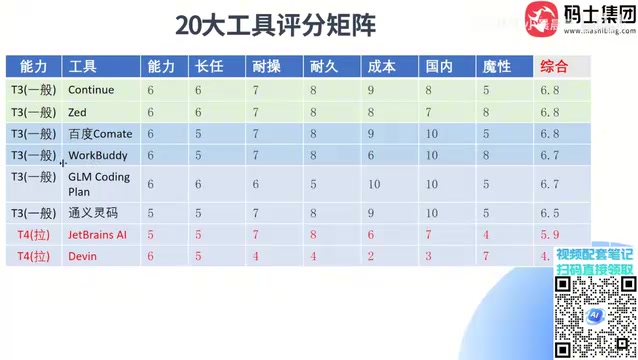
七维评分矩阵对20款AI编程工具排名,Claude Code与Codex并列T0。
文章介绍了一位B站UP主用七维加权评分矩阵对20款主流AI编程工具进行排名。评分维度包括能力(30%)、常任可靠性(20%)、耐操性(15%)、耐久性(10%)、成本可控(10%)、国内可用(10%)和模型体验(5%)。结果显示,Claude Code和Codex以8.4分并列T0“夯”级,在能力和长任务可靠性上接近满分;Cursor和Gemini分列T1准顶级;T2梯队包括Kimi、通义灵码等日常可用工具;T3为一般档;T4仅两款不推荐。文章指出没有全能选手,并强调该框架可帮助开发者根据场景选择工具。
AI编程工具市场正以肉眼可见的速度膨胀,但究竟哪些工具能真正扛起生产环境的重担?一位B站UP主用一套七维评分矩阵,对20款主流AI编程工具进行了从“夯”到“拉”的硬核排名。这份榜单不仅给出了结论,更暴露了当前AI编程工具的核心分化逻辑——有些工具在解决复杂工程问题上已经逼近人类工程师,而另一些则仍在特定场景里打转。
评分框架:七个维度决定工具生死
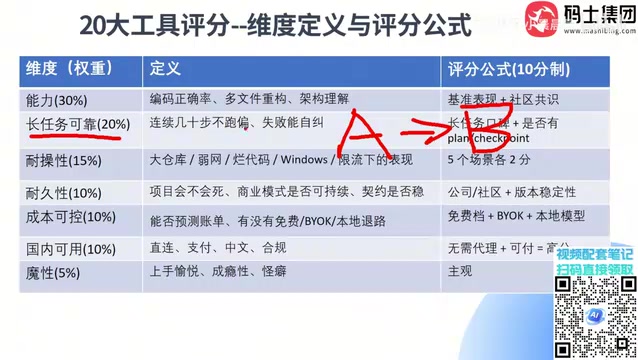
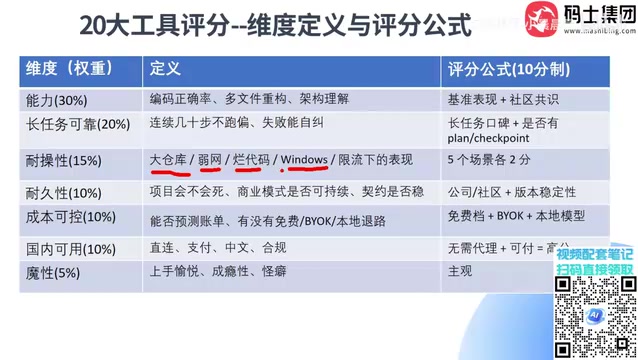
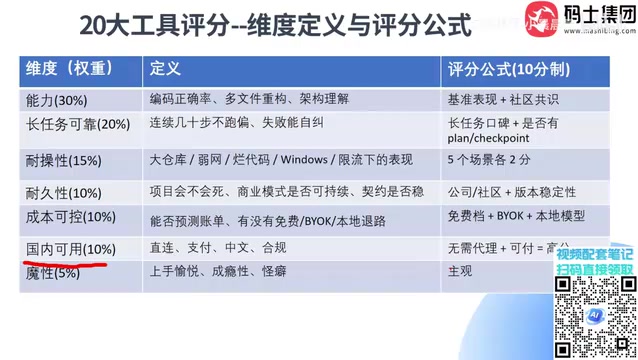
这份榜单的评分体系并非拍脑袋决定,而是基于七个加权维度:能力(30%)、常任可靠性(20%)、耐操性(15%)、耐久性(10%)、成本可控(10%)、国内可用(10%)、模型体验(5%)。每个维度都有明确的定义和评分依据,试图还原工具在真实开发场景中的综合表现。
能力:代码硬实力的直接检验
能力维度权重最高,占30%,核心考察编码正确率、多文件重构能力和架构理解力。评分依据包括公开基准测试成绩和社区共识——如果缺乏公开成绩,很难拿到高分。这意味着,一个工具能否正确理解项目原有结构、在同时修改多个文件时不乱阵脚,是区分优劣的第一道门槛。
常任可靠性:长任务会不会跑偏
常任可靠性(20%)关注的是AI在连续几十步任务中的表现。例如,将一个老代码从A框架迁移到B框架并跑通所有测试,这种场景下工具是否会中途“跑偏”(行业黑话,指越做越偏离目标)、出错后能否自我发现并纠正。评分时主要看社区口碑,以及工具源码中是否设计了计划检查机制(如checkpoint)。
在AI编程语境中,“跑偏”通常指智能体在执行多步骤任务时逐渐偏离原始目标,例如在重构过程中引入无关修改、陷入循环调试或遗忘早期约束条件。为缓解这一问题,现代工具常引入“检查点(checkpoint)”机制:在关键步骤后保存状态并回顾计划,使模型能够自我校验或回滚。这一设计借鉴了强化学习中的信用分配思想,即通过中间奖励信号引导长序列决策,从而提升任务完成率。
耐操性:极端工程环境下的生存能力
耐操性(15%)模拟了五种恶劣场景:十万行以上的大仓库、弱网或断线环境、历史遗留烂代码、Windows路径兼容性、API限流。评分时取五个场景中表现最好的两个,因为很难要求一个工具面面俱到。这一维度直指工程实践中的痛点——在国内开发环境下,Windows兼容性和网络稳定性往往是工具能否落地的关键。
耐久性与成本:工具背后的可持续性
耐久性(10%)评估工具背后的公司或开源团队是否会倒闭、商业模式是否可持续、版本稳定性如何。大公司如微软、谷歌在这方面天然占优。成本可控(10%)则考察是否有免费额度、是否支持BYOK(自带模型密钥)、能否加载本地模型——这直接关系到长期使用的边际成本。
BYOK(Bring Your Own Key)是一种允许用户使用自己的大模型API密钥接入工具的模式。其核心价值在于解耦工具与模型供应商:用户可自由选择性价比更高的模型,避免被绑定在单一服务上,同时便于企业进行成本核算与合规管理。对于需要长期高频使用的开发者,BYOK结合本地模型加载能力,能显著降低边际成本并减少网络依赖,是评估工具可持续性的重要指标。
国内可用与模型体验:本土化的硬门槛
国内可用(10%)从四个维度判断:是否需要代理、付费是否方便、中文场景表现、企业合规性。代理不仅增加费用,还伴随封号风险,代码上传至境外服务器更是企业合规的红线。模型体验(5%)则高度主观,考察上手愉悦度、用户粘性甚至“怪癖”,是唯一允许感性打分的维度。
企业合规性在AI编程工具选型中常涉及数据出境与代码安全。将源代码上传至境外服务器可能违反《数据安全法》或行业监管要求,尤其对金融、政务等敏感领域构成红线。因此,国内可用性不仅关乎网络延迟,更涉及法律风险。工具若支持私有化部署或境内节点,则能有效规避此类问题,这也是本土化评估中权重较高的原因。
T0梯队:Claude Code与Codex并列夯级
综合评分最高的T0级别被命名为“夯”,仅有Claude Code和Codex两款工具入选,综合评分均为8.4分,未分出高下。它们的共同特点是:能力和常任可靠性接近满分(部分子项接近10分),意味着在编码正确率和长任务可靠性上已经达到生产环境直接使用的水平。两者在耐操性、耐久性上也有不错表现,尽管成本可控和国内可用并非其强项。
这一结果与社区共识基本吻合——Claude Code和Codex在复杂重构和长链路任务中的口碑一直领先,但高昂的使用成本和网络门槛也让不少国内开发者望而却步。
生产环境直接使用AI编程工具通常意味着工具需具备高代码正确率、可预测的行为以及错误恢复能力。在业界,这常以“人类工程师可审核”为标准:AI生成的代码应通过既有测试套件,且修改范围可控。长任务可靠性则要求工具在数十步交互中保持上下文一致性,避免累积误差。达到这一水平的工具可显著降低人工复核负担,但现阶段仍建议保留代码审查环节。
T1准顶级:Cursor与Gemini紧随其后
Cursor(7.8分)和Gemini(7.5分)构成“准顶级”梯队,意为“能够在生产上使用,但与夯级存在差距”。Cursor的用户粘性在所有工具中最高,模型体验评分突出,但在常任可靠性和耐操性上略逊于T0。Gemini则凭借谷歌的耐久性优势和均衡表现入围。两者的差距主要体现在能力维度的细分项上——多文件重构和架构理解仍不及Claude Code和Codex稳定。
T2主力与T3一般:日常可用但缺核心竞争力
T2梯队被称为“主力环节”,评分大多在7分左右,包括Kimi、Kling、通义灵码(原文提到的“签问”应为通义千问广告)、OpenCloudTrain、Copilot(原文“CoupleLauter”)、Adder、DeepSeek广告 Harness等。这些工具日常使用基本够用,但在能力或常任可靠性上总缺少一项核心竞争力,导致无法跻身顶级。
T3梯队则被定义为“一般般,用起来总有些或多或少问题”,包括Continue、Zed、百度的Comet、WorkBody以及GLM(同义零码)。其中WorkBody近期热度较高,但由于其定位偏向AI办公文档和协同,而非专业编程,在编程类评分中得分不高。
T4拉档:仅两款工具被判不推荐
最底部的T4“拉”档仅收录两款工具(原文未具体点名),UP主表示若榜单扩展到30或40款,拉档可以列出10个甚至更多。这一档的工具基本不推荐用于任何生产场景。
评分背后的洞察:没有全能选手
从加权矩阵可以看出,没有一款工具在所有维度上都拿高分。Claude Code和Codex赢在能力与可靠性,但成本和国内可用性拖了后腿;Cursor赢在模型体验和用户粘性,但工程硬实力稍逊;国内工具如通义灵码、DeepSeek Harness在国内可用和成本上优势明显,但能力和耐久性仍需追赶。
这份榜单的价值不在于排名本身,而在于提供了一个可复用的评估框架。开发者可以根据自身场景——是追求极限重构能力,还是优先考虑合规与成本——在矩阵中找到最适合自己的工具。后续UP主还将对每款工具进行详细拆解,值得持续关注。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。