20亿参数能看图!千问3.5跑进RK3588本地部署实测

千问3.5 2B版在RK3588上跑通本地文字与图片问答,并可通过网页交互。
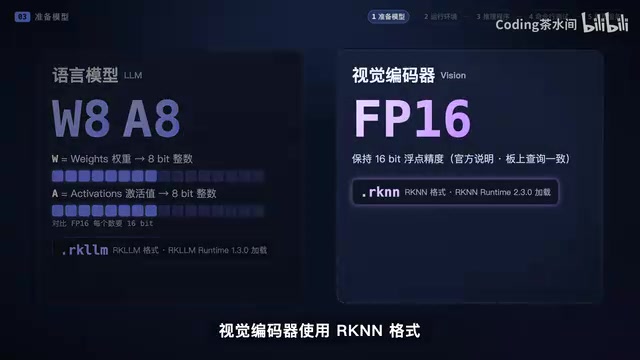
文章完整记录了千问3.5 2B版本在RK3588嵌入式开发板上的部署与实测过程。工程需要两个模型文件:语言模型采用RKLLM格式的W8A8量化版本,视觉编码器使用RKNN格式。整体流程从模型准备、运行环境配置,到基于Q-engineering开源代码补全网页服务、模型常驻和流式输出,再逐步验证命令行文字问答、图片问答和网页交互。实测数据显示,模型常驻后纯文本约0.38秒开始输出,短回答0.7至1.4秒完成;图片问答因需先经过视觉编码,约4.2秒开始输出,整次约5.5秒完成。作者强调分步验证的调试策略,并指出模型能启动只是部署成功的第一步。
把一个大模型塞进一块嵌入式开发板,还能识别图片、用网页聊天,这件事听起来有点赛博,但确实已经跑通了。B站有UP主完整演示了千问3.5的2B版本在RK3588上的部署与实测过程,从模型准备到网页问答全部走了一遍。
为什么20亿参数还要分两条推理路线
这次部署的是千问3.5的2B版本,参数量约20亿。因为要支持图片问答,整个工程需要两个模型文件:语言模型负责生成回答,视觉编码器负责处理图片。纯文字提问时只走语言模型;上传图片时,图片先经过视觉编码器提取特征,再和问题一起交给语言模型。
理解这两条路线很关键。后面调试时如果文字问答正常但图片问答失败,问题大概率出在视觉编码器这条链路上,而不是语言模型本身。
模型文件的准备:格式与量化方案
UP主直接使用了已经转换好的权重,没有从头做模型转换。语言模型采用W8A8量化版本,格式为RKLLM;视觉编码器使用RKNN格式。这个环节划定了本期的范围——从转换好的权重开始,重点看部署和运行。
下载完成后,UP主核对了文件校验值确认模型完整。这个步骤看似多余,但如果不校验,后面加载失败可能排查半天环境问题,最后发现只是文件没下完整。
RKLLM 是瑞芯微为其 NPU 平台提供的专用大语言模型推理框架,模型权重需要经过官方工具链转换才能被 NPU 调用,不能直接加载常见的 GGUF 或 PyTorch 格式。RKNN 则是瑞芯微针对视觉类模型的 NPU 推理格式,常见于分类、检测、OCR 等任务。两者同属瑞芯微生态但面向不同场景:RKLLM 专注自回归的 Transformer 语言解码,RKNN 面向卷积与视觉编码结构。
W8A8 量化指权重(Weight)和激活(Activation)都压缩为 8 位整数。相比 FP16,它能显著降低显存占用、提升 NPU 吞吐,代价是可能带来轻微精度损失。在 RK3588 这类边缘芯片上,W8A8 往往是兼顾速度与可运行性的折中选择,而视觉编码器通常对量化更敏感,所以不少工程会保留其较高精度版本。
板子上的运行环境:让程序找到模型和NPU
工程放在板子的部署目录下,模型、运行库和推理程序分别放好。这一环要解决的核心问题是:程序启动后能不能找到模型、找到运行库、正常调用NPU。
启动脚本里配置了动态库路径,让程序能找到需要的库。UP主在视频中展示了运行库和驱动的版本,方便复现时核对。如果启动时报错,第一件事是看报错发生在哪一步——是找不到库,还是模型加载失败。先确定位置,再去排查,效率会高很多。
RK3588 是瑞芯微的旗舰级边缘 SoC,内置独立 NPU,标称算力约 6 TOPS(INT8),常被用于开发板、工控机和边缘服务器。它的 NPU 在 AI 推理场景中承担矩阵运算加速,但需要配套的驱动、运行时库(如 librknnrt、librkllmrt)和内核模块才能工作。
动态库路径通常由启动脚本中的环境变量(如 LD_LIBRARY_PATH)指定。如果不配置,程序启动时会在系统默认路径中查找依赖库,一旦找不到就会报 “cannot open shared object file” 一类错误。因此在新板子上复现时,先确认驱动版本与运行时版本是否匹配,往往比反复改代码更有效。
推理程序:在开源代码基础上补全能力
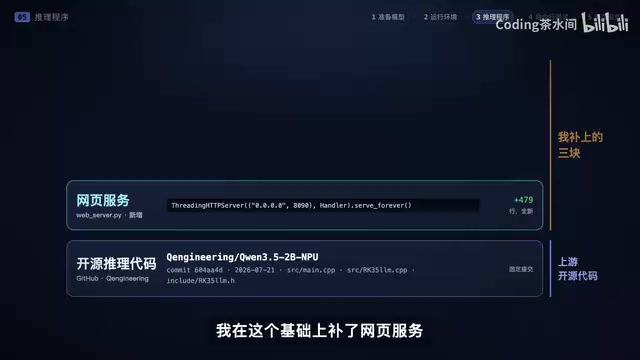
这个工程基于Q-engineering的开源推理代码,UP主在此基础上补了三个能力:网页服务、模型常驻、流式输出。
视觉编码和语言模型推理都用到了RK3588的NPU。推理过程的逻辑前面已经说过——文字走语言模型,图片先过视觉编码器再合并推理。这里要验证的是这两条线能不能真正跑通。
命令行测试:先文字、再图片
UP主先问了一个简单问题:“请用一句中文介绍你自己。”短问题方便观察模型有没有成功加载、能不能正常输出文字。
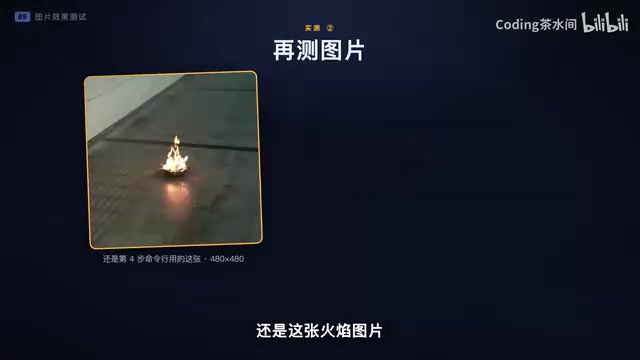
文字问答跑通后,再传入一张火焰图片,问“图中有没有明火”。为什么分开测?因为一上来就把图片、网页、对话历史全部加进去,出了问题很难判断卡在哪一环。先文字再图片,确认底层推理正常,后面接网页就有了基础。
网页交互:两个直接影响体验的设计
终端测试通过后,UP主加了一个网页界面,同一个局域网里打开板子的地址就能聊天、上传图片。
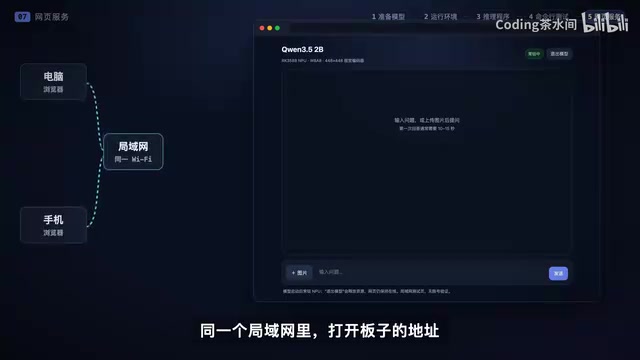
这里做了两个直接影响体验的处理:
模型常驻:服务启动时加载模型,后面所有提问复用同一个进程,省掉反复加载的等待。
流式输出:模型生成一段,网页显示一段。你可以先看到回答开始出现,再等它说完。需要释放资源时,也能在网页上退出模型。
流式输出依赖大模型的逐 token 生成特性:模型不是一次性算完整段回答,而是每产生一个 token 就输出一次片段。服务端通过 Server-Sent Events(SSE)或 WebSocket 把这些片段实时推送到浏览器,用户就能看到回答“一个字一个字”出现。这样做的好处是首字延迟明显降低,交互感更强;代价是前端需要处理增量拼接、连接中断等细节。
模型常驻则解决了反复加载权重带来的开销。LLM 权重动辄数 GB,每次加载都要从存储读入内存并初始化,耗时可能几秒到几十秒。将模型驻留在常驻进程里,后续请求直接复用,可以把响应延迟压到毫秒级,这对网页聊天这类高频交互至关重要。资源释放时再统一卸载,避免长期占用 NPU 和内存。
实测数据:文字快、图片要等
先看文字问答。UP主提示注意两个时间——多久开始出现回答、多久全部回答完。按工程之前的测试记录,模型常驻以后,纯文本大约0.38秒开始输出,短回答大约0.7到1.4秒完成。
图片问答方面,还是那张火焰图片。因为要先经过视觉编码,开始回答之前会多等一段时间。之前的测试数据是大约4.2秒开始输出,整次问答大约5.5秒完成。回答越长,完成时间也会变化。
从视频中的实测结果看,完整回答保留了原文,可以核对它有没有描述对,有没有说出图片里不存在的东西。
这套方案的意义与后续
目前这块RK3588已经能在本地运行千问3.5的2B版本,完成文字和单张图片问答,也能通过网页直接使用。回头看部署过程,其实就是几步:准备适配的模型、配好运行环境、跑通文字和图片推理、再接上使用界面。每一步都确认成功再往下走,排查起来会清楚很多。
UP主也表示,接下来会继续换图片、换问题测试,看它在哪些场景下能答对,哪些地方容易出错。模型能启动只是部署成功的第一步,真正的效果还得一道题一道题地测。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。