2,103词表是错误吗?小代码模型词表规模实验

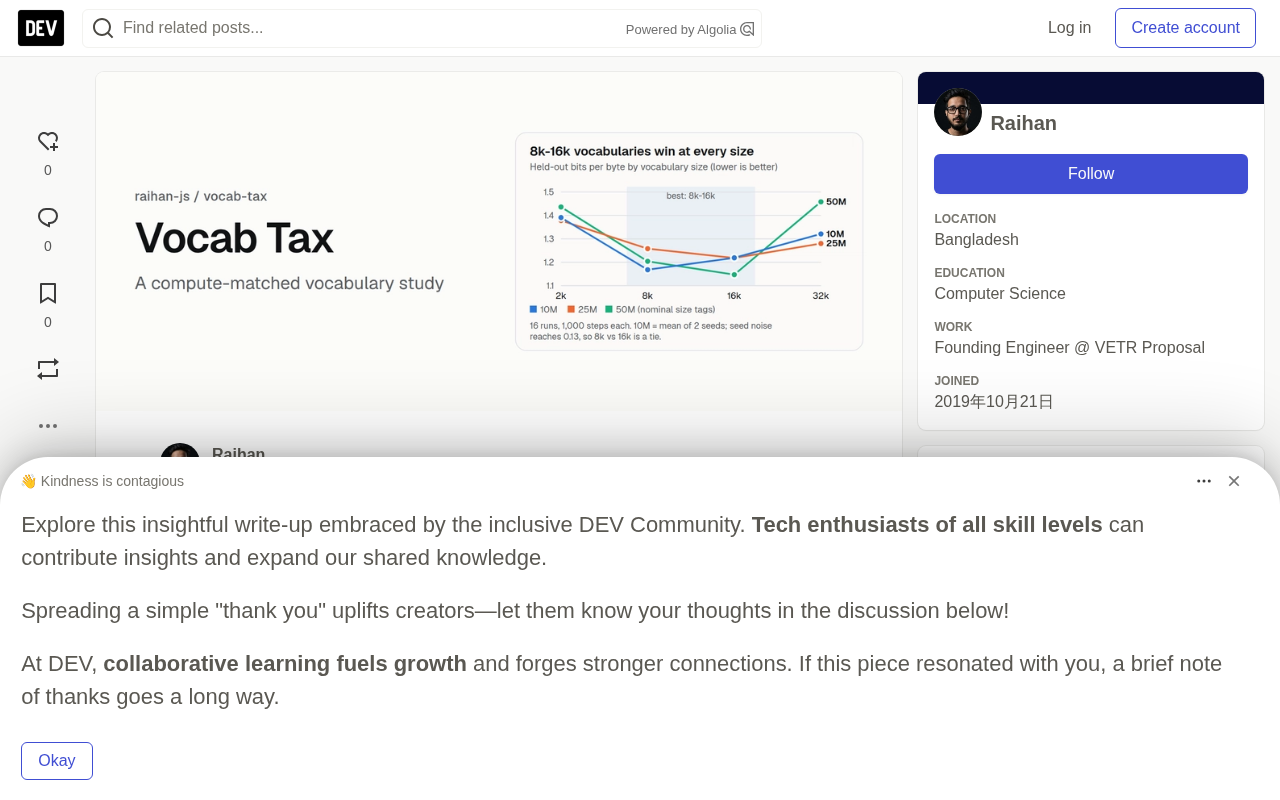
在小型代码模型控制变量实验中,8k–16k 词表全面优于 2k 和 32k,词表选择比骨干规模更重要。
一项针对小型代码模型的分词器控制变量实验,在 3 种模型规模(名义 10M/25M/50M)和 4 种词表大小(2k/8k/16k/32k)下,以每字节比特数(bpb)为指标进行公平对比。结果显示,8k–16k 词表在所有规模下均胜出;2k 词表始终最差,在 10M 规模下 bpb 比 8k 高约 19%;32k 在 50M 规模下因嵌入矩阵占参数近半且欠训练而崩溃。词表选择的影响超过骨干规模:8k 词表的 10M 模型比 2k 词表的 50M 模型参数少 4.2 倍,bpb 却低 18.7%。作者指出 2,103 token 词表方向性错误,但受数据与训练差异限制,结论为提示性而非决定性,且种子噪声高达 0.13。
引言:当词表规模成为唯一变量
在训练小型代码模型时,分词器词表大小的选择往往被视作次要超参数。但一篇来自开发社区的实验报告提出了尖锐问题:2,103 token 的词表是否从一开始就是错误?
作者曾训练 ORCH-Fusion(2,103 token,272.7M 参数)和 ORCH-Next.js-350M-v2(16,000 token,287M 参数),但两者在骨干、数据和训练流程上均不同,无法判断小词表究竟是否拖了后腿。为此,新实验将分词器设为唯一变量:12 个 LLaMA 风格解码器,3 种模型规模 × 4 种词表大小,训练 FLOPs 严格对齐。
实验设计:控制变量下的公平对比
研究使用 7,606 个经精确哈希去重的 TypeScript/JavaScript 文件,训练了 4 个字节级 BPE 分词器,词表规模分别为 2k、8k、16k 和 32k,且所有分词器在同一字节序列上训练。模型方面,采用 3 种 LLaMA 风格尺寸,名义标签为 10M、25M 和 50M,但实际参数量因嵌入表差异而不同。每个配置只训练 1,000 步,属于 欠训练状态,因此结论仅适用于该预算下的词表选择,而非计算最优训练阶段。评估指标为保留集上的 每字节比特数(bits-per-byte,bpb),该指标对词表大小不敏感,适合跨分词器比较。
字节级 BPE(Byte-level BPE) 是 GPT-2 等模型采用的分词方案。它先将文本转为 UTF-8 字节序列,再在字节层运行 BPE 合并算法。与字符级或词级分词不同,字节级方案天然覆盖任意 Unicode 字符,无需 UNK 标记,词表规模可自由设定。本实验的 2k、8k、16k、32k 四个分词器均在同一字节序列上训练,唯一差异是合并操作数量,从而保证对比公平。
每字节比特数(bits-per-byte,bpb) 是语言模型压缩效率的度量:模型对文本的负对数似然除以原始字节数。由于所有分词器还原后的字节序列长度相同,bpb 不随 token 切分方式变化,因此适合跨词表比较。bpb 越低表示模型对文本的预测越准。相比困惑度(perplexity),bpb 避免了词表大小对指标的人为影响。
词表规模如何影响分词效率
分词器的“生育率”(fertility)指每字节对应的 token 数量。实验测得:
| 词表大小 | 每字节 token 数 |
|---|---|
| 2,000 | 0.4475 |
| 8,000 | 0.3667 |
| 16,000 | 0.3435 |
| 32,000 | 0.3275 |
大词表显著降低生育率,意味着序列更短、推理更快。但代价是嵌入矩阵膨胀,消耗更多 FLOPs。核心问题在于:质量增益能否抵消计算成本?
分词器生育率(fertility) 衡量每个字节平均产生多少 token,数值越低表示同样文本被切成的 token 越少。生育率直接决定序列长度:生育率 0.4475 意味着 1 字节文本约需 0.4475 个 token,序列被拉长;而 0.3275 则将序列压缩约 27%。更短的序列意味着注意力计算和自回归生成步数减少,推理吞吐更高。但另一方面,大词表使嵌入矩阵(vocab_size × d_model)和输出投影层参数量线性增长,在训练中消耗更多 FLOPs,并可能因参数过多而欠拟合。
结果:8k–16k 词表全面胜出
保留集上的 bpb 结果如下表所示(每格为 1,000 步后的评估值):
| 非嵌入参数 | 2k | 8k | 16k | 32k |
|---|---|---|---|---|
| 10M | 1.391 | 1.168 | 1.219 | 1.321 |
| 25M | 1.378 | 1.258 | 1.218 | 1.280 |
| 50M | 1.436 | 1.204 | 1.147 | 1.458 |
10M 行是 2 个随机种子的均值,种子噪声高达 0.13,因此 10M 规模下 8k 与 16k 的差异可视为平局。
尺寸标签仅是名义值,真实参数量如下:
| 尺寸标签 | 非嵌入参数 | 2k 总参数 | 8k 总参数 | 16k 总参数 | 32k 总参数 |
|---|---|---|---|---|---|
| 10M | 3.9M | 5.0M | 8.0M | 12.1M | 20.3M |
| 25M | 13.3M | 14.8M | 19.4M | 25.6M | 37.9M |
| 50M | 31.5M | 33.5M | 39.7M | 47.9M | 64.2M |
关键发现
- 8k–16k 在所有规模下均获胜。 2k 词表始终表现最差;32k 在 50M 规模下崩溃,因为其嵌入矩阵占据近半模型参数,1,000 步内无法充分训练。
- 词表选择比骨干规模更重要。 10M 标签配 8k 词表(总参数 8.0M,bpb 1.168)击败 50M 标签配 2k 词表(总参数 33.5M,bpb 1.436)——参数少 4.2 倍,bpb 反而低 18.7%。
- 种子噪声不容忽视。 两个 10M 种子间 bpb 差异可达 0.13,因此小于约 0.1 的差异应如实报告为平局。
- 2,103 token 词表方向性错误。 在 10M 规模下,2k 词表比 8k 的 bpb 高出约 19%。但 ORCH 在数据和训练上也不同,所以这是提示性结论,而非决定性证据。
局限与后续计划
实验规模有限:3 种尺寸难以拟合缩放定律;差异可能落在种子噪声内;在 10–50M 参数下,32k 词表的嵌入参数占主导。此外,RTX 3060 的内存带宽限制吞吐,需要实际测量 MFU 而非猜测。
下一步计划包括加入前沿 API 基线、在更大保留集上验证曲线,并将发现应用于下一代 ORCH 模型。代码库已开源,7 项测试全部通过——分词器是唯一变量,结论值得小型代码模型开发者参考。
模型 FLOPs 利用率(MFU) 是衡量训练效率的指标,定义为实际达到的浮点运算速度与硬件理论峰值的比值。在消费级 GPU(如 RTX 3060)上,内存带宽往往先于算力成为瓶颈,导致 MFU 远低于 100%。本实验因受限于显存带宽,无法准确估算训练 FLOPs 的实际消耗,因此作者计划实测 MFU,以更精确地比较不同词表配置下的计算成本。
相关推荐

GitHub日报·10月23日:Agent运行时与技能库同日爆发

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。