211K星标Hermes启示录:Claude代码的记忆短板如何自救

Hermes靠记忆能力五个月获21万星,但语义召回缺口让自建方案更可取。
文章分析 Hermes Agent 五个月斩获 21.1 万 GitHub 星标的原因,指出核心并非集成数量而是记忆能力,约 30% 的迁移用户将记忆默认值列为切换主因。作者将记忆系统拆为存储、注入、召回三层作为评估标尺,指出 Claude Code 内置记忆薄弱——仅加载 memory.md 索引、召回依赖 30 天内的关键词匹配,词不重合即等于遗忘。Hermes 的可取之处包括冻结快照注入、Agent 自主决定存储、全量留存原始转录;缺陷则是自我改写可能覆盖正确信息、独立运行时的运维成本、记忆字符硬上限。作者选择在 Claude Code 内原地重建,用 PG 向量实现语义召回,并补上引用来源、历史导入与团队隔离三项能力,最终形成“记忆比集成更重要”的共识,但在迁移 Hermes 还是自建记忆层上存在路径分歧。
为什么一个“记性好”的Agent能五个月斩获21万星
海外技术博主在B站发布的中字视频里抛出一个反直觉的结论:Hermes Agent在五个月内从零冲到211,000 GitHub星标,靠的不是集成数量,也不是自我构建技能,而是记住一切的能力。有人分析了Reddit上关于用户从OpenClaw广告迁移到Hermes的1,300条评论,约30%的迁移者明确将“记忆默认值”列为切换理由。
一条被反复引用的评论是:“记住上下文比一千个集成更有价值。”这话戳中了当前Agent产品的软肋——连接一堆你从未真正需要过的工具,远不如记住三个月前你定下的那条业务规则。
视频作者把Hermes的记忆系统拆解为三个可复用的概念:存储、注入、召回。存储解决“重要的东西怎么存、存在哪”;注入解决“每次会话开始时自动加载什么”;召回解决“问及旧事时如何找回来、找得准不准”。这套三分法,恰恰是评估任何Agent记忆方案的实用标尺。
Claude Code的记忆现状:一个被市场瞄准的缺口
截至视频发布时(2026年7月),Claude Code的内置记忆确实薄弱。它会把自认为重要的内容写入一个memory.md索引,注入阶段几乎只加载code.md和这个索引,而召回时则遍历过去30天的会话文件,且按关键词匹配。
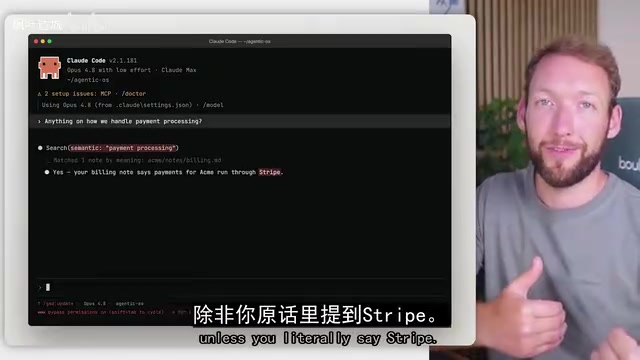
这意味着:如果你当初讨论的是“Stripe”,后来问的是“支付处理”,系统很可能找不到那次对话。关键词不重合,记忆就等于不存在。市场对此的反应很直接——一批开源或付费框架专门围绕这个痛点生长出来,Hermes正是其中跑得最快的一个。
有意思的是,Hermes的竞争对象其实是“会话模型”本身。它的核心命题是:下一层价值在连续性,而不只是单次对话的智能水平。模型能力可以继续提升,但历史对话能否被准确调取,是另一条独立的护城河。
Hermes的三个可取之处与三个真实缺陷
视频作者对Hermes并非全盘接受。他提炼了三个值得照搬的设计,也点出了三个让人犹豫的限制。
可取之处一:冻结快照。 定价、活跃客户、当前决策这类信息不该每次从长期记忆里现查,而应在会话开始时就静默注入。Hermes维护一个字符数上限的memory.md(作者自己的实现上限为2,500字符),防止上下文膨胀。
可取之处二:Agent自主决定存什么。 不该由用户手动判断哪句话值得记住。Hermes在每轮对话后自我提示持久化知识;作者的做法是挂一个钩子,每轮判断是否有值得保留的“持久事实”——决策、价格变动、个人偏好——去重后写入快照。
可取之处三:全量留存。 Hermes把每次会话存入本地数据库,保留原始消息而非摘要,因此可以回溯任意时刻。作者在此基础上进一步:每轮生成摘要,同时保留完整转录,摘要归档为长期记忆,转录用于精确引用。
缺陷一:自我改写回路。 Hermes最出名的自我编辑技能,也是最大风险。多方报告显示它会在编辑自身技能时高估结果,覆盖掉原本正确的信息。社区用户不得不加装审批门和回滚功能来兜底。
缺陷二:独立运行时。 它是与Claude Code完全不同的进程,跑在服务器或VPS上,有自己的模型计费、安全面和更新周期,维护成本不容忽视。
缺陷三:记忆硬上限。 字符限制会压缩甚至替换条目,有用户专门写插件,只为阻止常驻指令被反复遗忘。
FTS5 是什么: FTS5(Full-Text Search 5)是 SQLite 内置的全文检索扩展模块,通过倒排索引加速文本匹配,支持布尔查询、短语搜索和前缀匹配。它的优点是零依赖、轻量、查询极快,适合嵌入式场景;局限在于本质仍是词法匹配——同义词、改写、跨语言表述无法自动对齐。因此当用户用“支付处理”去检索当年以“Stripe”为关键词的对话时,FTS5 会因为词形不重合而返回空结果。这也是 Hermes 召回能力的结构性天花板,需外挂向量检索(如 mem0、honcho)才能补齐语义层。
在Claude Code里重建:语义召回是关键分水岭
作者的方案是在Claude Code内部原地重建,理由有三:文件在文件夹里,可跨Claude Code、Codex等界面迁移;无需VPS和第二套模型计费,全部走现有订阅;数据留在本地,没有额外安全面。
真正拉开差距的是召回环节。Hermes用SQLite的FTS5做全文检索,本质仍是关键词匹配。其GitHub上有一个未关闭的issue明确指出:会话搜索完全依赖FTS5关键词匹配,查询必须包含对话中的原词才能命中。
作者改用PG向量做向量嵌入,同时支持语义与关键词检索,对结果重排序,并向邻近对话扩展上下文。他坦言,Hermes可以通过外挂mem0、honcho等插件补足,但那又是另一个需要运维的服务。
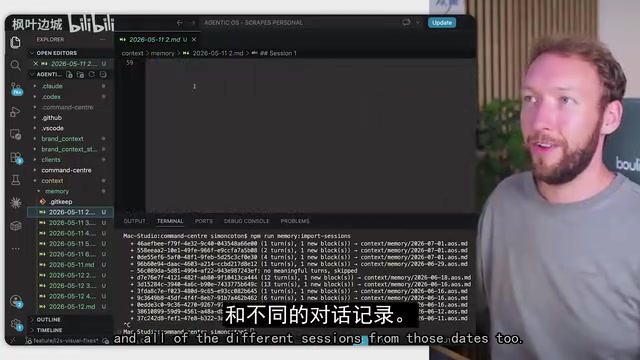
召回之外,作者还补了Hermes缺失的三件事:引用来源(引用时说清原话、决策人、日期,不知道就承认不知道);导入历史(一条命令扫描现有Claude Code会话,用Haiku摘要后嵌入长期记忆,同时保留完整转录以便日后检索);团队隔离(每条记忆按归属打标签,查询按提问者过滤,一个共享大脑、各看各的)。
向量嵌入与语义检索: 向量嵌入是把一段文本映射为高维数值向量,语义相近的文本在向量空间中距离更近。检索时把查询也嵌入为向量,通过余弦相似度或内积找最近邻,从而命中“说法不同但意思相同”的历史对话。PG向量(pgvector)是 PostgreSQL 的向量扩展,可在同一数据库中同时存储关系数据与嵌入向量,支持 IVFFlat/HNSW 索引加速近似最近邻查询。相比纯关键词匹配,它解决了同义改写、跨表述召回的问题;配合重排序(rerank)与上下文窗口扩展,召回精度可进一步提升。代价是需要嵌入模型调用与向量存储运维。
多源视角下的共识与分歧
这次分析并非孤证。视频引用了Kilo对1,300条Reddit评论的统计,也引用了多位用户的直接反馈,与作者自身对三个记忆系统的横向拆解形成交叉验证。在“记忆比集成更重要”这一点上,多方说法高度一致,可以视为当前Agent用户的普遍共识。
分歧在于路径选择。一派认为直接用Hermes开箱即用更省事,接受其自我改写风险和独立运维成本;另一派如作者,坚持把记忆层握在自己手里,用文件加本地向量库的方式换取可移植性和可控性。前者胜在起步快,后者胜在长期可维护——这取决于你更怕“配置麻烦”还是更怕“记忆被覆盖”。
需要标注单一来源的是“团队OS”部分:这是作者所在社区正在内测的beta功能,尚无第三方验证,读者应将其视为方向性参考而非成熟方案。
迁移分析的样本局限: 文中引用的 1,300 条 Reddit 评论属于自选择样本——只有对迁移有强烈感受的用户才会发帖,因此 30% 这一比例反映的是“发声者中的占比”,而非全体用户的实际迁移率。此外,评论中“记忆默认值”这一表述可能同时涵盖注入策略、存储上限、召回精度等多个子维度,统计口径并不统一。这类社区数据的价值在于揭示需求方向与痛点分布,而非提供精确的量化结论;将其与作者自身横向拆解交叉验证,比单独依赖任何一方都更可靠。
这对普通用户意味着什么
对个人开发者而言,最实用的动作是检查你的Agent到底记住了什么。打开memory.md看看条目是否还准确,问它一个三个月前的决策看能否复现来源。如果召回只靠关键词,你迟早会遇到“明明说过却找不到”的挫败。
对团队而言,记忆的归属与隔离会成为下一个刚需。一个共享大脑、按项目与成员过滤,比单纯堆叠集成更能减少重复沟通。
Hermes证明了记忆的需求真实存在,但它没有证明你必须迁移到Hermes才能获得这份记忆。把逻辑拆成存储、注入、召回三层,用自己可控的文件和本地检索实现,是另一条同样成立的路——而且从长期看,那条路上的资产真正属于你。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。