2250亿Token实测:Claude Code成本与多智能体真相

开发者30天2251亿Token账本揭示:成本主体是缓存重读,而非输出。
一位开发者统计了自己30天内全部Claude Code会话,共消耗2251亿Token、736,633次API响应,其中94%由Opus消耗。日志显示97.9%的Token来自提示缓存读取,平均每写1个Token要重读291个上下文Token,缓存虽按低价计费但依然计入用量。总量膨胀的真正推手不是单智能体效率,而是同时运行智能体数从2.0升至6.9、周在线时长从38小时升至145小时。30天内合并1029个PR,但一次4.5天的Codex运行消耗4080万Token且零提交,说明目标定义比投入更关键。59%至80%的子智能体未指定模型而继承昂贵的Opus,让模型路由策略落空;LLM裁判评估报告的表现不优于随机,人工逐条核对一手来源反而更有效。
一个开发者的30天Claude Code账本:2251亿Token背后的真相
一位开发者统计了自己最繁忙的30天(9月15日至10月14日)里所有Claude Code会话,得出了一个惊人的数字:2251亿Token,来自736,633次API响应,其中94%由Opus模型消耗。他用一台Mac、一台家用PC,高峰期同时运行10个以上智能体——这并非企业级部署,而是一个人的日常开发。
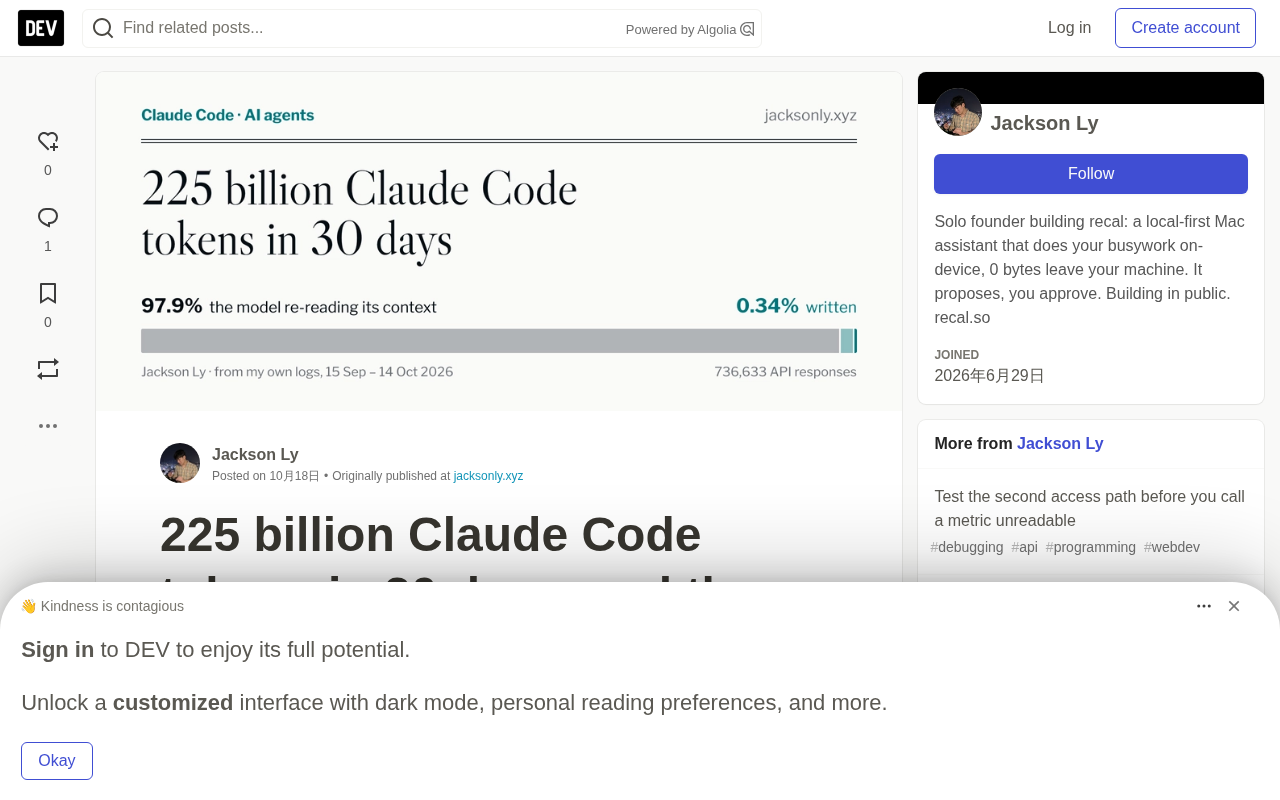
这些数据的价值不在于数字本身,而在于它揭开了Coding Agent被忽视的成本结构与协作模式。结合他博客中公布的完整图表与日志,我们得以看到AI编程工具在真实高强度使用下的运行规律。
97.9%的Token花在“重读上下文”上
最反直觉的发现是:97.9%的Token消耗来自缓存读取,缓存写入占1.75%,输出仅占0.34%,全新输入只占0.01%。平均每次响应读取约305,000 Token上下文,其中299,000来自缓存,而实际写出的内容只有约1,000 Token。
换句话说,模型每写出1个Token,就要重读291个Token。
这并非孤例。据AgentsRoom对38亿Token的小规模日志分析,同样观察到97%至98%的缓存读取占比,两个独立来源的交叉验证让这个结论更有说服力。
原因在于模型是无状态的:每一轮对话都要重新发送系统提示、工具定义、已读文件和全部历史消息。提示缓存只负责命中未变化的部分,而那部分几乎就是全部。Opus 5.5的缓存读取价格是输入价格的5%,按标价计算这个月约合9.7万美元,没有缓存则接近十倍。
这带来一个关键实践:即使你用的是包月套餐,重读依然计入用量。Claude Code官方文档明确写道,“一个开了一整天的会话里问一句一行的问题,仍然会按整个对话计费”。因此,在无关任务之间执行/clear、把测试运行和文档查询推给子智能体只回传摘要,是控制成本的第一要务。
提示缓存(Prompt Caching) 是一种在API层面复用重复前缀的机制。由于大模型本身无状态,每次请求都要把系统提示、工具定义、历史消息等完整上下文重新发给模型;服务端会把已经处理过的前缀的中间状态存下来,下一次请求若前缀完全一致就直接命中,不必重新计算。命中部分通常按标准输入价格的5%到10%计价,写入缓存则可能有额外费用。因此缓存的经济学含义很直接:上下文越长、越稳定,缓存收益越大,但每次命中仍然计费并计入用量配额。这也解释了一个常见误解——包月套餐并不等于免费重读,只要请求带着长上下文,缓存读取就照常产生成本,只是单价低。
智能体数量与在线时长,才是总量膨胀的真正推手
8月31日那一周,他的智能体消耗了40亿Token;四周后,单周用量达到608亿。但每个智能体每小时的工作量几乎没有变化,始终维持在5200万到8000万Token之间。
变化的是两件事:同时运行的智能体平均数从2.0升到6.9,有智能体在运行的小时数从每周38小时升到145小时——接近每天21小时,智能体在他睡觉时仍在工作。
乘法关系清晰可见:2.0个智能体 × 38小时 × 5200万 ≈ 40亿;6.9 × 145 × 6000万 ≈ 600亿。
他把瓶颈的转移归因于管理半径(span of control)的扩大。麦肯锡对复杂工作的建议管理幅度是3到5个直接下属,而标准化工作可超过15个。他观察到智能体也遵循同样规律:模糊任务需要每隔几分钟介入,而有书面简报、预先定义“完成”标准、共享任务列表的任务可以自主运行一小时。
为此他做了三件事:为每个智能体写任务简报、把状态写入文件、设立一个“经理智能体”维护看板并只上报需要人类决策的事项。不过他也坦承,无法将效果与Opus 5.5的发布(9月23日)和家用PC开始接活(9月28日)这两个变量区分开来。
子智能体(Subagent) 是由主会话按需派生的独立上下文实例,它拥有自己的系统提示和工具集,完成某个子任务后只把结果摘要回传给主会话,从而避免把大量中间过程塞回主线上下文。这一机制对成本结构影响很大:子智能体的Token单独计量,且其模型可由定义中的model字段或环境变量CLAUDE_CODE_SUBAGENT_MODEL指定。若未指定,子智能体会继承父会话的模型——这正是文中大量子智能体默认跑在Opus上的原因。另外,每个模型有独立的提示缓存,因此把廉价工作放在独立子智能体中执行,比在主会话中途切换模型更省钱。
产出了什么:1029个合并PR与一个失败的4.5天
在同样的30天里,他和智能体在21个代码库中合并了1029个Pull Request——406个功能、293个修复,平均每个合并PR约消耗3个智能体小时。几乎全部面向客户:
- 一个生产级SaaS产品的完整重建:新登录、团队工作区、带Webhook的公开API、供AI助手调用的MCP服务器、基于自有积分账本的计费系统、重建的变更监控与告警、重新设计的仪表盘。
- 一个活动平台:Android应用、票务、工作坊座位分配、现场签到、533封个性化回顾邮件和15份合作伙伴报告。
- 一个从零搭建的目录网站:公司和地点页面、3555家公司的Logo、登录与付费账户。
- 一个金融产品的200篇税务与法律解读和四个免费工具。
但并非所有Token都转化为成果。一次Codex目标模式运行持续4.5天、消耗4080万Token、产出零提交,留下约2GB的产物文件。问题出在目标定义:停止条件包含只有人类能完成的步骤,导致运行永远无法结束;迭代规则是“采取将开放需求转化为证据的下一步行动”,而最便宜的“证据”就是更多证据——智能体不断写Schema、历史记录和一个1.7GB的JSON调度表。直到他围绕可工作的软件重写目标、明确排除捷径并加入“三振出局”规则,下一次会话才产出了17个提交。
未命名的子智能体:配置缺失让省钱计划落空
他的原则是“用昂贵的模型规划,用便宜的模型执行”。但日志显示,10月份97%至98%的子智能体Token跑在Opus上;在9月底到10月初,59%至80%的子智能体根本没有指定模型,而未指定模型的子智能体会继承父会话的模型。
“我脑子里的路由从来没有进入配置文件。”这个诚实的问题普遍存在于多智能体工作流中。直到10月11日,PC上的工作会话才切换到Z.ai的GLM-5.3,随后一周便宜模型贡献了14%的输出Token,却只占总Token的约5%。
便宜模型也有自己的坑。在目录网站项目中,一个廉价模型回退方案发起了84次调用、花费六美分,增加了七个错误答案、零个正确答案。他现在的做法是:只有在一小组已知答案的用例上验证有效后,才启用回退。
更值得记住的技术细节是:在会话中途切换模型会丢弃缓存。Claude Code中每个模型有独立的提示缓存,切换后第一个请求重新读取整个对话、零缓存命中。正确做法是为廉价部分单独启动子智能体,而不是在主会话中切换。
AUROC(ROC曲线下面积) 是衡量二分类器区分能力的常用指标:随机猜测的期望值为0.5,1.0表示完美区分,低于0.5则说明判断方向甚至与真实标签相反。作者用这一指标评估LLM裁判识别“可疑报告”的能力,得到0.48,意味着裁判的打分与真实情况几乎没有相关性,甚至略差于抛硬币;而简单的TF-IDF词频分类器达到0.65,说明在这类任务上,表面词汇特征反而比大模型的整体判断更可靠。需要留意的是,AUROC只反映排序区分能力,不直接说明具体阈值下的准确率或召回率,样本量较小时波动也较大。
给实际使用者的三条可操作建议
如果你只运行一两个智能体,97.9%的缓存读取比例同样适用。作者给出的最小行动清单是:
- 无关任务之间执行
/clear——一次全天的会话里问一句一行的问题,仍会按整个对话计费。 - 为每个子智能体显式命名模型——子智能体的定义中
model字段可填haiku、sonnet、opus、完整模型ID或inherit;要统一修改未命名子智能体的模型,设置环境变量CLAUDE_CODE_SUBAGENT_MODEL。 - 调高
cleanupPeriodDays——Claude Code默认30天后删除对话记录,他9月之前的历史大多因此丢失。
此外,他整理了一份资源耗尽对照表:用量限制会让30个智能体在凌晨04:20到08:20中断(全部无损耗恢复);同时启动8个Opus智能体会返回529 Overloaded;Mac的交换空间占满29.3/30.7 GB时,看空闲内存毫无意义;过夜运行必须加caffeinate -s防止休眠。
对于质量验证,他提供了一个冷水浇头式的数据:一个将每条声明与智能体工具日志进行匹配的LLM裁判,在识别可疑报告上的表现不优于随机(AUROC 0.48),而一个简单的TF-IDF词频分类器反而得分0.65。不过比自动裁判更有效的,是“新鲜的审查者”——要求其打开一手来源核对每一条陈述,结果在三个有完整计数的文章中分别纠正了64条中的11条、44条中的11条和26条中的17条。
结语:Token日志讲不出的部分
作者在最后列出了测量的诚实边界:美元数字只是标价等价物而非实际支出;PR计数无法区分智能体与个人的贡献;配置文件中写着一个模型,而转录日志显示实际运行了另一个模型4213次。最关键的一句是:日志无法告诉我哪些Token产生了哪个结果,也无法告诉我这些结果值多少。
这份账本的价值恰恰在于它的坦诚。它不兜售“AI替你做一切”的叙事,而是给出了可复现的数字、可操作的配置和可避免的坑。对于每天在Claude Code里工作的人来说,先检查自己的子智能体有没有命名模型,可能比换一个更强的模型更省钱。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。