22万元Mac Studio本地跑AI实测:能替代云端吗?

22,299美元的512GB M5 Ultra Mac Studio,买的是本地化而非更强能力。
文章以22,299美元的顶配M5 Ultra Mac Studio为对象,实测其替代Anthropic云端运行Claude Code的可行性。成本上,512GB内存单项加价15,500美元、占整机七成,源于DRAM合约价单季上涨90%至95%及HBM对产能的挤占。性能上,M5 Ultra的神经加速器使长提示预填充提速三到四倍,但仍落后于双DGX Spark;提示缓存能把追问首字从21秒降到3秒,却对前缀一致性极度敏感。生成速度受内存带宽约束,并发在四用户时见顶、八用户反降。Terminal Bench 4.0上GLM 5.3得41.82分,落后Opus 5.5达23分,多花的内存钱只换来约6分。结论是它适合一两人的重度本地智能体用户,追求前沿能力或多人共享仍应选云端。
苹果新一代Mac Studio(M5 Ultra芯片、512GB内存)定价22,299美元,海外博主和开发者围绕它做了一轮密集实测。核心问题只有一个:把Claude Code的一条请求从Anthropic服务器改到桌面上的这台机器,到底值不值?
价格拆解:大部分钱花在了内存上
最便宜的M5 Ultra Mac Studio售价5,499美元,而512GB版本只搭配顶配芯片,仅内存选配一项就加价15,500美元,约占整机价格的七成。对比之下,2025年3月同容量的M3 Ultra整机售价9,499美元,内存升级部分为4,000美元。
涨价背后是DRAM合约价整体上行。TrendForce数据显示,常规DRAM合约价在一个季度内上涨了90%至95%;HBM已占据约五分之一的DRAM晶圆产能,SK海力士与美光均表示其2026年HBM产能已售罄。苹果的应对是先后下架旧款M3 Ultra的512GB与256GB选项。新机上从256GB升到512GB单项加价11,500美元,折算下来每多一GB约45美元。WCCFtech报道的手机内存长期合约价接近每GB 21美元,两相对照,苹果的定价显得相当激进。
本地跑模型的现实:量化、内存上限与模型选择
开源模型权重公开可下载,但大模型无法原样装进本地机器,需要量化压缩。QESMA对270亿参数的Qwen模型做智能体编程测试,4-bit版本与完整模型表现相当,1-bit版本质量断崖式下滑,而且让1-bit模型"想更久"反而更差——它会一直推理到token耗尽。
内存也不是全部可用。macOS默认允许GPU使用约四分之三,通过一条终端命令可以调高,但重启后失效。按4-bit量化计算:GLM 5.3约418GB,装得下但余量不多;DeepSeek广告 V4.1 Flash约432GB,其中1960亿参数是一张巨大的n-gram查找表,Unsloth指出可以把这张表放在SSD上,4-bit模型在约305GB内存中运行;Kimi K3参数规模达2.8万亿,最小文件是466GB的1-bit版本;Meta的Muse Spark Open在4-bit下需要533GB,完全放不下,Meta自己的发布文章是用两台M5 Ultra Mac Studio来跑的。上述模型没有一个能在256GB Mac上以4-bit运行——这正是那11,500美元换来的空间。
量化(Quantization) 指把模型权重从高精度浮点数(如 FP16,每参数 2 字节)压缩到低比特表示,从而大幅降低显存/内存占用。常见的 4-bit 量化把每参数压到约 0.5 字节,配合分块缩放因子保留动态范围,所以 7440 亿参数的 GLM 5.3 能塞进约 418GB 内存。代价是精度损失:4-bit 通常与原模型表现接近,2-bit 开始明显退化,1-bit 则常出现质量断崖,且推理链越长错误累积越严重,这正是文中"1-bit 模型想更久反而更差"的原因。量化后还需匹配推理引擎的格式(如 GGUF、MLX 权重),不同引擎的量化方案与内核优化差异,也会造成同一模型在不同软件上解码速度相差一倍以上。
首字延迟:预填充是Mac的短板,缓存是解药
Claude Code每轮都会发送指令、完整工具列表和正在处理的文件。一位M3 Ultra用户实测,约16,000 token的系统提示需要等待约90秒才有响应。这个阶段叫预填充,依赖原始算力,而Mac历来是内存充裕、算力弱于大型显卡。
M5 Ultra的改进在于GPU核心内新增的神经加速器。苹果宣称提示处理速度最高可达前代的四倍。Ziskind实测长提示上获得三到四倍提升,短提示只有1.6倍;MacStories在16,000 token提示上测得约2.5倍,首字等待从13.9秒降到5.6秒。但英伟达方案仍然更快:Ziskind用32,000 token的代码库(14个Python文件)测试DeepSeek V4 Flash,256GB的M5 Ultra首字约50秒,两台合计约1万美元的DGX Spark只需17秒。
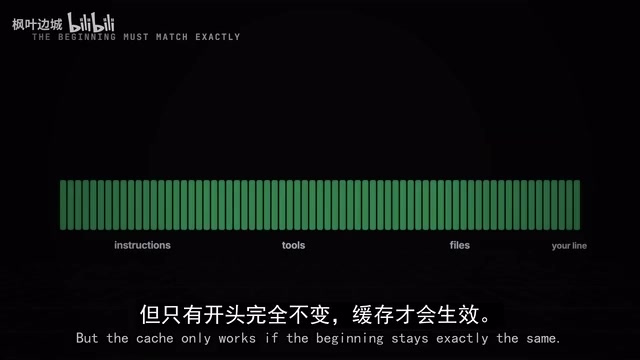
真正救命的是提示缓存。智能体每轮发送的开头几乎相同,服务器只需读取新增部分。OMLX把缓存放在内存中,再落到SSD,重启后依然保留。Ziskind的测试中,首个问题耗时21秒,追问只需3秒。但缓存生效的前提是开头完全一致——改动开头附近一个字符,模型就得全部重读。有用户发现Claude Code 2.1.181之前的版本在指向自有服务器时会把逐请求token放在系统提示顶部,导致本地服务器每轮重读全部提示;SpicyNeuron发现Claude Code会在轮次间重排工具顺序,于是修改模板强制排序;还有OMLX用户的智能体在整理历史时丢了一条旧消息,后续内容整体位移,缓存命中率跌到10%,首字耗时206.9秒,修复后回到3.1秒。请求发往Anthropic时缓存问题由Anthropic负责,放在自己桌上就得自己扛。
预填充(prefill)与解码(decode) 是 LLM 推理的两个阶段。预填充把整段输入提示一次性过一遍前向计算,生成 KV 缓存,属于高度并行的矩阵乘法,吃的是算力(FLOPS);解码则逐 token 自回归生成,每步只算一个 token,受内存带宽限制。因此长提示的首字延迟主要由预填充决定,而生成速度主要由带宽决定——这解释了为什么内存带宽高达 1.2TB/s 的 Mac 解码不弱,却在 16,000 token 的系统提示上要等几十秒。KV 缓存是预填充的产物,缓存注意力键值对,避免重复计算;提示缓存则更进一步,把相同前缀的计算结果整体复用,命中时只需处理新增 token,这是智能体多轮对话能把首字从 20 秒级降到 3 秒级的关键。
生成速度:内存带宽决定上限,并发是硬伤
每生成一个token,芯片都要从内存中取出模型的活跃部分,因此生成速度取决于内存速度。苹果标称M5 Ultra内存带宽1.2TB/s,Ziskind实测1,039GB/s,生成速度约为M3 Ultra的1.5倍。关键指标是活跃参数量:GLM 5.3总参数约7440亿,但每个token只激活400亿;GLM 5.3 Flash每token仅需180亿,因此更快。MacStories在256GB评测机上测得GLM 5.3 Flash在每秒31到41token之间;512GB机器上的完整GLM 5.3尚无公开数据,因为12月才开始发货。
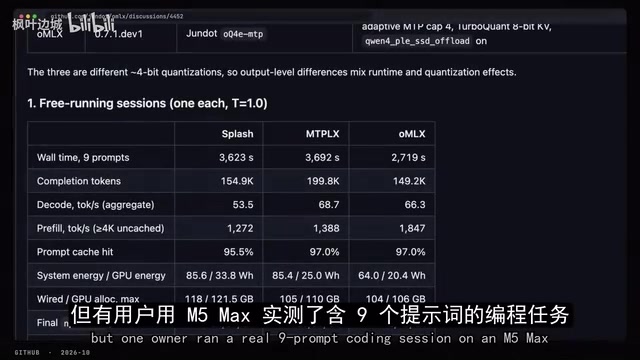
投机解码是另一个加速手段:小模型先草拟几个词,大模型一次校验整份草稿,代码可预测性强,猜中率高。OMLX社区基准中,GLM 5.3 Flash在M5 Ultra上Python代码生成快于英文代码。软件迭代也很快,Max Weinbach发帖称其解码速度一天内几乎翻倍;Inco.ai声称新引擎Splash比OMLX快一倍,但一位用户在M5 Max上用9条提示做真实编程会话,OMLX反而最先完成,Splash在三款引擎中解码最慢。
并发是这台机器的天花板。Claude Code会启动辅助智能体,各自并发发送请求。Ziskind逐步增加用户数测试DeepSeek V4 Flash:Mac的总吞吐在四个用户时达到峰值,八个用户时反而下降,而两台DGX Spark持续攀升;八个用户且带聊天历史时,每人首字等待超过一分钟,之后只有约每秒5token。他的结论是Mac是一台供一两个人使用的机器。SpicyNeuron在使用六个月后写道,跑较大模型时Mac Studio实际上只支持一个并发用户。投机解码的增益也会随并发衰减:一位用户单请求时获得76%的加速,四请求并发时只剩7%。
投机解码(speculative decoding) 用一个小的草稿模型先连续猜出若干个 token,再由大模型一次性并行校验,接受的 token 直接采纳,被拒的从分歧处重新生成。由于大模型一次前向可验证多个位置,而代码等结构化文本可预测性强、接受率高,因此在编程场景收益明显。其加速比取决于接受率与草稿长度,理论上限约为"平均接受 token 数 + 1"。代价是草稿模型本身也占内存和算力,且当并发请求增多、GPU 已接近饱和时,草稿计算会挤占主模型资源,加速比随之衰减——这正是文中单请求 76%、四请求仅剩 7% 的机制。
能力差距:多花11,500美元,多换几分
Terminal Bench 4.0用真实终端任务给AI智能体打分。Claude与GLM都在Claude Code内测试,评测框架一致。Claude Opus 5.5得分64.85%,GLM 5.3作为得分最高的开源模型为41.82%,差距23分;GLM 5.3介于Opus 4.8与Opus 5之间;能在256GB Mac上运行的GLM 5.3 Flash得分为35.76,且是在关闭思考模式下跑出的。也就是说,多花的11,500美元内存钱,只换来约6分。榜单还列出API运行成本:Opus 5.5完整跑一遍4,718美元,GLM 5.3为2,727美元,GLM 5.3 Flash为118美元。Epoch AI的能力指数显示,当前最强开源模型DeepSeek V4.1 Flash(10月17日更新)与Claude Opus 4.8持平,落后前沿约四个半月。
论坛上常见的替代方案是不买512GB、改买两台256GB。两台顶配256GB合计21,598美元,便宜701美元。问题出在互联:Thunderbolt 5约10GB/s,而M5 Ultra内存带宽1.2TB/s,相差约120倍。苹果10月15日公布的1280亿参数模型测试中,单机7.70token/s,两台各持一半层数也是7.70,没有增益;改用低延迟RDMA让两台机器共同处理每一层,达到13.69token/s,是单机的1.78倍。开启RDMA需要把每台Mac启动到恢复模式执行命令。知名的Mac集群应用EXO今年曾有数月没有发布新版本。Jeff Geerling去年12月搭好四机集群后的评价是:能用的时候很好用。
算账:什么时候划算,什么时候不划算
Claude Max 20X每月200美元,现已包含每月200美元的API额度,22,299美元在这面前几乎不算什么。Ziskind测得DeepSeek V4 Flash在M5 Ultra上约每秒53token,若全年不间断生成约17亿token;按OpenRouter上该模型每百万输出token 18美分计算,一年不停生成约值304美元。电费也不大:满载约400瓦,按每天8小时、美国平均电价计算,一年约212美元。
二手市场倒是反常:512GB的M3 Ultra在eBay上挂牌价约19,000至25,000美元,远高于9,499美元的首发价,有Hacker News用户发帖询问如何安全出售。也有用户把这台机器真正用满了:MacStories的Federico Vittici在Mac Studio上跑DeepSeek V4 Flash的研究智能体团队,为准备iOS 27评测连续运行99天、每天24小时,用他的话说总成本为0美元。他还表示现在可以把简单编程任务交给本地模型,再让前沿云端模型审查结果。
隐私是另一条理由。Anthropic文档称Claude代码执行工具的数据最多保留30天,且不符合HIPAA要求;Mac放在办公室,提示和代码始终在同一房间的机器上。加载的模型中DeepSeek V4.1 Flash和GLM 5.3 Flash均采用MIT许可证。SpicyNeuron在使用512GB Mac Studio六个月后写道:本地AI绝不是云API的即插即用替代品。Vittici在同一篇评测中称M5 Ultra是本地AI智能体的梦想机器,但也承认这套配置很折腾,他不会推荐给只想每月付20美元用Claude的人。
DRAM 与 HBM 的产能挤占 是这轮内存涨价的深层原因。HBM 通过硅通孔(TSV)把多层 DRAM 堆叠并与 GPU 封装在一起,单位容量消耗的晶圆面积远高于普通 DDR5,良率也更低。当 AI 加速卡需求爆发,三星、SK 海力士、美光纷纷把产能转向 HBM,常规 DRAM 供给被压缩,合约价随之跳涨。苹果的统一内存架构(UMA)让 CPU 与 GPU 共享同一块高带宽内存池,其 LPDDR 颗粒同样受这轮涨价波及,且焊死在主板上的设计意味着容量必须在购买时一次选定,无法后期扩容——这也是 512GB 选配定价如此激进、二手 M3 Ultra 反而溢价的结构性背景。
结论
这台22,299美元的机器买的不是"更快的Claude",而是数据不出房间、边际成本趋零、以及一台可以随时折腾的实验平台。它以不到一半的分数差距换来完全本地化,代价是首字延迟、并发限制、缓存调优和大量手工配置。对一人或两人的重度本地智能体用户,它可能是目前最顺手的整机方案;对追求前沿能力或多人共享的团队,云端API仍然更便宜也更强。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。