23个AI Agent跑交易MCP服务器:239次回测仅2笔下单
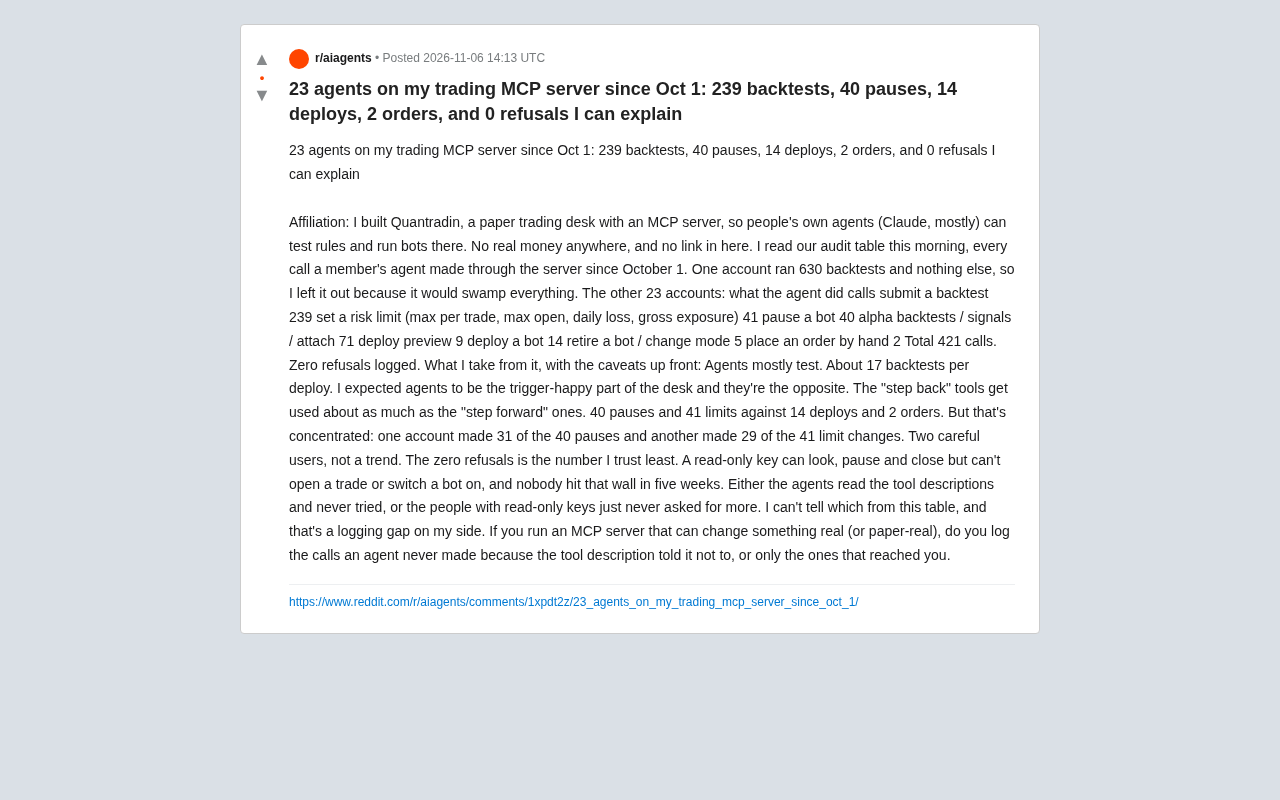
Reddit开发者审计23个账户421次MCP调用,发现Agent倾向多回测少执行,但零拒绝记录存在日志盲区。
一位开发者公开了其模拟交易平台Quantradin上MCP服务器的运行审计:23个账户在五周内共产生421次调用,其中回测239次、部署仅14次、手动下单2次,平均每个部署前跑约17次回测。风控类工具(暂停40次、设置限制41次)使用频率与执行类接近,但高度集中于两个账户,说明是个体谨慎而非普遍趋势。开发者最不信任"零拒绝"记录,因为只读密钥的权限边界从未被测试,且系统无法记录Agent因工具描述而主动放弃的调用。文章据此提出,工具描述构成调用前的隐式策略约束,MCP日志需覆盖被阻止与未发起的调用,否则权限系统有效性无法验证。
当AI Agent接管交易台:一份来自MCP服务器的真实审计
Reddit上一位开发者公开了他搭建的模拟交易平台 Quantradin 的运行数据。这个平台带有一个 MCP 服务器,允许用户把自己常用的 AI Agent(主要是 Claude)接进来,测试交易规则、运行机器人。整个环境不涉及真实资金。
他统计了从某年10月1日起、除一个异常账户外其余23个账户的全部421次调用。这份审计表最有意思的地方,不在于AI有多激进,而恰恰在于它有多克制。
MCP(Model Context Protocol) 是由 Anthropic 提出的一种开放协议,用于标准化 AI 模型与外部工具、数据源之间的连接方式。可以将它理解为 AI 应用的"工具接口层":服务器端暴露一组带有描述的工具(如"提交回测""设置风控限制"),Agent 端则根据这些描述决定是否、何时调用。与传统的函数调用不同,MCP 强调工具描述本身即为模型提供上下文,模型据此推断工具的用途、参数与权限边界。这解释了文中反复出现的一个论点——工具描述不只是文档,而是实际参与行为决策的隐式约束。MCP 服务器因此成为观察 Agent 行为的天然审计点:每一次调用都对应一次模型基于工具描述做出的选择。
数据全景:测试与部署的比例悬殊
先看这23个账户在五周内的行为分布:
- 提交回测:239次
- 设置风控限制(单笔上限、最大持仓、单日亏损、总敞口):41次
- 暂停机器人:40次
- Alpha回测/信号/挂载:71次
- 部署预览:9次
- 部署机器人:14次
- 退役机器人或切换模式:5次
- 手动下单:2次
合计421次调用,零次被拒绝。开发者特意排除了一个做了630次回测、除此之外什么都没干的账户,因为它会淹没整体分布。
回测与部署的比例说明什么
平均下来,每部署一个机器人之前,Agent会先跑大约17次回测。这个比例是整张表里最值得玩味的地方。开发者自己的预期是:Agent应该是交易台上最容易冲动的那一环。结果恰恰相反。
这或许说明,当Agent被明确告知"这里有回测工具、有风控参数、有部署预览"时,它会优先使用这些"先验证再动手"的能力。工具描述塑造了Agent的行为路径。
回测(backtesting) 指用历史行情数据重放某一交易策略,以评估其收益、回撤与风险特征。在量化交易流程中,回测是部署前的标准验证环节,但其本身不产生任何真实或模拟持仓副作用。本文中"部署前平均跑约17次回测"之所以有意义,正是因为回测属于低副作用、高信息量的工具——Agent 反复调用它,意味着在采取有副作用的动作(部署机器人、手动下单)之前,倾向于先通过低成本手段积累证据。与之相对,部署预览是一种"干跑"机制,展示机器人将如何运行但不真正启动,同样属于降低执行风险的中间步骤。理解这些工具的成本-副作用差异,才能读懂调用分布背后的行为逻辑。
后退一步的工具,和向前一步一样常用
更反直觉的是风控类工具的使用频率。40次暂停机器人、41次设置风控限制,对比之下只有14次部署和2次手动下单。
从总量看,"踩刹车"和"踩油门"几乎一样频繁。但开发者提醒,这个数字高度集中:一个账户贡献了40次暂停中的31次,另一个账户贡献了41次风控调整中的29次。
换句话说,这不是一个普遍趋势,而是两个谨慎用户的行为特征。如果去掉这两个账户,所谓"Agent很克制"的结论就会大幅削弱。这是解读这份数据时必须保留的边界。
零拒绝背后的日志盲区
开发者自己表示,最不敢信任的数字就是"零拒绝"。
平台上存在只读密钥:可以查看、暂停、平仓,但不能开新仓或启动机器人。五周内没有任何一个账户撞上这堵墙。这有两种可能:
一是Agent阅读了工具描述,理解了权限边界,从未尝试越界;二是持有只读密钥的用户本身就没有提出过更高权限的需求。
单从审计表无法区分这两种情况。开发者承认这是自己这边的日志缺口——因为系统只记录到达服务器的调用,不记录Agent"读了工具描述后决定不去尝试"的行为。
给MCP服务器运营者的真问题
他在帖子最后抛出一个问题:如果你运营的MCP服务器能够改变某些真实(或模拟真实)的东西,你会记录那些因为工具描述而被Agent主动放弃的调用,还是只记录真正到达服务器的调用?
这个问题触及了Agent可观测性的核心。工具描述本身就是一种隐式的策略约束,它在调用发生之前就过滤了行为。如果日志只记录显式调用,你看到的永远是"Agent做了什么",而看不到"Agent被什么规则劝退了"。对于需要审计的高风险场景,这个盲区可能比任何一次越权尝试都更值得关注。
只读密钥(read-only key) 是权限系统中的一种凭证类型,持有者可以查询状态、暂停机器人、平仓,但无法开新仓或启动新机器人。这类设计遵循最小权限原则,目的是在授予观察能力的同时限制副作用。文中"零拒绝"之所以不可信,在于审计表只记录了到达服务器的调用:如果 Agent 读取工具描述后判断自己无权开仓而根本没有发起请求,这一决策过程不会留下任何日志。换言之,权限系统的有效性存在两种验证路径——被动验证(记录了被拒绝的越权尝试)和主动验证(Agent 因描述而自我约束),而后者在当前日志体系下不可观测。对于高风险场景,这种"未发生的调用"的缺失,使得"零拒绝"既可能意味着系统安全,也可能意味着系统从未被真正测试。
对Agent落地的几点启示
这份数据样本不大,只有23个账户、五周时间,但它提供了一个少见的观察窗口:真实用户如何把Agent接入一个带副作用的工具系统,以及Agent在其中有怎样的行为模式。
几个可以带走的判断:第一,丰富的工具接口会引导Agent走向"多验证、少执行"的路径,前提是这些工具被清晰描述;第二,个体差异远大于整体趋势,少数谨慎用户会主导统计结果;第三,日志设计需要同时覆盖"被阻止的调用"和"从未发起的调用",否则权限系统的有效性无法被验证。
对于正在搭建MCP服务器或类似Agent工具平台的团队,这份审计表的价值不在于那些漂亮的比例,而在于它诚实地标注了自己的盲区。
相关推荐

Agent Clan:用隔空手势同时指挥多个AI编程助手
Agent Clan 将 Claude Code 和 Codex 代理变成屏幕上的3D团队,支持握拳召唤、捏选、左右拖拽审批权限,手势与语音本地运行,Mac和Windows免费使用。

Inkling 2 Small:会“看”也会改的594B MoE模型
Thinking Machines Lab 发布 Inkling 2 Small,594B 参数 MoE 模型仅激活 17B,主打能看见并优化自身产出的长周期编程与视觉任务,通过 Tinker 平台提供推理和微调。

Sage2:实时语音转结构化数据,开发者API新选择
Levanto Labs 推出 Sage2 API,可将实时语音转化为结构化数据,支持流式决策跟踪用户意图,适用于客服、语音助手等场景。Product Hunt 获 99 票。