240亿只动24.5亿:32G笔记本本地跑AI智能体,快1.7倍还开源

MIT系团队开源240亿参数MoE模型2.5-24,主打32G笔记本可跑的本地智能体。
麻省理工系背景团队发布开源模型 2.5-24,采用混合专家架构,总参数 240 亿但每生成一个字仅激活 24.5 亿(64 选 4),四量化版体积 13.5G,32G 内存笔记本即可运行。它并非为聊天设计,而是专攻本地智能体。官方 16 项基准中,自动化任务跑分 27.69 对第二名 8.72 领先约 3.2 倍,工具沙箱 80.71 排第一,指令遵循三项全部第一,速度达每秒 184 字。硬核科学、复杂代码与完全自主网页操作是其明确让出的短板。对个人和小团队的价值集中在省钱、隐私、随时可写三点,权重免费下载,数据不出本机。
本地跑 AI 智能体一直有个尴尬的前提:要么模型够小、能力拉胯,要么模型够强、显存直接爆炸。麻省理工系背景的 AI 公司议会(原文如此)最近发布的开源模型 2.5-24,试图在这个矛盾里切出一条新路——总参数 240 亿,但每生成一个字只激活 24.5 亿参数,一台 32G 内存的普通笔记本就能跑,而且它压根不是为聊天设计的,而是专门冲着本地智能体来的。
为什么 240 亿的模型能跑在笔记本上
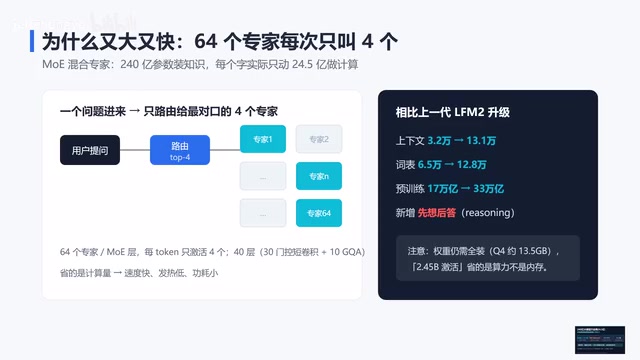
答案藏在混合专家架构(MoE)里。你可以把它想象成一个 64 人的专家团队,而不是一个什么都懂的全科老师。每次你提出问题,系统只把问题路由给最对口的四位专家来回答,其余专家按兵不动。
于是模型肚子里装着 240 亿参数的完整知识,但每个字真正参与计算的只有一小块。这就是「240 亿知识、24.5 亿干活」的由来。对本地部署来说,这个设计直接决定了显存和内存占用能不能压进消费级硬件。
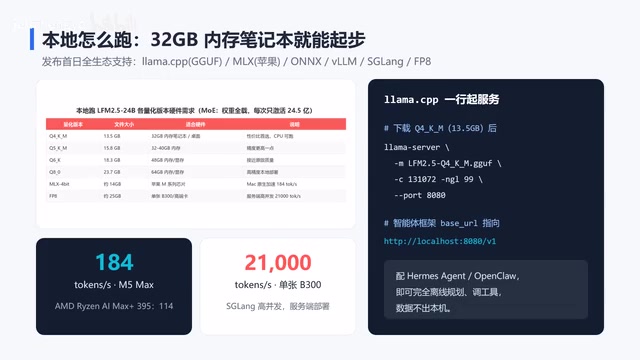
官方给出的量化版本也印证了这点:性价比首选的四量化版体积 13.5G,32G 内存笔记本即可运行;6 版本约 18.3G,需要 48G 内存。换句话说,多数近两年的中高端轻薄本已经具备入场资格。
混合专家架构(MoE)的核心机制
MoE 的本质是把一个稠密大模型拆成若干「专家」子网络,再配一个轻量的门控网络(router)决定每个 token 走哪几个专家。传统稠密模型每生成一个字都要过一遍全部参数,计算量随参数量线性增长;MoE 则把「知识容量」和「单次计算量」解耦——总参数决定模型能记住多少,激活参数决定每次推理的开销。这也是为什么 240 亿总参数的模型能把单字计算压到 24.5 亿量级。
代价同样存在。首先,所有专家权重仍需驻留内存,所以显存/内存占用看的是总参数而非激活参数;其次,路由本身会引入额外的调度开销,且若训练不充分,token 可能被分配给并不擅长的专家,导致长链路任务上表现波动。业界常见的改进包括负载均衡损失、专家容量上限、共享专家等,目的都是让路由更稳。理解这一点,就能明白文中提到的「MoE 路由在长链路任务里是否稳定」为何是一个真实的未知数。
跑分里真正值得看的几项
这类模型最容易让人误判的地方在于「总跑分」——它并不追求样样第一。真正你可能没注意到它在智能体和工具调用方向上的碾压幅度。
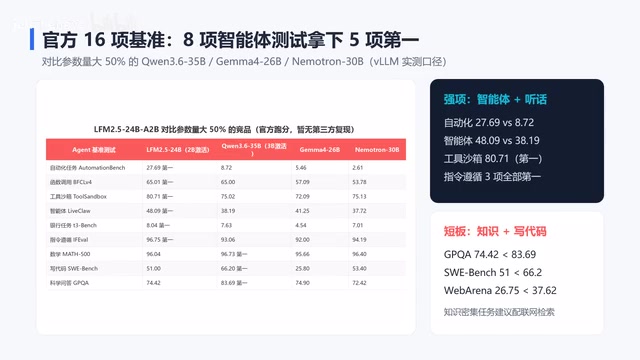
官方公布的 16 项基准测试中,自动化任务跑分 27.69,第二名只有 8.72,领先约 3.2 倍;智能体实测 48.09 对 38.19;工具沙箱 80.71 直接排到第一;指令遵循的三项测试全部拿下第一。这些数据指向同一个结论:它在「听指令、调工具、多步执行」这条链路上是认真的。
速度方面,官方给出的数字是每秒 184 字。这个量级意味着即使是纯推理模型——每次回答前先写一段思考列确认逻辑,再给最终答案——用户也不会明显感到卡顿。多想一想,但没慢到影响体验。
量化与位宽:为什么 13.5G 能装下 240 亿参数
原始 FP16 精度下,240 亿参数约需 48GB 显存,普通笔记本根本放不下。量化就是把每个权重从 16 位浮点压缩到更低位宽:4-bit 量化理论上把体积压到约 1/4,因此文中「四量化版 13.5G、6 版本约 18.3G」符合这一规律。位宽越低,模型占用越小、推理越快,但精度损失也越大,表现为复杂推理、长输出时更容易出错或重复。
实际部署时还需为 KV 缓存(保存上下文键值对)留出内存,上下文越长占用越大,所以 32G 内存跑 13.5G 权重并非余量充足。选择量化版本时,通常建议先用 4-bit 试跑,若发现指令遵循或工具调用出错率上升,再退回 6-bit 或 8-bit 权衡。这也是评估本地智能体是否「够用」时,比跑分更需要实测的一环。
它让出了什么,又赢在哪
把 2.5-24 当成全能冠军会失望。硬核科学问答、复杂代码、完全自主的网页操作,这几项它并不占优,是明确让出去的地盘。
它赢的地方很集中:会调工具、能做多步执行、听指令不跑偏、数学持平,而且每次推理的成本极低。这恰好就是本地智能体最核心的技能树——自动搜资料、读文件、跑命令、操作网页,这些任务不需要模型无所不知,但需要它稳定、少跑偏、别乱花钱。
定位因此很清楚:它不是要跟前沿大模型拼谁更博学,而是本地智能体这个细分场景里的专用选手。
对个人和小团队最实在的三件事
发布第一天,这个模型就拿满了生态支持:苹果芯片、跨平台、服务端都有对应文件,落地门槛被压得很低。
对个人和小团队来说,价值不在跑分榜,而在三件很具体的事。
省钱。 权重免费下载,一次性装进本地显存之后反复调用都不用再交二次费用。嫌本地麻烦也有云接口,输入每百万 token 只要一毛钱美元量级,比多数闭源 API 便宜不少。
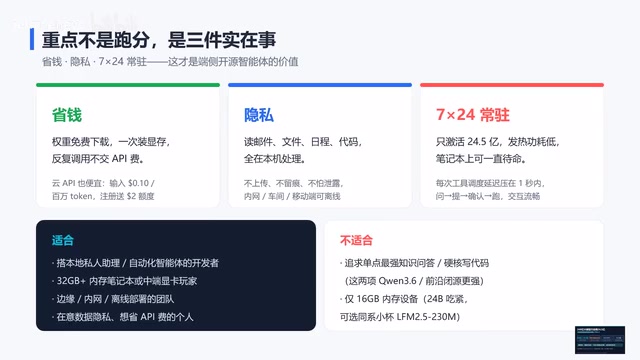
隐私。 智能体要读你的邮件、文件、日程和代码,这些数据一旦上云就脱离了你的控制。本地跑意味着数据不出本机。
随时可写。 智能体场景往往是高频、碎片化的调用,本地常驻的模型不用排队、不用等额度,写完就用。
工具调用(Function Calling)与智能体循环
智能体之所以区别于聊天机器人,关键在于它能把模型输出转成真实动作。典型流程是:模型根据用户目标决定调用哪个工具(搜索、读文件、执行命令、操作网页),以结构化格式返回调用参数,外部程序执行后再把结果喂回模型,如此循环多步直到任务完成。这条链路对模型的要求不是「知识多」,而是「按格式输出、不臆造参数、能根据返回结果调整下一步」。
因此工具沙箱跑分、指令遵循测试往往比通用知识跑分更能预测智能体的真实表现。工具调用失败通常来自三类问题:格式不合规、参数编造、以及多步之后偏离原目标。文中强调 2.5-24 在「听指令、调工具、多步执行」上领先,正是针对这些痛点的优化方向,但官方数据仍需第三方在真实工具集上复现验证。
本地智能体的一个新基准
2.5-24 给本地智能体这条赛道交了一份清晰的答卷:240 亿知识、24.5 亿干活、32G 内存能跑、每秒 184 字、自动化跑分领先第二名 3.2 倍,且免费开源、数据不出本机。
它当然不是通用能力的终点,MoE 路由在长链路任务里是否稳定、真实场景下的工具调用成功率能否复现官方数据,都还需要更多第三方验证。但至少它证明了一件事——在「便宜、私密、随时在线」这个三角里,本地智能体终于有了一个不必将就的起点。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。