27B稠密模型登顶HF:16G显存跑出前沿级能力
杭州出品的27B稠密模型凭借16G显存可跑的「智能密度」登顶Hugging Face历史点赞榜
一款来自杭州、参数量仅27B的稠密开源模型登顶了Hugging Face历史点赞榜,超越了参数量大得多的旗舰竞争对手。其核心优势在于「智能密度」:四位量化后仅需16-18G显存,单张消费级4090即可本地运行。文章厘清了一个常见误区——MoE架构省的是算力而非显存,稠密模型才是真正意义上的「小而能装进单卡」。跑分方面,该模型在多步Agentic任务(SWE Bench、OS World)上表现突出,第三方评测与云端前沿模型低档相当,但推理速度明显更慢、纯知识推理优势有限。登顶的深层逻辑是:旗舰版采用自定义许可无法自由本地部署,而这个27B版本能下载、能改、能商用,真正兑现了开源的实用价值,对数据合规和成本敏感的团队吸引力尤为突出。
一个27B模型改写了开源排行榜
Hugging Face历史上点赞最多的开源模型换人了。登顶的不是2.4万亿参数的旗舰怪兽,而是一个来自杭州、体量仅27B的稠密模型——量化之后大约16G显存就能跑,一张4090就装得下。
B站UP主崔浩在最新一期视频中拆解了这个现象:这款模型拿下约15100个赞,超过了FLUX.1(约14700)和Kimi K系列的对手。前一周它还是第二名,一周内多涨866个赞,下载量增加128万次,直接翻上第一。
更关键的是它的成长曲线。开源不到12小时冲进HF历史榜前四,两天破100万次下载,社区自发贡献了约500个量化版本,HF甚至提前开了个倒计时页面。海外社区给它起了个绰号——「本地版Opus」。
凭什么是它?答案叫「智能密度」
过去两年,开源圈的默认剧本是追参数:70B、400B、671B,数字越大越有面子。但参数大有个致命问题——你得有地方放它。一个400B模型量化后也要两三百G显存,普通开发者手里那台4090连门都进不去,最后只能回头去调云端API。
这里有个特别容易踩的误区:很多人以为MoE(混合专家)架构省的是显存。实际上MoE省的是算力,不是显存。每次推理只激活一小部分参数,但权重得全部加载进内存,显存仍然按总参数算。
而这款模型是**稠密(Dense)**架构的27B:FP16需要54G,FP8需要28G,四位量化大概16到18G。一张3090或4090就能舒服地跑起来。
崔浩打了个比方:以前大家默认顶配才靠谱,V8、四驱全上;但每天通勤的人会发现,中配那台车油耗低、停车方便,该超车照样超车——你多花的钱买的是一年用不上两次的马力。27B稠密模型,就是这个「中配」。
MoE(Mixture of Experts,混合专家)架构的工作原理是将模型拆分成多个"专家"子网络,每次推理时由一个门控机制只激活其中少数几个专家。以DeepSeek V3为例,总参数671B,但每次前向推理只激活约37B,理论算力消耗大幅下降。然而,所有专家的权重必须同时驻留在显存中以备调用,因此显存占用仍按总参数规模计算。这就是671B MoE模型量化后仍需数百G显存的根本原因。稠密模型则没有这层区分——每个参数在每次推理中都会参与计算,结构更简单,推理延迟更可预测,也更容易在单卡或双卡消费级GPU上完整加载。
中配能干多少活?跑分说话
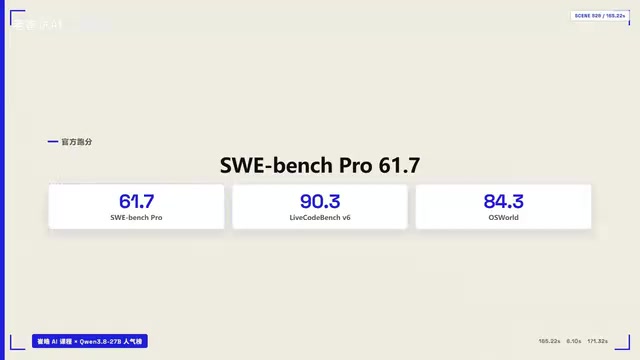
官方公布的跑分显示,这款模型在多步任务上表现突出:
- SWE Bench Pro:61.7
- LiveCode Bench V6:90.3
- OS World:84.3
与上一代同尺寸模型相比,Deep SWE项从13.3涨到42.2,进步幅度惊人。在官方对比表里,它在SWE Bench Pro、LiveCode Bench、OS World上领先Claude Opus级别的最高档,但在Terminal Bench和GPQA Diamond上落后。
换句话说,它不是全面碾压,而是多步任务(Agentic)特别猛,纯知识和纯推理只动了一点点。
第三方验证也跟上了。Artificial Analysis给的综合分与GPT-5级别的最高推理档相当,而后者只能走云端。在Agentic Index上它拿到51分,超过了Claude Opus的最高推理档。做AI编程工具的团队直接评价:这是第一次有本地模型达到前沿级能力。
更实在的是法律场景验证——Harvey和Engram搭了个合成律所,250个法律任务平均67分,高于该研究里所有参评模型。
SWE-Bench是评估模型解决真实GitHub软件工程问题能力的基准测试,任务要求模型阅读issue描述后自主修改代码库、生成可通过测试的补丁,被广泛视为衡量Agentic编程能力的金标准。OS World则测量模型在模拟操作系统环境中完成多步桌面任务的成功率,涵盖文件操作、应用交互等场景,是评估"本地智能体"实用性的重要指标。LiveCode Bench侧重动态更新的竞赛级编程题,能有效防止模型通过记忆历史题目刷高分。这三项基准共同指向同一类能力:需要多轮规划、工具调用和自我纠错的复杂任务,而非单轮问答或静态知识检索。
几件必须说清楚的事
跑分好看,但崔浩也如实点出了几个需要冷静看待的地方。
第一,跑分大多是厂商自爆。 环境和配置可能与你的实际情况不同。那个第三方综合分是打平云端模型的低档,不是高档。截至评测时它还没有独立的MMLU或Arena排名。
第二,它明显更慢。 有独立评测发现,相比上一代,它每个任务消耗更多token,本地吞吐大概9到22 token每秒,开启思考模式还会更慢。你省下的是API账单,付出的是时间。
第三,人气榜衡量的是热度,不是绝对能力。 FLUX.1是图像模型、DeepSeek R1是推理模型,本来就不在一个赛道。这个榜真正说明的只有一件事:开发者愿意用它。
登顶背后是一条累积曲线
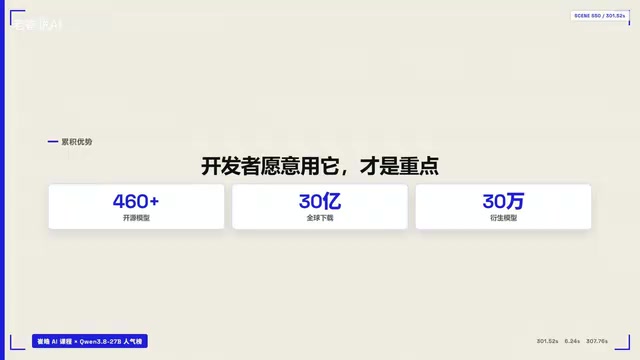
把镜头拉远,这次登顶更像一个累积结果。据视频统计,阿里累积开源了460多款模型,全球下载量突破30亿次,衍生模型超过30万个。仅2026年前7个月,其模型在Hugging Face被下载约20.45亿次,是Google的4.9倍、Meta的9倍。
选型也在变化:开源不到一个月,Perplexity就把它选为本地agent的首选模型;更早之前,路透社、Airbnb、Pinterest也陆续转向。
还有个耐人寻味的细节:这次登顶的不是那个2.4万亿参数的旗舰版。因为旗舰用的是自定义分层许可,不能自由本地部署;而这个27B小模型能下载、能改、能商用,反而成了历史第一。
量化(Quantization)是让大模型在消费级硬件上可用的关键技术:通过降低权重的数值精度——从FP32、FP16压缩到INT8、INT4甚至更低——成倍减少显存占用和带宽需求,代价是轻微的精度损失。社区自发贡献约500个量化版本这一数字,折射出围绕开源模型已形成的完整生态:从GGUF格式的llama.cpp版本、适配AWQ/GPTQ的GPU加速版,到专为树莓派或苹果芯片优化的极低比特版本,不同场景的用户各取所需。这种社区分发机制是闭源云端API根本无法复制的:每个量化版本都是有人在自己机器上实测后打包上传,隐性的可靠性筛选已经发生在你下载之前。
真正的主角是「智能密度」
所以这条新闻真正的主角,不是「谁家第一」,而是「智能密度」这条线。
过去两年开源圈默认追参数、追跑分,这次赢的是把能力压进16G显存的方案。如果你的机器跑得动,这件事对你是实实在在的:你手里多了一个不依赖任何云端API的选项,数据留在自己机房,账单不按token走。
对于注重数据合规、想控制推理成本的团队,这两点在未来一年只会越来越值钱。
相关推荐
内心声音的双刃剑:心理学家Ethan Kross谈如何驾驭"心理噪音"
密歇根大学心理学家Ethan Kross在Google对谈中解析"内心声音"的双重性:它既是人类超能力,也会演变为反复空转的心理噪音chatter。文章梳理其大脑研究、疏离自我对话、有效倾诉与信念重构等实用工具。
国家地理《Super Scam Me》:一场揭露杀猪盘骗局的卧底实验
国家地理纪录片《Super Scam Me》通过卧底实验揭露杀猪盘(Romance Scam)骗局,展示骗子雷同的军官/商人人设、比特币ATM收割手法,并追踪操盘者。每七名成年人中就有一人受害,这是一场直面诈骗真相的调查实验。
古埃及人为何放弃金字塔?考古学揭开千年谜团
国家地理纪录片《失落的埃及宝藏》揭示古埃及人为何放弃金字塔:从萨卡拉的建筑革命到南方省长的崛起、铜矿经济的崩溃,再到帝王谷的隐藏陵墓,考古学家层层揭开这场"金字塔之死"的千年谜团。