284B大模型跑进MacBook:DeepSeek本地推理的真实突破与门槛

一件"不该发生"的事发生了
一个2840亿参数的模型,刚刚在一台你能在苹果商店买到的MacBook Pro上跑了起来——不是云服务器,不是数据中心机架,而是一台笔记本电脑。Redis的创始人Salvatore Sanfilippo构建了一个纯C语言引擎,将DeepSeek广告的完整前沿模型压缩到76GB,并以每秒约26个Token的速度实现本地推理。
这件事之所以引人注目,在于它同时击穿了三个长期存在的假设:前沿规模的参数必须依赖云端GPU集群;开源权重的中国模型只是预算替代品;本地推理只是爱好者的玩具。而这一切,来自一个模型和一个由单人构建的引擎。
本文将梳理这次突破背后的技术逻辑、社区反应,以及那些被宣传掩盖的现实门槛。
两件接连发生的事
故事的第一部分:DeepSeek发布了V4 Flash,一个拥有2840亿参数、采用开源权重与MIT许可证的模型。这意味着你可以下载、运行,甚至在此基础上发布产品,无需任何额外授权。
关键在于它的架构——混合专家模型(MoE)。简单来说,大模型被分割成许多更小、更专业的子网络("专家")。对于任何给定的Token,路由层只会激活其中少数几个专家。所以模型总参数量高达2840亿,但每个Token实际参与计算的只有约130亿参数。
MoE架构的理论根源可追溯至1991年Jacobs等人提出的混合专家系统(Mixture of Experts),彼时主要应用于浅层机器学习模型的集成学习框架。在大语言模型时代,Google的Switch Transformer(2021年)将其重新带入主流,证明了万亿参数级稀疏模型的可行性。其核心机制是"条件计算"(Conditional Computation):由一个可学习的路由网络(Router)在每个前向传播步骤中动态决定激活哪些专家子网络,而非让全部参数参与每次计算。这一机制的深层价值在于打破了"参数量=计算量"的线性约束——模型可以通过增加专家数量来扩展知识容量,而推理成本几乎不随之线性增长。
DeepSeek V4的MoE实现在此基础上引入了两项关键创新:细粒度专家分组(Fine-grained Expert Segmentation)将每个专家拆分得更小但数量更多,提升了路由的表达精度;共享专家机制(Shared Expert)则保留一部分专家始终参与计算,负责捕获跨领域的通用知识,避免纯稀疏路由导致的知识碎片化问题。这两项改进使稀疏激活的模型在参数总量不变的前提下,显著提升了路由决策的质量。对比采用稠密架构的同级模型,MoE在推理阶段的理论浮点计算量可减少5到10倍——这正是本地部署成为可能的根本原因。
这就是整个故事的技术支点:你获得了大模型的知识广度,却只需支付小模型的计算成本。
第二部分在两周内到来。Sanfilippo发布了名为DS4(Dwarf Star 4)的推理引擎,纯C语言编写,专为在128GB统一内存机器上本地运行DeepSeek V4 Flash而构建。一台MacBook Pro M3 Max,或NVIDIA的DGX Spark,即可胜任——无需云端,无需API密钥,无需GPU集群。
MacBook Pro M3 Max能够胜任这项任务,根本原因在于苹果M系列芯片的统一内存架构(Unified Memory Architecture,UMA)。传统PC平台中,CPU内存(DRAM)与GPU显存(VRAM)是物理隔离的两套子系统,消费级GPU的显存上限通常仅为24GB(如RTX 4090),且CPU与GPU之间的数据传输受PCIe 4.0 x16约64GB/s的双向带宽严重制约。当模型权重无法完整装入GPU显存时,系统不得不在内存与显存之间反复调度数据,推理速度将因IO瓶颈急剧下降。
苹果UMA将CPU核心、GPU核心、神经网络引擎(Neural Engine)以及内存控制器统一集成在同一片SoC上,共同接入同一内存池。128GB配置意味着GPU计算单元可以直接寻址全部内存空间,无需跨总线数据搬运,实测内存带宽高达400GB/s——远超PCIe的传输瓶颈。这使76GB的量化模型权重可以完整驻留在GPU可访问的内存中,推理时仅受限于内存带宽而非数据调度延迟。值得注意的是,这一架构优势并非苹果专属:高带宽内存(HBM)技术同样通过将内存堆叠在处理器基底上消除了类似瓶颈,这也是A100和H100 GPU能够支撑大模型推理的核心原因——只不过其造价远超消费级产品。要在传统x86平台实现同等效果,需要多块A100(80GB显存)或H100 GPU通过NVLink互联——造价数十万美元,这正是NVIDIA DGX Spark存在的商业逻辑。
该项目在约一个月内收获超过13000个GitHub星标。连llama.cpp的作者Georgi Gurganov都注意到了它,Y Combinator的CEO同样关注。当构建标准工具的人和资助初创公司的人都停下来观望时,说明真有什么不寻常的事情发生了。
非对称量化:把比特花在刀刃上
真正的工程难点在于内存。2840亿参数的模型在全精度下需要约半TB内存,没有任何笔记本能装得下。因此必须量化——用更少的比特存储每个权重,从16位降到4位,模型体积可缩小约4倍。
模型量化本质上是将浮点权重映射到低比特整数表示的有损压缩过程,其目标是在最小化精度损失的前提下最大化压缩比。理解这一过程需要区分两类截然不同的量化对象:权重量化针对模型参数本身,这些参数在推理时是静态的,可以离线精心分析;激活量化则针对推理过程中的中间计算值,这些值依赖输入数据动态变化,难度更高。
早期的训练后量化(Post-Training Quantization,PTQ)方法以INT8为主要目标,通过校准数据集统计激活值分布来确定量化参数。随着大模型规模的膨胀,工程界开始向INT4进发:2023年由Tim Dettmers等人提出的GPTQ算法,利用二阶海森矩阵信息逐层最小化量化误差,成为离线量化的主流工业方法,被Hugging Face的AutoGPTQ库广泛实现。随后QuIP#算法引入"不相关处理"(Incoherence Processing)与向量量化,将INT4的质量极限进一步下压;AQLM则将加法量化码书(Additive Quantization Lookup Table)引入权重压缩,在极低比特数下取得了更优的率失真表现。
DS4采用的二位精度(2-bit)量化处于目前学术界和工程界的极限挑战区间——大多数研究表明2-bit全局量化会导致显著的能力退化。DS4的关键洞察与信息论中的率失真理论(Rate-Distortion Theory)高度吻合:在容忍一定失真的前提下,最优编码策略应将有限的比特预算集中分配给信息密度最高的部分,而非均匀摊薄。
但压缩是有代价的:量化太激进,模型就会退化,开始产生幻觉、陷入循环、丢失指令跟随能力。常规做法是统一量化所有层,然后接受相应的质量损失。
Sanfilippo没有这么做。他采用了非对称量化策略:分析模型结构,判断哪些部分可以被激进压缩而仍能保持性能,哪些不能。
- 专家层(2840亿参数的主体)被压缩到极端的二位精度
- 路由层、共享专家、投影层则保持完整的八位精度
逻辑清晰:专家数量众多且冗余,每个Token只调用其中几个,损失单个专家的精度是可以承受的。但路由层没有备份——路由器一旦出错,调用了错误的专家,下游每个答案都会偏差,无论专家本身多精确。这一策略的深层洞察在于,MoE架构本身提供了一种天然的冗余缓冲:即便某个专家的权重因2-bit量化而失真,路由器在有足够多可选专家的情况下,仍有机会找到在当前问题上质量足够高的专家组合。这与传统稠密模型的量化逻辑根本不同——稠密模型中每个参数都参与每次计算,无处可"借力"。
换句话说,在关键路径上花比特,在冗余路径上省比特。 最终模型约占用76GB,在128GB的MacBook Pro M3 Max上,独立评测显示生成速度达每秒26.68个Token——已是流畅的交互体验,超过人类阅读速度。一个前沿规模的模型,在你的桌面上、用电池供电,实时回答问题。
正确性优先,还是灵活性优先?
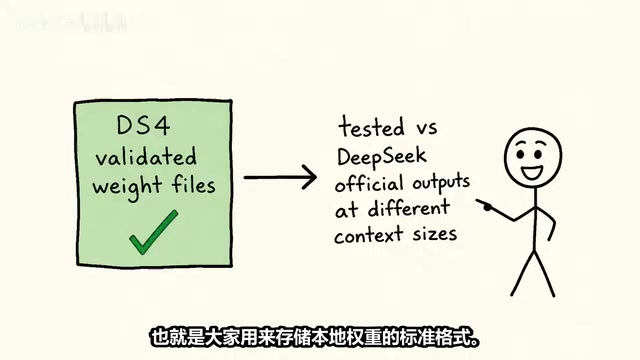
DS4的设计哲学在社区中引发了分歧。它不是通用工具:不能运行任意模型,不加载任意GGUF文件(本地权重的通用标准格式)。它自带经过严格验证的权重文件,这些文件已与DeepSeek官方输出在不同上下文长度下逐一比对。它只运行这些文件,别的都不支持。
GGUF(GPT-Generated Unified Format)是llama.cpp项目于2023年8月引入的权重存储格式,取代了早期的GGML格式,后者因架构元数据不完整、版本兼容性差而饱受诟病。GGUF的核心设计目标是自描述性(Self-describing):单个文件通过头部键值对(Key-Value Header)完整内嵌模型架构信息(层数、注意力头数、上下文长度)、分词器词表(Tokenizer Vocabulary)、量化方案参数以及所有张量数据,任何兼容工具无需外部配置文件即可正确加载并推理。这种设计哲学与容器镜像(Container Image)有异曲同工之妙:将所有依赖打包进单一可分发单元,消除"在我的机器上能跑"的环境差异问题。
这种"一文件即完整系统"的设计极大降低了分发和部署门槛。GGUF的广泛采用催生了一个庞大的本地推理生态系统:Ollama以容器化思路封装GGUF模型分发;LM Studio提供图形化前端,面向非技术用户;Jan则主打隐私优先的本地对话界面。Hugging Face上目前托管着数以万计由社区贡献的GGUF量化版本,几乎覆盖了所有主流开源模型。DS4刻意不支持GGUF,意味着主动与这整套生态割席——这一决策折射出软件工程史上反复出现的根本性张力:拥抱互操作性以换取长尾生态的规模效应,还是通过垂直整合换取可验证的确定性行为?从Unix的模块化哲学到苹果的封闭花园,这道选择题从未有过唯一正确答案。
批评者称此为"锁定"(lock-in)。本地AI生态已有一堆工具和格式相互缠绕,再冒出一个热门项目拒绝兼容任何现有标准,这个抱怨有其道理。
但Sanfilippo的反驳更为尖锐:本地推理多年来停留在爱好阶段,正是因为"运行一切"的模式。你可以用任意后端、任意量化方式加载任意模型,但没人能保证输出质量——质量本身是未定义的,用户只能靠猜。
通过掌控整个推理管道——一个模型、一组验证过的量化参数、一个引擎——DS4实际上可以保证它如声称的那样工作。这就是玩具工具和可投入生产的系统之间的本质区别:刻意选择正确性,放弃灵活性。
而且DS4并非简单封装:它自带HTTP API,支持工具调用,内置编码智能体,还有磁盘持久化的KV缓存——模型对对话的工作记忆可以跨会话保存。合上笔记本,第二天回来,上下文依然完整。
KV缓存(Key-Value Cache)是Transformer架构推理优化的核心机制,其原理植根于自注意力(Self-Attention)的计算结构。在自回归生成过程中,模型每生成一个新Token,都需要计算它与所有历史Token的注意力权重——这要求访问历史序列中每个位置的Key矩阵和Value矩阵。朴素实现中,这些矩阵会在每步生成时重复计算,导致计算复杂度与序列长度的平方成正比。KV缓存通过将已计算的Key-Value对存入内存缓冲区,将增量生成的复杂度从O(n²)降至O(n),是将实际推理速度提升数倍乃至数十倍的关键工程手段。从内存消耗的角度看,KV缓存本身并不"免费":对于长上下文场景(如128K Token),KV缓存的内存占用可能超过模型权重本身,这也是为什么内存带宽而非计算能力往往成为长上下文推理的真正瓶颈。
标准实现中,KV缓存是纯粹的内存数据结构,与推理进程的生命周期绑定,进程退出缓存即销毁。DS4的磁盘持久化方案需要解决若干非平凡工程问题:如何高效序列化大规模张量数据以减少写入延迟;如何在模型版本更新时处理缓存失效;以及如何验证跨会话加载的缓存与当前模型权重的一致性,避免因量化参数变更引入静默错误。对于需要长期追踪项目背景的编程智能体(Coding Agent)场景,持久化KV缓存可省去每次新会话重新"喂入"全部上下文的Token计算成本;对于128K乃至更长的上下文窗口,这代表着在推理时间和API等效成本上均可观的节省。
这些细节表明,这是一个认真的工程师为实际生产使用而构建的产品。
从"备用方案"到"首选工具"
最值得关注的数字,不是某个基准分数,而是Sanfilippo自己的一句话:他玩本地模型多年,这却是他第一次发现自己会用本地模型做严肃工作——那种他通常交给Claude的任务。
本地模型长期以来是"当无法使用好模型时的备用方案"。而现在,差距已经缩小到让本地模型成为真实任务的首选:在自己的硬件上运行、零API账单、数据不离开本机。
社区里能看到同样的能量涌动:一位日本工程师花12天从DGX Spark中榨取极限性能;NVIDIA论坛上有贡献者当天就将自定义量化方案移植到CUDA;Metal、CUDA和AMD ROCm的分支都在数周内活跃起来。这不是炒作,而是构建者因为"东西真的有效"而自发涌现的行动。
本地推理的底层计算后端竞争,折射出整个GPU生态的更大格局。NVIDIA的CUDA(Compute Unified Device Architecture)凭借自2007年起十余年的生态积累,在AI计算领域建立了近乎垄断的地位:cuBLAS提供高度优化的矩阵运算算子库,cuDNN针对神经网络的卷积、归一化等操作深度调优,NCCL实现多GPU通信,PyTorch、TensorFlow等主流框架的GPU后端均以CUDA为第一梯队。CUDA的护城河不仅在于技术本身,更在于庞大的算法研究社区——几乎所有发表在顶级会议的深度学习论文都首先在CUDA上实现和验证,这形成了技术积累与生态规模之间的强正反馈循环。
AMD的ROCm(Radeon Open Compute Platform)是由AMD主导的开源GPU计算生态替代方案,其核心是HIP(Heterogeneous-compute Interface for Portability)编程接口——HIP代码可同时编译为CUDA后端和AMD原生后端,极大降低了代码移植成本。ROCm近年在PyTorch适配上取得显著进展,MI300X加速卡的单卡192GB显存已使其在大模型推理场景颇具竞争力,但在算子覆盖完整性、数值精度一致性和社区生态广度上仍落后于CUDA。Apple的Metal Performance Shaders(MPS)则是专为苹果芯片GPU优化的高性能计算框架,llama.cpp社区已通过Metal后端在M系列芯片上实现了与CUDA相近的推理效率,为DS4的苹果平台性能提供了底层支撑。
若ROCm后端在DS4中成熟落地,搭载AMD GPU的高内存工作站将进入竞争视野——届时本地推理的硬件民主化才算真正迈出关键一步。
撕掉宣传滤镜:几个必须说清的事实
不过,宣传在几处确实过头了。
硬件门槛真实存在。 它确实在笔记本上运行,但128GB的MacBook Pro M3 Max售价3000到4000美元,DGX Spark是NVIDIA定位"个人AI超级计算机"的高端设备。所谓"普及"是真的,但有一个远高于多数开发者日常配置的价格门槛。这跑不起来的,是你的旧ThinkPad。
量化质量有代价。 把专家层压缩到二位精度不是免费的午餐。将V4 Flash称为"准前沿"(near-frontier)模型,来源于定性印象而非与顶级云模型的严格对照测试。评测者也记录了真实问题:KV缓存的边缘情况、某些量化配置导致的静默性能退化。"准"字的分量不可忽视。
这是Flash模型,不是完整旗舰。 DeepSeek完整的V4 Pro拥有1.6万亿参数,官方文档明确指出它需要极高内存配置,而非笔记本。标题是真实的,但从"可用的本地模型"到"全面取代云端",还有很长的路。前沿模型依然住在数据中心里。
地缘政治风险未解。 DeepSeek是中国实验室,MIT许可证虽然宽松,但训练数据来源和供应链风险的问题依然悬而未决。开放权重解决了数据隐私问题——数据不离开本机——却无法回答地缘政治层面的疑虑。值得补充的是,MIT许可证的宽松仅覆盖权重文件的使用和分发权限,并不对训练数据的版权归属或合规性作出任何承诺;在受监管行业(金融、医疗、法律)将此类模型用于生产环境前,对训练数据来源进行尽职调查仍是不可回避的合规义务。
清除炒作后,真正改变了什么
去掉噪音后,持久的变化是清晰的:三个长期假设在同一个月里被同时击穿。
对构建者而言,行动路径很具体。如果你一直在为Flash级别的工作支付按Token计费的API费用——文本摘要、内容分类、编码智能体循环、内部工具——现在有了一条可信路径:在内部工作站上部署一个可比模型,边际成本归零,数据留在本地。这是一个实打实的成本项,它刚刚发生了变化。
决策逻辑并不复杂:
- 如果你需要绝对顶级的1.6万亿参数级模型,或无法证明硬件投入合理,选择云端;
- 如果你的任务是Flash级别、调用量高到API账单令人心疼、或数据隐私不可谈判,本地部署DS4值得认真评估。
一个月前,这根本还不是一个可选项。
接下来真正值得观察的有两点:CUDA和ROCm后端能否成熟到在更平价的硬件上运行,因为价格门槛才是阻碍大规模普及的真正瓶颈;Sanfilippo的"单一模型、完全可控"路线与Gurganov的"运行一切"路线,谁将在本地推理的下一轮竞争中胜出,目前仍是未解之题。
但问题本身已经变了。以前是"本地推理能否变得严肃",现在是"它变便宜的速度有多快"。
核心要点
相关推荐

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。

Antigravity 2.0 保姆级教程:MCP、Skill与自动化全解析
Antigravity 2.0 保姆级教程,详解项目/会话/Agent 三大核心概念、消息队列与权限设置、自动化任务、MCP 连接 Figma、Skill 专业技能,并演示设计稿转代码、Android 应用生成、产品页 1:1 复刻等 6 个实战案例。