30分钟搭建视觉AI代理:NVIDIA VSS蓝图实战
用NVIDIA VSS Blueprint,一句自然语言提示、26分钟、3美元,搭出能实时检测工厂异常并自动生成报告的视觉AI代理。
本文拆解了一段技术演示:借助NVIDIA VSS Blueprint中的Build Vision Agent技能,开发者只需用自然语言描述需求("告诉我果汁是否流到了瓶子外面"),代理便会自动读取真实接口文档、规划架构、征得用户确认后完成部署。整个系统由两个核心模型分工协作——Cosmos VLM持续观察摄像头画面、实时检测异常,Nemotron负责自动生成事件报告。搭建全程耗时26分钟,消耗约750万tokens,一次性成本约3美元;由于模型运行在本地GPU上,无云端调用,后续每次操作仅需几分钱。文章认为,这一演示的真正意义不在于成本数字,而在于它展示了视觉AI代理从"工程师手写代码"转向"自然语言描述需求、代理自动落地"的工作流转变,为工业场景的大规模部署提供了一条兼顾成本与可控性的务实路径。
当摄像头只会"看"却不会"说"
在一座橙汁工厂里,摄像头遍布每一条产线,它们看得见一切,却什么也告诉不了你。溢出、泄漏、漏装、灌装过量——这些问题随时可能发生,但传统监控只是被动记录,等到有人翻看录像时,损失早已造成。
这正是视觉AI代理(Visual AI Agent)要解决的核心痛点。它不只是"看",还能实时理解画面内容、检测异常、并主动采取行动。这类代理正在工厂、仓库、能源电网乃至城市管理等场景中改变运营方式。本文基于一段YouTube技术演示,拆解如何用NVIDIA VSS Blueprint在半小时内、花费约3美元搭建出一个可用的视觉AI代理。
核心工具:VSS Blueprint 的 Build Vision Agent 技能
整个搭建过程依托于NVIDIA VSS Blueprint中的 Build Vision Agent 技能。它的设计思路是把复杂的部署流程压缩为"一次对话五个步骤",让使用者始终掌握控制权,而底层的工程"管道"由代理自动处理。
流程从一句自然语言的提示开始。你告诉它"我有什么"和"我想要什么"——比如需要实时告警和可在Web界面查看的报告。在写任何代码之前,代理会先读取VSS Blueprint的说明文档:这是一个包含微服务目录和集成契约的简单仓库。换句话说,它基于"事实依据"而非"凭空猜测"来设计方案。这一点在实际工程中尤为关键,很多AI生成的架构之所以不可用,正是因为缺乏对真实接口和服务约束的理解。
NVIDIA VSS(Video Search and Summarization)Blueprint 是NVIDIA推出的一套开源参考架构,专为视频理解与分析场景设计。它将多个微服务(视频摄取、推理引擎、事件存储、Web界面等)打包为一个可组合的蓝图,开发者无需从头设计系统拓扑。Blueprint的核心理念是"可组合性":每个微服务通过标准化的集成契约暴露接口,代理或开发者可以按需选取、替换其中的组件,而不必重写整条数据流水线。这种设计使得AI代理在读取文档后,能够准确理解哪些服务可以调用、如何连接,从而基于真实的系统约束生成可落地的架构方案,而不是凭空捏造一套在纸面上成立但实际无法运行的配置。
两个模型分工:Cosmos 看,Nemotron 写
读取文档后,代理会先提出架构方案,而不是直接动手。方案中包含两个核心模型:
- Cosmos:NVIDIA开放的推理型视觉语言模型(VLM),负责"盯"着摄像头画面;
- Nemotron:负责撰写事件报告。
此外还配套一个告警服务和VSS Web界面。值得强调的是,在这一步什么都还没部署,这只是一份可供人工阅读和确认的计划。
确认架构后,代理会抛出四个关键问题:在哪里构建、使用哪些GPU、主机地址是什么、摄像头在哪。回答完这些问题并点头确认之后,它才真正开始构建。这种"先规划、后确认、再执行"的交互节奏,避免了代理擅自部署造成的不可控局面。
视觉语言模型(VLM,Vision-Language Model) 是能够同时处理图像/视频和文本的多模态大模型。与纯视觉模型(只输出分类标签或边界框)不同,VLM可以用自然语言回答关于画面内容的开放式问题——例如"瓶子外面有没有液体?"这种问答能力使得系统无需针对每一类异常单独训练检测模型,而是通过改变提示语就能切换检测目标,大幅降低了部署新场景的成本。Cosmos 是NVIDIA专为物理世界推理设计的VLM系列,经过大量真实视觉数据训练,擅长理解空间关系和动态场景;Nemotron 则是NVIDIA基于大语言模型技术优化的文本生成模型,适合结构化报告撰写等下游文本任务。两者分工配合,恰好对应"感知—理解—表达"链路中的不同环节。
一句话提示,生成20个服务
真正触发系统工作的,只是一句用大白话写的提示:
"告诉我果汁是否流到了瓶子外面。"(Tell me if the juice ends up outside a bottle.)

就是这么简单。代理据此生成了完整技术栈并完成部署与验证。最终成果包括 20个服务、1路实时摄像头流,整个过程耗时 26分钟、消耗约750万tokens、花费约3美元。两个模型、Web界面和摄像头画面全部上线运行后,代理才算真正开始发挥价值。
在后台,由Cosmos驱动的VSS代理以10秒为一个片段持续观察摄像头,不断自问那句被设定的问题。当产线突然出现泄漏时,几秒钟内事件就被推送到了仪表盘。
从检测到报告:操作成本仅几分钱
检测到问题只完成了一半工作。演示者希望不必逐帧翻看录像就能了解产线上发生了什么,于是直接在聊天框里要求代理"生成一份报告"。
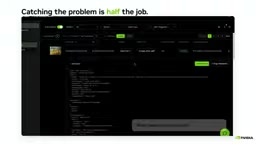
代理从数据库中调取事件记录,由Nemotron当场撰写报告,整个过程不到一分钟,成本仅几分钱。关键在于:没有云端调用,没有按token计费的账单——因为Cosmos和Nemotron都运行在自己的硬件上。
成本账本:一杯咖啡的价格
把账算清楚:
- 搭建成本:一个编码代理、一个技能、一个提示,一次性约 3.5美元;
- 运行成本:每次操作仅几分钱,模型跑在自有硬件上,不存在按token付费的持续账单。
换言之,一个完整的、能实时检测异常并自动生成报告的视觉AI代理,总建造成本低于一杯咖啡。
这意味着什么
这段演示真正值得关注的,不是"3美元"这个数字本身,而是它所代表的工作流转变:从"工程师手写代码堆砌微服务",转向"用自然语言描述需求、由代理读取真实接口契约并自动落地"。
对工业场景而言,本地化部署带来的"无按token计费"模式,解决了视觉AI长期以来的成本顾虑——持续运行的视频分析如果走云端API,账单会迅速失控。而将推理VLM和报告模型部署在自有GPU上,使得"每个任务几分钱"的经济性成为可能。
当然,这段内容本质上是一次产品能力演示,真实生产环境中的边缘情况、模型误报率、以及多摄像头规模化下的表现,仍需进一步验证。但它清晰地展示了视觉AI代理从概念走向可落地的一条务实路径。
边缘推理与本地化部署在工业视觉AI中具有特殊意义。工厂产线摄像头产生的视频流数据量极大,若实时上传至云端API进行推理,不仅延迟难以满足秒级告警需求,持续的token计费也会让成本随摄像头数量线性膨胀。将推理模型部署在工厂本地GPU服务器上(即"边缘推理"),数据不出厂区,既消除了网络延迟瓶颈,也规避了数据隐私与合规风险,运行成本则从"按调用量付费"转变为一次性硬件投入加固定电费。这一模式在制造、能源、物流等对数据安全和低延迟双重敏感的行业中,正逐渐成为视觉AI落地的主流路径。
相关推荐

看懂n8n工作流只需四要素:触发、数据、逻辑、动作
学n8n自动化不要只会抄模板。掌握触发、数据、逻辑、动作四个核心要素,你就能看懂任何工作流、独立搭建并在出错时快速调试,从模板搬运工进阶为真正的自动化构建者。
混合RAG检索实战:Dense+BM25+RRF与重排序完整解析
深入解析开源项目 ReRankEval 混合 RAG 检索管线:稠密向量搜索、BM25、RRF 倒数排名融合与 LLM 重排序如何协同,以及用 Hit Rate、MRR、NDCG 科学评测检索质量的完整方法。

Browser MCP 登录会话保活:AI Agent 自动化的隐形门槛
AI Agent 接入 Browser MCP 后登录会话过夜失效、重复认证烧掉大量 token,是自动化落地的常见痛点。本文剖析会话持久化难题的本质,并给出持久化 profile、会话解耦、凭证轮换应对等务实思路。