32G显存跑Qwen3 MoE大模型?实测本地部署新方案

AMD R9700(32GB显存)通过Straighta分级调度方案跑起Qwen3 MoE量化版,实现256K上下文下80+ tokens/s推理速度。
本文介绍了一位B站UP主利用AMD Radeon R9700(32GB显存)搭配名为「Straighta」的部署方案,在本地跑通Qwen3 MoE量化版的实测经验。核心突破在于MoE架构的稀疏激活特性:常用专家常驻显存,其余专家按需从内存调入,硬盘保存索引,GPU与CPU协同推理并辅以推测解码,最终在256K上下文下实现80+tokens/s的出词速度,比同卡跑27B稠密模型快25%以上。量化方面,IQ3_XXS这一激进格式在图像/场景生成任务上表现够用,但创意写作等纯文本推理仍有短板。方案支持OpenAI与Anthropic双兼容接口,可直接对接主流Agent工具,但需接受显存内存几乎吃满、冷启动较慢的现实代价。
本地跑大模型的痛点就两件事:装不下,和量化完变笨。前者让你被显存卡死,后者让模型变成人工智障。这位B站UP主入手AMD Radeon R9700(32GB显存)后一直在研究如何压榨它,并声称通过一个名为「Straighta」的部署方案,让这张卡跑起了原本遥不可及的 Qwen3 MoE 版本,而不再是只能跑 27B 的稠密模型。
注:原始素材为语音转写,模型名存在明显识别误差(如"QM3.8 Fleshnex""QAM3.827B"等),结合上下文应指 Qwen3 系列的 MoE(Flash/Next)版本与 Qwen3-27B 稠密版,本文按合理推测呈现,具体型号请以实际部署为准。
核心数据:256K上下文 + 80 tokens/s
先看最抓眼球的几个数字:256K 上下文、出词 80 多 tokens/秒、卡是 32GB 显存的 R9700、跑的是量化版的 MoE 模型。
按UP主实测,开满 256K 上下文时,显存占用 31.5GB、内存占用 48GB 以上,两条基本都顶到头。预填充速度 1600 多 tokens/s,短上下文输出 80 到 100 多 tokens/s,长上下文也能保持 45 tokens/s——比他之前跑的 27B 稠密模型快了 25% 还多。
换成实际体感:一个 4 万多 tokens 的任务,大约 10 分钟出结果。对 Codex、Claude Code、DeepSeek广告 这类 Agent 工作流来说,这个速度算是够用了。
几十G权重怎么塞进32G显存?
关键在于 MoE(混合专家)架构的特性。UP主用了一个很形象的比喻:这个模型有两万多个"专家",就像一家两万人的公司,你不可能把所有人都养在工位上。
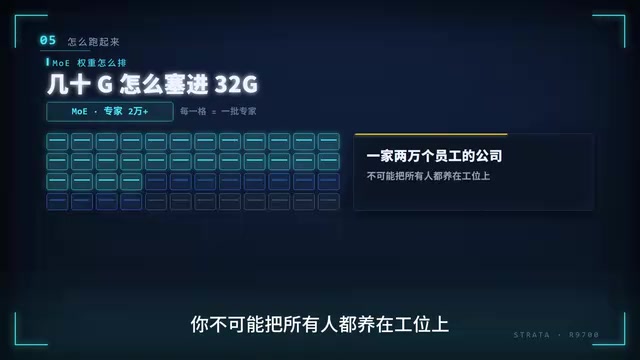
Straighta 做的事情就是分级调度:
- 最常用的那批专家常住显存
- 剩下的挂在内存里随叫随到
- 硬盘上留一本"花名册",要找谁一眼定位
推理时 GPU 和 CPU 协同计算,再配合推测解码(原文称 NPP,应指类似的多词预测技术)一次多猜几个词。一句话总结:把电脑里所有能用的资源全调动起来,只为让词出得更快。
这套机制也解释了为什么它"不挑卡"——据UP主介绍,A卡、N卡都支持,最新版本连 Intel 显卡也支持了,最低 12GB 显存配合足够大的内存和 NVMe 也能跑。
MoE(Mixture of Experts,混合专家)架构与传统稠密模型的根本区别在于:稠密模型每次推理都会激活全部参数,而 MoE 模型在每次前向传播时只激活其中一小部分"专家"子网络(通常由一个门控网络动态路由决定)。以 Qwen3 MoE 版本为例,模型总参数量可能高达数百亿,但单次 token 生成实际参与计算的参数量远小于此。这意味着即便总权重文件远超显存容量,只要能把当前推理所需的那批专家及时调入计算单元,推理就能继续进行。这也是分级调度能够成立的物理基础:模型的稀疏激活特性天然契合"按需换入"的内存管理策略,而不像稠密模型那样必须把全量参数塞进显存才能运行。
智商测试:量化版够用吗?
速度之外,更关键的是量化后模型会不会"变笨"。UP主用 Cherry Studio 做了测试,口径说得很清楚:不接任何 Agent,一句话提示词,一次性出结果,模型是 IQ3_XXS 量化版。
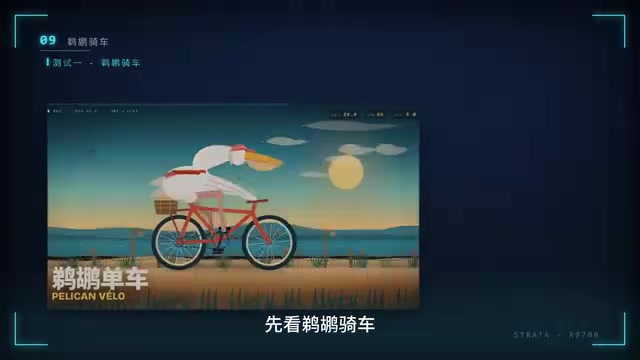
测试一是生成"骑车"场景:没有错位和穿帮,还能调整上坡、下坡的姿态。UP主表示同样口径下,这个结果明显优于他之前跑的 27B Q4 量化版,按他的体感也强于 GLM 和 DeepSeek 的部分版本(他强调这是体感、非跑分)。
测试二是生成"上海外滩"场景,视觉效果可观,还能切换白天/夜晚时间段。整个测试输出 4 万多 tokens,推理速度 70 多 tokens/s,一分钟左右出结果。
结论是:IQ3_XXS 这个激进量化版本的能力够用,作为本地主力配合 Agent 干活可以胜任。
IQ3_XXS 是 llama.cpp 体系中一种极度激进的非均匀整数量化格式,名称里的"3"代表平均约 3 bits 的量化精度,"XXS"表示额外压缩至超小尺寸。相比常见的 Q4_K_M(约 4.5 bits)或 Q5_K_M,IQ3_XXS 的模型文件体积和显存占用可再缩减 30%~40%,代价是信息损失更大,在需要精确推理、长链逻辑或细腻语言表达的任务上容易出现能力下滑。不过 IQ 系列量化采用了 importance matrix(重要性矩阵)引导的非均匀量化,对关键权重给予更多比特保护,因此在同等压缩率下通常优于早期的均匀量化方案。UP 主观察到图像/场景生成任务表现尚可、但创意写作会"露馅",正好符合该量化级别在结构化输出上相对鲁棒、在开放式语言生成上更脆弱的一贯规律。
接入与部署:OpenAI/Anthropic双兼容
Straighta 的接入门槛不高。它同时支持 OpenAI 兼容接口和 Anthropic 兼容接口,本地部署完成后,把 API 地址填进去即可。
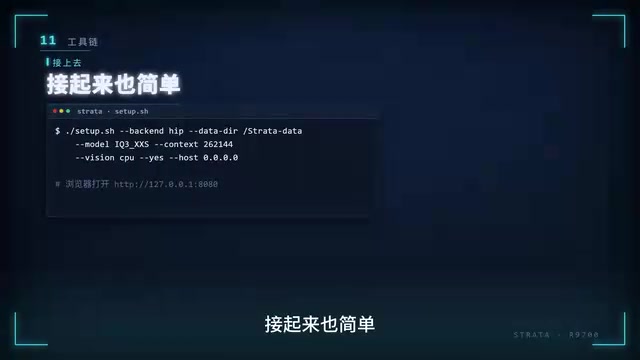
Codex、Claude Code、DeepSeek Harness 等工具可以直接对接使用,这对想在本地搭 Agent 工作流的开发者来说相当友好。
现存的三个坑
UP主也诚实地列出了当前方案的问题:
- 显存和内存实打实吃满——同时开别的程序会和它"打架",对多任务不友好;
- 首次加载需要预热——冷启动速度不快;
- 创意写作等纯文本推理仍会露馅——激进量化在这类任务上的短板依然存在,UP主表示会持续测试。
谁值得尝试?
UP主给出的建议相当明确:
- 32GB 显存这一档:强烈推荐,速度比 27B 快、能力比 27B 强,短期内可作主力模型;
- 12GB 显存 + 大内存 + NVMe:可以试试;
- 12GB 显存 + 小内存:别指望。
对长期"苦生态久矣"的 AMD R9700 用户来说,这类分级调度方案确实提供了一条新路径——用 MoE 架构 + 显存/内存/硬盘协同的方式,绕开了单纯堆显存的硬性门槛。当然,激进量化带来的能力折损、以及资源吃满导致的多任务冲突,仍是本地部署绕不开的现实权衡。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。