3AM Super Intelligence:AI值班工程师如何搞定生产事故

3AM 推出可本地部署的 AI 值班工程师,主打根因调查与修复预演。
3AM Super Intelligence 在 Product Hunt 发布了一款 AI 值班工程师,覆盖根因调查、修复预演和 Slack 一键处置三个环节,并强调全程运行在用户自有网络内。产品定位是“你没法重写”的系统,即遗留系统、单体应用和核心链路,这类系统可观测性不完整,反而最需要有人值守。修复预演是其核心差异点,把 AI 建议推进到经过验证的动作,同时把最终决策权留给人。文章也指出其局限:权限模型与回滚机制未在官方材料中展开,Product Hunt 上仅 76 票、4 条评论,社区验证仍处早期,是否构成护城河取决于预演可靠性与异构系统接入广度。
生产环境出事,凌晨三点被叫醒是许多工程师的噩梦。3AM Super Intelligence 在 Product Hunt 上发布了一款 AI 值班工程师,号称能调查根因、预演修复方案,并在 Slack 里一键解决事故,而且全程运行在你自己的网络内。这款产品拿到 76 票、排名第 7,分类落在开发者工具与人工智能交叉地带。它想解决的,是那些“你没法重写”的系统——也就是遗留系统、单体应用、以及牵一发动全身的核心链路。
从告警到闭环:3AM 解决了什么
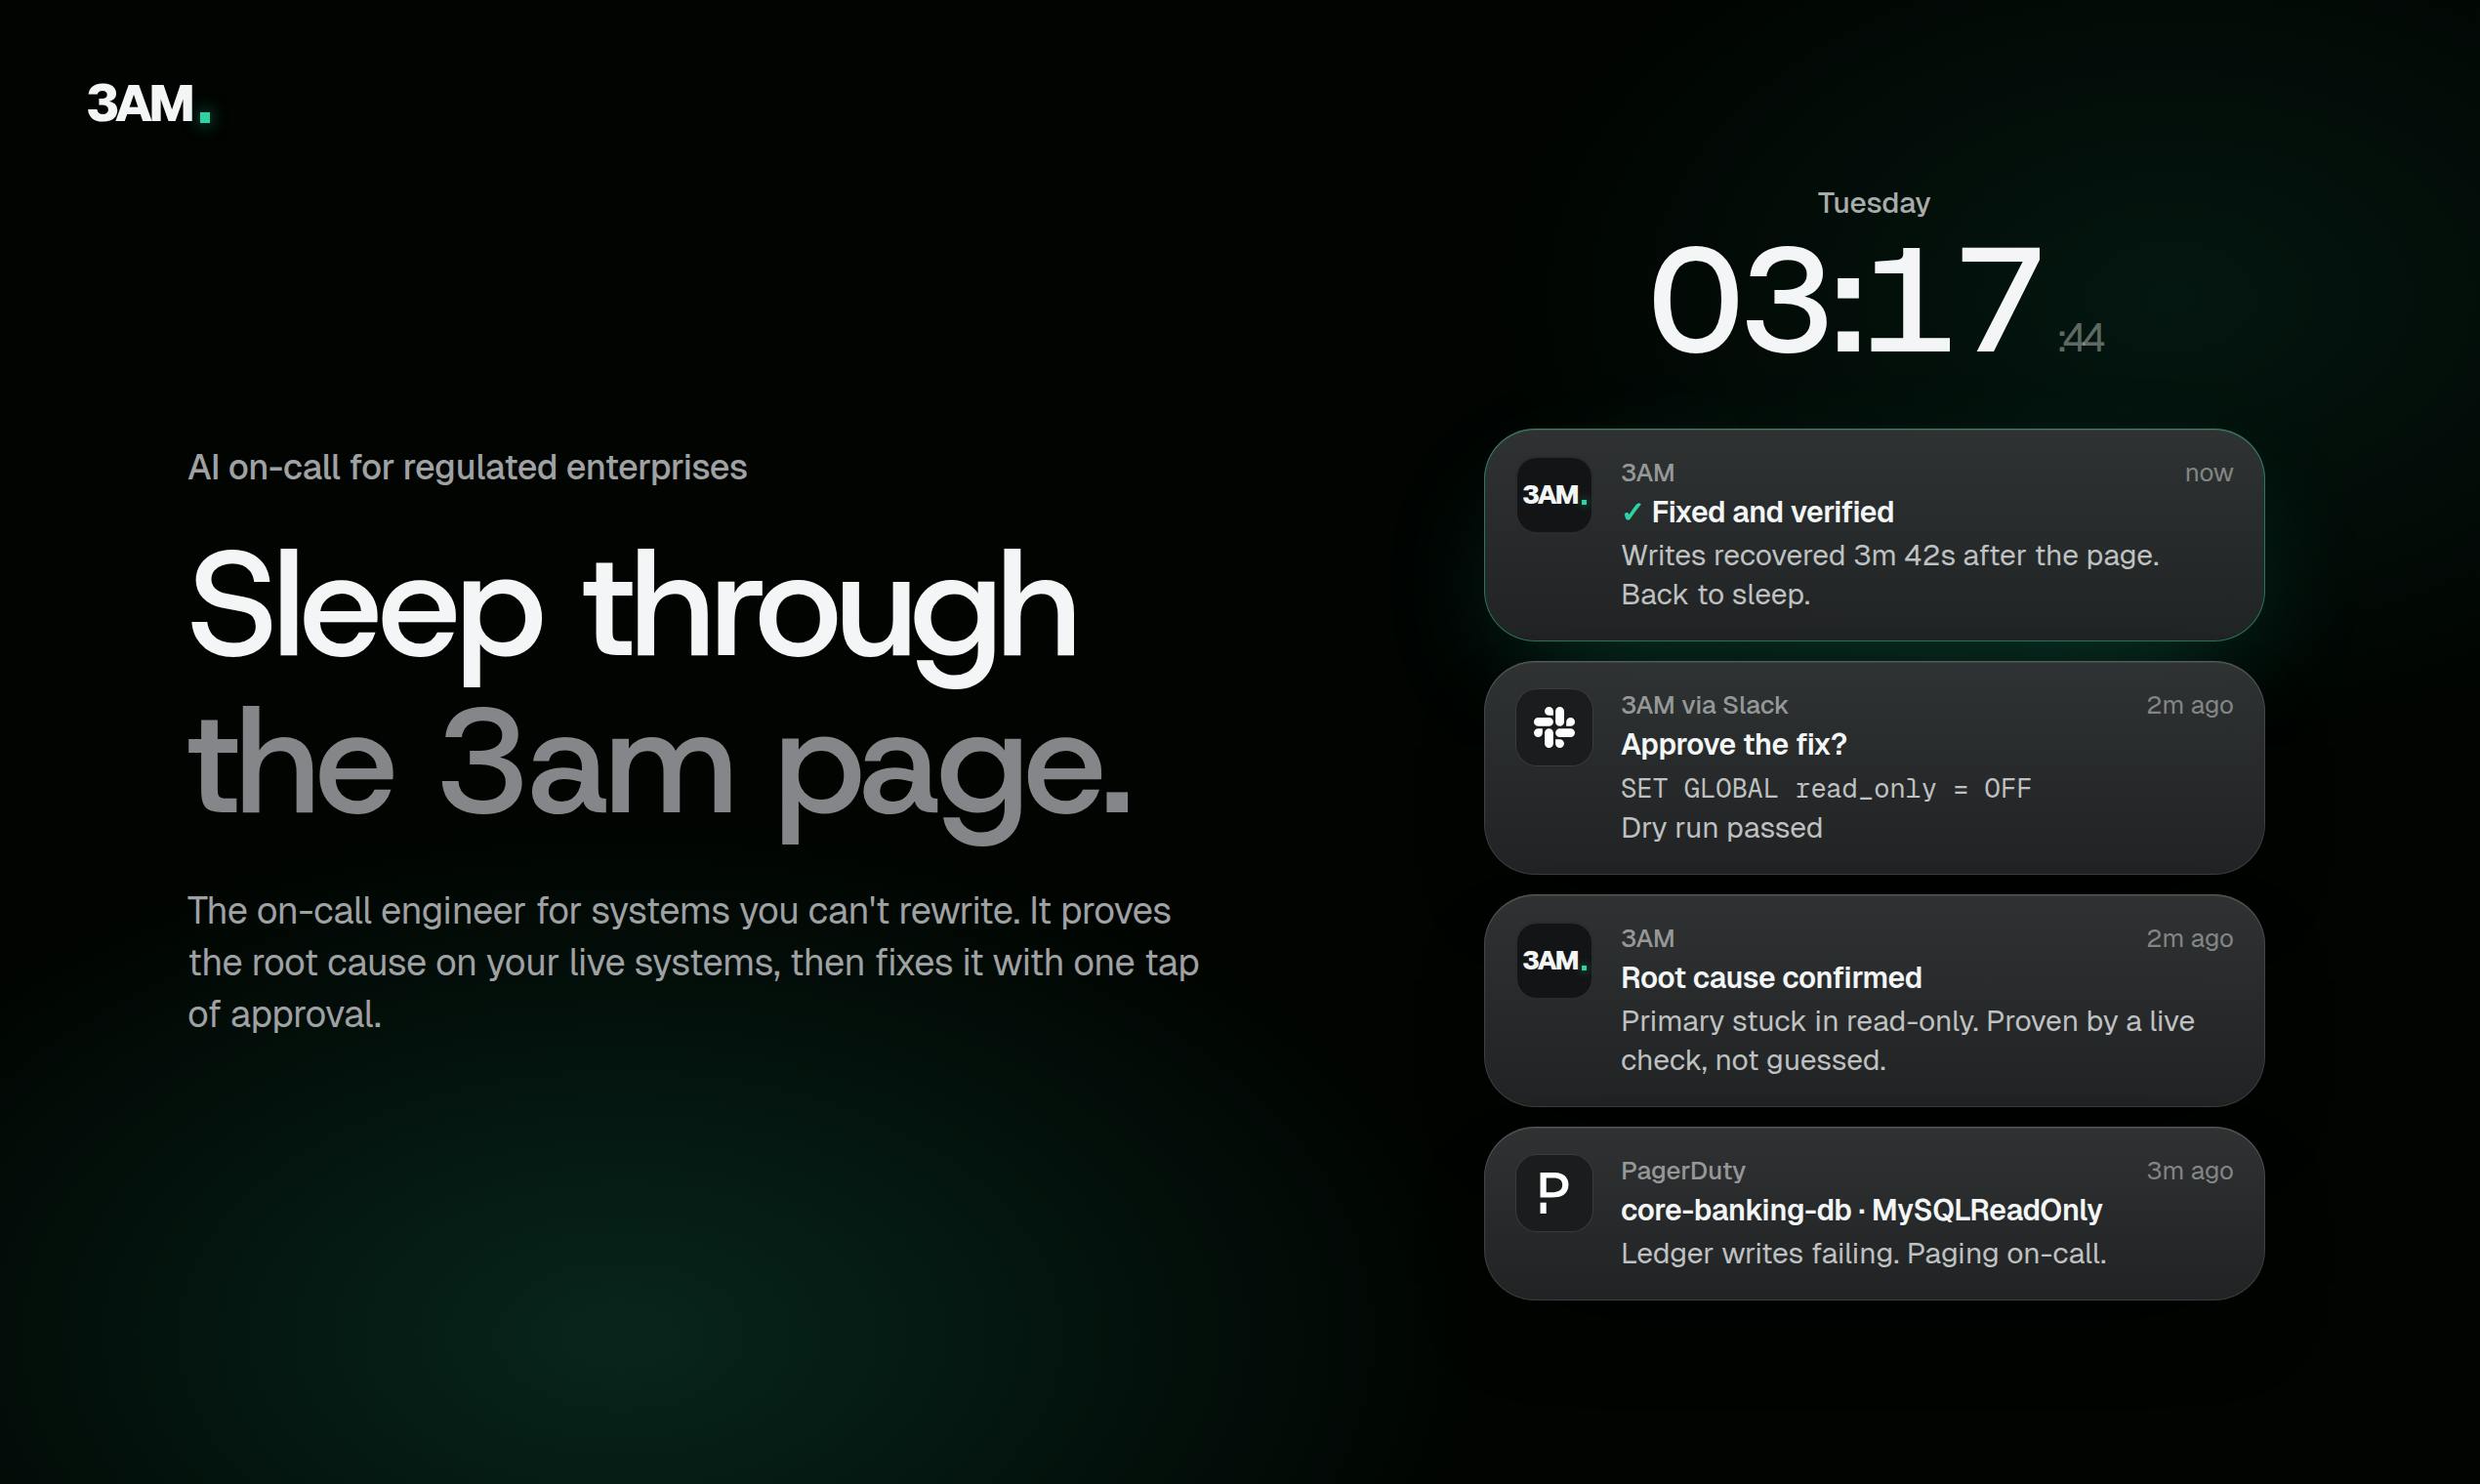
传统 on-call 流程里,人被叫醒之后要做三件事:定位问题、验证修复思路、执行变更。3AM 把这套流程拆解成 AI 可以介入的环节。根据官方描述,它会先做 root cause 调查,再在一个安全环境里预演修复动作(rehearse the fix),最后通过 Slack 的一键操作完成事故处置。这意味着值班工程师不必在睡眼惺忪时登录跳板机、翻日志、手动执行命令,而是先看 AI 给出的调查结论和预演结果,再决定是否点下确认。
这个设计的关键在于“proven”这个词。它没有承诺 AI 自动把所有事故都修好,而是强调修复方案经过了预演验证。对生产系统来说,这个区别很重要:一个没验证过的修复动作,和一次未经测试的数据库迁移一样危险。
Root Cause 调查(根因分析)指从告警现象出发,沿指标、日志、链路追踪和变更记录反推故障源头的技术过程。传统上依赖人工经验与预设规则,耗时往往占据事故处理的大半;3AM 一类工具改用大模型对多源信号做关联推理,给出候选根因假设并附证据链。由于模型输出存在不确定性,工程实践通常要求它与可观测性数据交叉验证,并通过灰度或回滚机制兜底,避免把概率性推断当作确定性结论直接用于生产变更。
为什么“不重写系统”是一个真实需求
产品定位里有一句很直白的话:for systems you can't rewrite。这句话戳中了很多团队的现状。不是每个系统都能推倒重来,大量企业核心逻辑跑在多年积累的服务里,重写成本高、风险大、业务等不起。这类系统的可观测性往往也不完整,日志格式混乱、指标缺失、调用链断裂,恰恰是最需要有人值守、又最难自动化的一类场景。
3AM 选择从这里切入,而不是去做新系统的可观测性平台,是一种务实的差异化。新产品可以天生接入 OpenTelemetry,但老系统只能靠 AI 去读懂既有信号。这也解释了它为什么强调“从你自己的网络内部”运行——对无法上云的遗留系统,数据出网本身就是一道红线。
遗留系统(legacy system)一般指运行多年、仍在支撑核心业务但技术栈陈旧、文档缺失、原开发者多已离场的系统。这类系统的特点是改动牵一发动全身,且难以直接替换。与之相对,OpenTelemetry 是云原生计算基金会推动的可观测性开放标准,统一了指标、日志与链路追踪的数据采集协议,新系统接入即可获得结构化遥测数据。遗留系统往往在标准出现前就已建成,日志格式各异、埋点不全,因此需要 AI 从非结构化信号中还原运行状态,这正是 3AM 切中的技术空白。
Slack 一键操作的利与弊
把事故处置收敛到 Slack 里,交互上非常顺滑,省掉了在多个控制台之间来回切换的成本。但一键操作也带来审批边界的问题:谁有权限点这个按钮?预演通过的方案是否等同于可以无条件执行?官方材料没有展开说明权限模型和回滚机制,这在实际落地时会是绕不开的细节。
对于高风险变更,合理的预期是 AI 负责调查和预演,人负责最终决策。3AM 把确认动作放在 Slack,实际上是把决策权留给了人,这个设计方向是对的。但如果团队希望夜间无人值守、AI 直接处理低风险事故,就需要更清晰的自动化分级策略。
修复预演(rehearse the fix)指在隔离环境中按真实执行步骤演练修复动作,观察其对系统状态、依赖服务和数据的影响,从而在变更生产环境前发现副作用。它与传统变更审批的区别在于:审批评估的是人提交的变更计划,预演检验的是动作实际产生的效果。预演环境与生产环境的配置漂移会直接影响结论可信度,因此预演结果只是降低而非消除风险,仍需配合回滚方案与执行窗口控制。
在 AI 值班赛道里的位置
AI on-call 正在成为一个独立品类,玩家的共同思路是用大模型读取告警、日志、变更记录,给出根因假设。3AM 的差异点集中在两处:一是修复预演,把“建议”推进到“验证过的动作”;二是网络内部署,照顾对数据边界敏感的团队。这两点是否构成足够深的护城河,取决于预演机制的可靠性和对异构系统的接入广度。
从 Product Hunt 的反馈看,76 票、4 条评论、排名第 7,说明它引起了一定关注,但还远未到大规模讨论的程度。评论数量偏少,社区验证仍处在早期。对关注 AI 运维的团队来说,值得把它放进观察名单,重点看它如何证明预演结果与真实执行之间的一致性。
AIOps(智能运维)是把机器学习与自动化引入告警收敛、异常检测和根因定位的运维实践,早期以规则和统计模型为主。大模型兴起后,新一代 AI on-call 工具在其上叠加自然语言理解与推理能力,可直接读取告警文本、日志片段和变更工单。该品类的共性难点在于评估:事故样本稀少且场景异构,难以建立统一基准,因此各厂商多以演示案例和预演机制来证明可靠性,真实效果还需长期生产数据检验。
谁应该关注
手里有遗留系统、值班压力大、又不能推倒重来的团队,是 3AM 最直接的目标用户。已经在用 Slack 作为运维协作入口的组织,接入成本会更低。反过来,如果系统本身已经全面容器化、可观测性完善、变更走标准流水线,那么现有工具链可能已经覆盖了大部分需求。
3AM 提出的问题很具体:当事故发生在凌晨三点,AI 能不能先替人做调查和验证,把决策留给人。这个问题的答案,会决定 AI 值班工程师是真需求,还是又一个演示很酷、落地很轻的工具。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。