3D拆解AI模型:揪出近半亿参数的“死重”
3D按真实尺寸可视化模型,发现可剥离的冗余组件与24层Transformer主干。
一位YouTube创作者将真实AI模型在3D空间中按张量真实尺寸可视化,419个张量、近5亿权重,输入从顶部进入、决策从底部输出。这种视角让模型内部结构变得可感知:创作者发现span head和count head等未使用组件体积远大于真正做决策的classifier head,属于可剥离的死重,移除后仅保留分类头即可维持完整功能。模型主干呈眼形结构,对应一个24层Transformer,按当今标准偏小。文章指出,3D可视化能低成本暴露模型冗余,为剪枝和部署优化提供直观起点,对边缘推理团队尤有借鉴意义。
从3D视角看模型:每个方块都是真实张量
最近一位YouTube创作者做了一件很有意思的事:他把一个真实AI模型在3D空间中可视化,每个方块对应一个真实张量,按真实尺寸缩放,总共419个张量,承载着近5亿个权重。输入从顶部进入,决策从底部输出。这种可视化方式让人第一次能“看见”模型的内部结构,而不仅仅是看数字和图表。
这种视角的价值在于,它把抽象的参数量和计算图变成了可感知的空间结构。创作者在探索过程中发现,模型里存在一些“未使用的组件”,而且它们体积相当大——比如span head和count head,尺寸远超真正做决策的classifier head。这意味着大量参数并没有参与到最终的功能中,属于典型的“死重”。
剥离死重:留下分类头就能跑
创作者给出的结论非常直接:可以完全剥离span head和count head,只保留classifier head,决策功能依然完整。换句话说,模型里相当一部分参数对最终输出没有实质贡献,却常年占据存储和计算资源。
这其实指向一个工程实践中常见但很少被直观展示的问题:模型膨胀。在训练和迭代过程中,架构里可能残留了针对旧任务或辅助目标的模块,后续微调时没有清理,结果就是“能用但臃肿”。从3D视图看,这种冗余一目了然——大块的张量悬在主干之外,和决策路径没有连接。对部署端来说,这些死重直接转化为显存占用和推理延迟。
分类头(classifier head) 是模型末端负责将主干提取的特征映射为最终决策输出的模块,通常由一个或数个线性层构成。与之并列的 span head、count head 属于多任务学习留下的辅助分支:它们在训练时可能用于预测文本片段边界或数量等附加目标,帮助主干学到更丰富的表示,但推理阶段并不参与主任务决策。多任务训练中,各辅助头共享主干参数、各自拥有独立输出层,因此参数量会随任务数叠加。若后续微调只关注分类任务而未做结构裁剪,这些辅助头就会以完整张量的形式保留在权重文件中,形成可观但无用的参数占用。识别它们的方法通常是检查计算图中是否存在从主干到输出但未被推理路径引用的节点,或在导出模型时对比实际前向调用到的算子集合。
眼形结构揭秘:24层Transformer
可视化的另一个亮点是模型主干呈现出一个近乎“眼形”的结构。创作者解释,这个眼形其实就是Transformer本身——一个24层的Transformer,按今天的标准来说相当小。
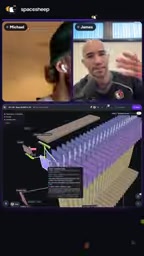
24层在今天的大模型语境下确实不算大,但把它放进3D空间里按张量尺寸展开,视觉冲击力很强。这也解释了为什么创作者感叹“从没见过这种表示方式”——传统的Transformer示意图多是平面堆叠的方块,而3D按真实比例渲染后,层与层之间的尺寸差异、注意力模块和前馈模块的体积对比,都变得直观可读。
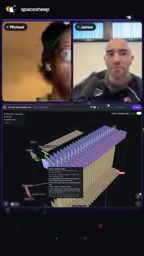
Transformer 层 通常由多头自注意力子层和前馈网络子层组成,每个子层后接残差连接与归一化。按真实尺寸渲染时,前馈网络的中间维度一般是模型隐藏维度的数倍,因此其权重张量体积明显大于注意力模块,两者在3D视图中形成宽窄交替的节律。24层意味着有24组这样的子层堆叠,总参数量约数亿级别,与文中近5亿权重的量级吻合。所谓"眼形",正是这种层间尺寸变化与首尾嵌入层较宽、中间层相对收窄的轮廓共同造成的视觉效果。理解这一结构有助于把3D视图中的"体型"直接对应到具体的计算模块,从而判断冗余究竟来自注意力、前馈还是辅助头。
对模型压缩与可视化的启示
这次探索虽然来自个人创作者,但指向了两个值得关注的议题。第一,模型冗余的发现可以更早、更直观。如果可视化工具能在训练后快速标出与主任务无关的张量块,剪枝和蒸馏的决策成本会显著下降。第二,3D按真实尺寸渲染是一种被低估的分析手段——它不替代profiling工具,但能让人在几秒内形成对模型“体型”的直觉判断。
从工程角度看,剥离未使用组件属于低风险优化:只要确认这些head不参与推理路径,移除后功能不变,收益却是实打实的存储和算力节省。创作者的演示给了一个朴素但有效的起点——先看见,再动手。
对于做模型部署和边缘推理的团队来说,这类可视化思路值得借鉴。模型不透明带来的浪费往往比想象中更大,而一个3D视图,有时比一张参数表更能说明问题。
剪枝(pruning) 与蒸馏(distillation) 是模型压缩的两条主要路径:前者移除对输出贡献小的权重、通道或整个模块,后者用大模型(教师)的输出指导小模型(学生)训练。文中剥离未使用组件的做法属于结构化剪枝的极端情形——整块移除且预期功能不变,风险最低。与之相比,剪除参与前向计算的注意力头或前馈通道需要评估精度损失,通常配合再训练恢复性能。可视化的价值在于把"哪些块可以动"从依赖工具输出变为肉眼可判:与主决策路径无连接的张量块是安全候选,而尺寸异常却参与计算的模块则提示需要进一步 profiling 确认其实际贡献。
相关推荐
军事专家为何总误判?Lex Fridman播客反思战争预测
Lex Fridman播客中军事专家反思战争预测为何失准:专家更了解对手而非盟友,军事力量无法抽象排名,场景与地理政治目标才是分析起点,俄乌冲突初期误判正是例证。

Spamhaus 11月邮件发送新规:发件人必须了解的变化
Spamhaus 将于11月实施新的邮件发送者要求。本文梳理新规方向、对发件人认证与发送行为的影响,以及开发者和企业应提前做的准备。
美联储预警:AI代理或引发银行挤兑
美联储担忧AI代理的自动化行为可能引发银行挤兑。本文分析AI代理在金融场景中的风险机制、监管挑战与行业启示,探讨机器速度挤兑为何比传统挤兑更难防范。