40天64个版本:Strata如何用发版密度定义AI本地推理路线图

Strata 40天发64版,从能跑到跑得快再到可信,发版记录即路线图。
Strata 项目在 40 天内发布了 64 个版本,发版说明总长度超过 46 万字符,呈现出“先能跑、再跑得快、最后跑得可信”的三步演进路线。0.1.0 至 0.1.18 专注让请求稳定运行,0.1.16 转为 MIT 开源并接入首个搜索模型;0.1.21 至 0.1.44 将单卡支持铺成多硬件产品线,采用成对中位数和 identity gate 等严谨 benchmark 方法;0.2.0 beta 后拆分为 app、terminal、engine 三部件,引入 Ed25519 签名更新通道,提升安装与更新的可信度。文章还给出硬件档位建议:12G 显存是英伟达单卡分水岭,8G 能跑但不适合并发。每版正文的“未测”章节构成下一版清单,硬件支持靠用户开 issue 推动。
Strata 项目在 40 天内发布了 64 个版本,如果把每个版本的 release 说明加起来,总长度超过 46 万字符。B站 UP 主逐篇读完了这些说明,并从中梳理出一条清晰的演进路线:先能跑,再跑得快,最后跑得可信。本文基于该视频内容,结合四个关键截图,还原 Strata 从 0.1.0 到 0.2.10 的三步跨越,以及普通用户如何根据硬件找到自己的档位。
发版密度本身就是路线图
Strata 的发版节奏呈现出明显的“前密后疏、越往后越重”的特征。前五天发布了 17 个版本,最密的一天发了 8 个;中间 20 天 35 个版本;最后 15 天只有 12 个版本。数量在减少,但每个版本的说明长度在增加——0.1 时代平均每篇说明约 4 倍于 87 个字符,到了 0.2 时代平均达到 17782 个字符,翻了将近 4 倍。
这种密度变化说明项目在早期采用“修一个问题就发一版”的节奏,而后期则转向更重的架构级改动。0.2 时代同一天最多只发两个版本,但每个版本覆盖的功能面显著扩大。发版密度从侧面反映了项目从试探性修复到系统性重构的转变。
第一步:让请求真的能跑(0.1.0 - 0.1.18)
第一个版本 V0.1.0 的说明只有 384 个字符,附带一个 Windows CUDA 13 的安装包,支持 RTX 30 到 50 系列。接下来五个版本都在解决同一类问题:请求能不能正常跑。0.1.2 让工具调用流式返回,按下停止是真的停;0.1.7 修掉了恢复停在 1024 token 的 bug;0.1.8 在浏览器里长出第一个 app,并带来可选的 4 位 KV cache,128k 上下文从 1.52 GB 降到 0.83 GB。
这一阶段没有任何一句速度承诺,全部精力放在让推理链路稳定可用。对于本地部署工具来说,能跑通是第一位的,Strata 在这一步上花了大约 18 个版本。
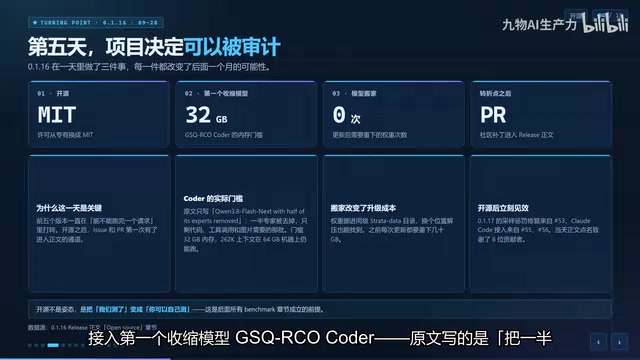
第 5 天的 0.1.16 是一个转折点,一天内做了三件事,每一件都改变了后面一个月的可能性。第一,转为 MIT 开源;第二,接入第一个搜索模型 Gsqrcocoder,原文写的是“把一半专家去掉,只留代码、工具调用和图片需要的那批”,内存门槛降到 32G,12G 卡提示词能到 599 到 1350 token 每秒;第三,把权重挪进 strata data 目录,更新不再从零下载几十 G。开源不是姿态,而是把“我们测了”变成“你可以自己测”——后面所有 benchmark 能成立,就是因为这一步。
KV cache 是 Transformer 推理中的关键优化机制。自回归生成时,每生成一个新 token 都需要重新计算之前所有 token 的注意力,计算量随序列长度平方增长。KV cache 将历史 token 的 Key 和 Value 向量缓存下来,避免重复计算,从而把复杂度降到线性。但缓存本身占用显存:在 128k 上下文下,传统 FP16 精度的 KV cache 可能超过 1.5 GB。Strata 在 0.1.8 引入的“4 位 KV cache”通过量化压缩缓存精度,将 128k 上下文的缓存占用从 1.52 GB 降至 0.83 GB,使大上下文在消费级显卡上成为可能,代价是极少量精度损失。
第二步:把一张卡铺成一条产品线(0.1.21 - 0.1.44)
接下来 20 天、35 个版本的主线,是把一张卡的支持铺成一条覆盖多硬件、多场景的产品线。0.1.21 做出二到三张英伟达卡的成对拆分,5080 加 3090 在 32k 下提示词从 1970 提到 2357 token 每秒;0.1.39 照顾 Pascal、Volta 和老 CPU,全部标为实验性;0.1.40.2 把英特尔 ARK 转正;0.1.41 让 A750 的采样器去掉 FP64,解码从 9.8 提到 12.0,提升 22%;0.1.43 进入 AMD RDNA;0.1.44 进入苹果 Silicon。
这一阶段最值得关注的不是数字,而是 benchmark 的写法。作者用成对中位数、两个默认交替跑同一台机器、每轮新建引擎,结论写成“8 对 8 更快”而不是“快 4%”。他用 identity gate——10 条提示词加 4k 和 20k 精确比对答案,答案没变才敢说只改默认;答案变了就改用 kr 距离。0.2.3 直接写明“进并列的词可能不同”;0.2.8 也承认有个提速默认会让常绘画重复文本,宁可关回去。而且每个新默认都配一个反向环境变量——“写不出退路的改动就不进默认”。这种严谨的测量方法,比具体数字更值得借鉴。
成对中位数(paired median) 是一种严谨的基准测试方法:对同一台机器、同一组提示词,交替运行两个待比较的配置(如优化前后),每轮都新建推理引擎,记录每次运行的延迟或吞吐,最后取配对差值的中位数作为结论。相比单次测量或平均值,成对中位数能抵消机器状态漂移和预热差异,减少偶然误差。原文中“8 对 8 更快”即指 8 组配对测试的中位数结果,而非简单的百分比提升,这种表述更保守也更可信。
第三步:让安装和更新变得可信(0.2.0 beta 之后)
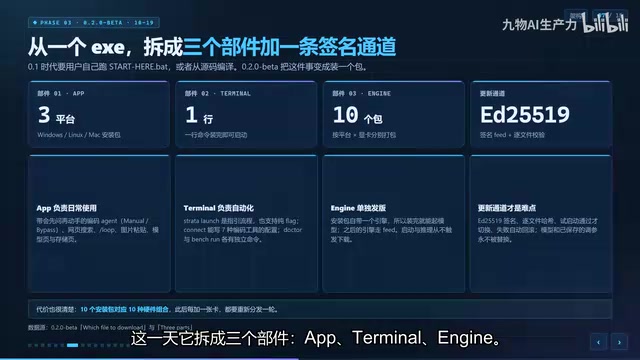
到 0.2.0 beta,整个形态变了。0.1 时代用户要自己跑 start here 或者从源码编译;0.2.0 拆成三个部件:app、terminal、engine。app 是三个平台的安装包,terminal 一行命令装完,engine 按平台和显卡拆成十个包,安装包自带一个,所以装完就能起模型。还有第四条:Ed25519 签名更新通道,主文件校验通过才切换,失败自动回滚。代价也很清楚——十个安装包对应十种硬件组合。
0.2.x 的 12 个版本几乎每版换一个主角。0.2.2 让显卡可以设 mean helper 或 off;0.2.3 把 streaks halo 的回答速度提了 6% 到 19%;0.2.4 把 deep seek v4 便衣 flash 搬进终端,12G 卡加 16G 内存就能跑;0.2.7 进 DGX Spark;0.2.8 在两张 Arc Pro B65 上从 60 到 63 提到 71 到 74。0.2.10 是 dflash2 转默认,速度数字从此按机型分组给。
最新一版改了三个默认,每一个都带代价。第一个,dflash2 完成默认 drafter 0.7G 取代 5.2G 的 mtp 层,单卡解码提升 5.8% 到 12.0%,但在 Arc A750 上反而慢 2%。第二个,Linux 上全卡成功拆分引擎自动启动,两张 A6000 代码编辑从 195 提到 377 到 394 token 每秒,代价是 32k 提示词首字从 7.65 秒变 4.1 秒。第三个,8G 卡起手就是 128k 上下文。还有一个坑:从 0.2.9 升上来要跑两次 update。
Ed25519 签名更新通道 是保障软件分发完整性的密码学机制。Ed25519 是一种基于椭圆曲线的数字签名算法,速度快、密钥短、安全性高。在自动更新场景中,发布方用私钥对更新包的主文件生成签名,客户端用内置公钥验证签名;只有校验通过才切换新版本,失败则自动回滚到旧版本。这能防止更新包在传输中被篡改或替换,确保用户安装的是官方构建。Strata 将更新通道拆分为 app、terminal、engine 三层后,每层都需独立签名验证,增加了攻击面管理的复杂度,但也提升了整体可信度。
你的卡落在哪一档
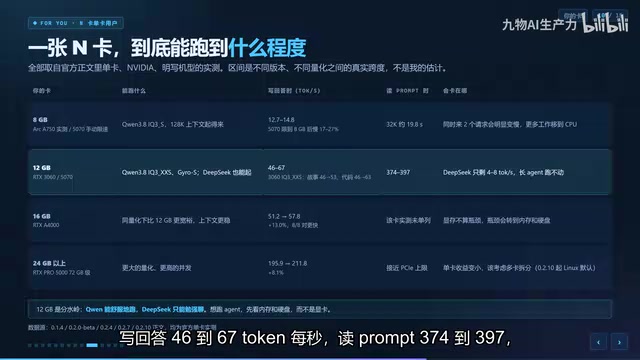
对于英伟达单卡用户,12G 是分水岭。RTX 3060 跑千问 3.8 的 IQ3XXS,写回答 46.8k 到 67 token 每秒,读提示词 374 到 397,日常对话和 agent 都够用。8G 只能选 IQ3S,128k 上下文起得来,但别指望并发——同时来两个请求就明显掉数。16G 的 A4000 同量化下更宽裕,显存不再是瓶颈,瓶颈转到内存和硬盘。24G 以上单卡收益变小,该考虑多卡拆分。
重点在于:12G 卡跑 deep seek 只有 4 到 8 token 每秒,那是聊天档,不是干活档。想跑 agent,先看内存和硬盘,不是显卡。
把“欠账”当路线图
Strata 没有公开计划表,但每一版都写了“还没做什么”的章节,这些章节就是下一版的清单。一个已经兑现的例子:0.2.4 原文明确写 Mac 和 Strix Halo 不在本版,deep seek 跑不了;三个版本之后,0.2.7 的标题就是“DGX Spark 和 Mac 上的 deep seek”,两条全部交付,只用了 9 天。
0.2.10 的欠账就是最近的地图:drafter 抓取逻辑明显是 later change;Windows 加 N 卡的 deep seek 写着 not run yet;GIFOS 双卡和 3-4 卡的全卡拆分也没跑过。这些是从正文倒推的优先级,不是承诺的排期,但写在正文里的欠账基本都会在下几个版本里还上。
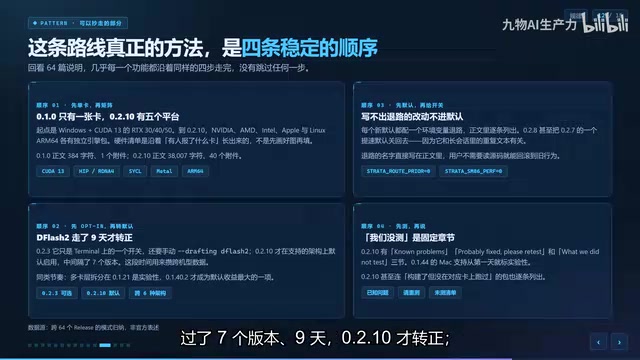
几乎每个功能都沿着同样的四步走:先单卡,再矩阵;先 opt in,再转默认;先测再说。0.2.3 只是 terminal 上一个开关,过了 7 个版本、9 天就转正;0.2.8 甚至把 0.2.7 的一个提速默认关回去。版本号本身也写着该不该更:xy0 和 beta 是架构级改动,安装包和目录结构可能变,值得跟但要等 48 小时看补丁;第三位的 1-4 是同一架构的修复,通常对应具体机型,你的机型在名单里就升;第四位是单点回归修复,整篇只讲一个修复,出问题再升。跨引擎升级时,app、control、engine 三层各自有版本,先读 updating 那一节。
identity gate(恒等闸门) 是 Strata 用于验证优化是否改变模型输出的测试方法:准备 10 条固定提示词,在 4k 和 20k 两种上下文长度下,分别用优化前和优化后的引擎生成答案,逐 token 精确比对。若答案完全一致,才允许将优化设为默认;若答案有差异,则改用更宽松的 kr 距离(Kullback-Leibler 散度)衡量分布偏移。这一机制确保性能优化不牺牲输出质量,也解释了为何某些提速默认在发现导致重复文本后被关回——identity gate 未通过。
容易被忽略的硬件支持路径
Strata 的硬件支持基本是用户先报、作者再补。task call、Volta、Arc、RX 6000 这些支持,正文里都写着 reported by 或者 built not tested——构建了但没在真卡上跑过。开源之后的 27 篇正文直接点名致谢 32 位贡献者,64 篇里出现了 886 个 issue 编号。这对用户的意义很直接:你的卡不在名单里,去开个 issue 就是最快的路径,不用等官方排队。
40 天里这三段的顺序没有倒过一次:先能跑,再跑得快,最后跑得可信。对于关注本地推理工具的人来说,Strata 的发版记录提供了一个少见的样本——把发版本身当作测量手段,用版本密度和欠账清单倒推出项目真实的优先级。
相关推荐

内存要降价了?Reddit热议:AI泡沫破裂或让RAM便宜下来
Reddit热议AI算力泡沫是否会让内存降价:讨论聚焦内存产能锁定、neocloud债务驱动扩张、Oracle与英伟达订单连锁反应,呈现多空双方对RAM价格走势的激烈分歧。

MuJoCo并行训练:单世界多机器人 vs 独立环境
探讨MuJoCo强化学习中单世界多机器人与独立环境并行的区别,分析各自优势及迁移到GPU后的最佳实践,帮助开发者选择正确的并行训练范式。

百度开源ERNIE 5.5 Flash Base:280B MoE大模型解析
百度发布 ERNIE 5.5 Flash Base 基础模型:280B 总参数、14B 激活参数的稀疏 MoE 架构,训练数据 33.5T tokens,未经中期或后训练直接发布,面向研究与下游微调。