4GB显存跑50亿参数生图模型:MOS Image实测与ComfyUI教程

50亿参数开源文生图模型MOS Image,4GB显存可跑,知识密度高、支持文字渲染与布局控制。
MOS Image是一款仅50亿参数的开源文生图模型,量化版可在4GB显存GPU上运行,却具备惊人的知识密度:名人生成、动漫角色、品牌与车型均可开箱即用,文字渲染与非标准宽高比表现突出。文章基于B站UP主“AI Search”的教程,梳理了在ComfyUI中的完整部署流程——下载Diffusion模型、Qwen 3.5 9B文本编码器与Flux 2.0 VAE,选择INT8/W4A8量化版降低显存占用;并介绍了边界框布局控制、LoRA风格扩展、8步DMD LoRA提速(3-4倍,CFG需设为1)以及传统局部重绘编辑等方法。作者认为其画质虽不及双倍参数的Creature 2,但在同量级中综合能力最强,微调生态(如Chromos)正在快速涌现。
开源图像生成领域迎来了一位新玩家——MOS Image。这款仅50亿参数的文生图模型,以极低的硬件门槛(4GB显存即可运行)和惊人的知识容量,迅速在社区引发关注。据B站UP主“AI Search”的演示,它不仅能生成高质量写实与动漫图像,还支持文字渲染、布局控制和局部重绘,甚至可以通过LoRA微调实现更丰富的风格。本文基于该视频的完整教程,结合社区反馈,梳理MOS Image的核心能力、安装步骤与进阶技巧。
50亿参数如何装下“海量知识”
MOS Image最令人印象深刻的是其知识密度。UP主在视频中展示了大量开箱即用的生成案例:从名人生成、动漫角色到电子游戏人物,甚至各种品牌名称和汽车型号,模型都能准确还原,无需额外的LoRA或参考图。这种“原生知识”得益于训练数据的广度,而50亿参数的体量让它在保持小体积的同时具备了不错的泛化能力。
文字渲染是另一大亮点。演示中,MOS Image能够生成包含清晰文字、图表、信息图以及复杂设计元素的图像,这在同参数级别的开源模型中较为罕见。UP主直言:“它在文字渲染方面的表现绝对令人难以置信。”此外,模型支持非标准宽高比,可以生成超宽或超高的图像,为构图提供了更大自由度。
当然,MOS Image并非全能。与两倍参数量的Creature 2相比,画质稍逊一筹,但UP主认为这在意料之中——“如果你的GPU装不下Creature 2,或者你想以更快的速度出图,MOS Image绝对是同量级中最好的模型。”相比最接近的竞争对手Z Image,MOS在理解能力和灵活性上更胜一筹。
在ComfyUI中安装与配置
本地运行MOS Image最简单且可定制性最强的方式是使用ComfyUI。UP主推荐Windows便携版,操作流程如下:
- 更新ComfyUI:进入Update文件夹,运行
Update ComfyUI.bat,等待完成。 - 下载模型文件:在ComfyUI的模板库中搜索“MOS”,即可看到文生图和布局控制等工作流。点击缺失模型提示中的下载链接,手动将文件放入对应目录:
- Diffusion模型:放入
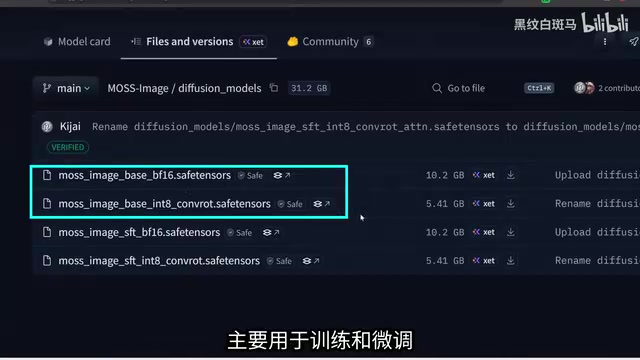
Models/Diffusion_Models,可选BF16完整版(10GB,质量更高)或INT8量化版(体积更小,低显存友好)。 - 文本编码器:放入
Models/TextEncoder,同样有BF16、INT8和W4A8版本,UP主选用最小的W4A8版本,画质损失可接受。 - VAE:放入
Models/VAE,推荐较小的250MB版本。
- Diffusion模型:放入
- 刷新模型列表,在文生图工作流中分别选择MOS Image模型、Qwen 3.5 9B文本编码器和Flux 2.0 VAE。
完成配置后,设置分辨率、提示词和采样参数即可生成。UP主使用RTX 5080(16GB显存)测试,生成一张1024x1024图像约需25秒。
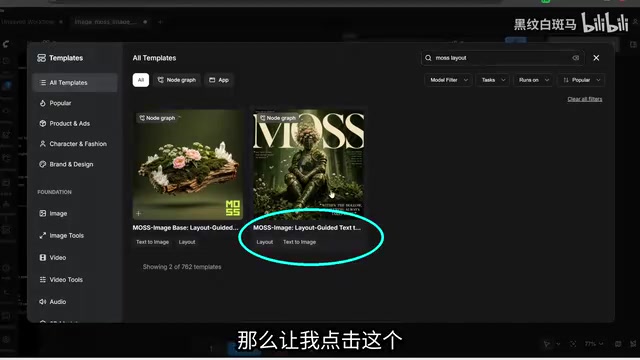
ComfyUI 是一个基于节点式工作流的开源 Stable Diffusion 图形界面,用户通过拖拽和连线的方式将模型加载、文本编码、采样、解码等步骤组合成完整流程,相比 AUTOMATIC1111 等表单式界面更灵活,也更方便复现和分享复杂管线。其“模板库”(Templates)内置了大量官方与社区工作流,点击后若缺少模型会提示下载链接,这正是文中“搜索 MOS 即可看到文生图与布局控制工作流”的机制。Windows 便携版(Portable)自带 Python 环境和依赖,解压即用,通过 Update 文件夹中的批处理脚本即可升级,无需手动配置 conda 或 git,对新手最为友好。也正因节点可自由增删,加载 LoRA、局部重绘、DMD 加速等操作都只需插入或替换节点,而不用改动代码。
文本编码器与 VAE 的分工:在 MOS Image 这类现代扩散管线中,Diffusion 模型(UNet/DiT)只负责在潜空间中去噪,真正把提示词翻译成条件向量的是独立的文本编码器。文中使用 Qwen 3.5 9B 作为文本编码器,意味着模型借助大语言模型来理解复杂提示词与文字渲染指令,这也是其文字生成能力较强的原因之一;W4A8、INT8 等后缀表示权重量化位宽,位宽越低显存占用越小、精度损失略增。VAE 则负责在像素图与潜空间之间双向转换,编码时压缩图像,解码时还原为可视图像,其质量直接影响最终画面的细节与色彩。三者必须版本匹配,否则会出现噪点、色偏或直接报错,因此工作流中要分别指定对应的模型文件。
布局控制:用边界框精准构图
MOS Image支持基于边界框的布局控制,让用户像“画草图”一样指定画面元素的位置。在工作流模板中选择“布局控制”版本(注意使用SFT模型而非Base模型),并在ComfyUI设置中启用Nodes 2.0,即可看到画布上的边界框工具。
UP主演示了一个复杂场景:在画布上分别框出“穿比基尼的女子坐在沙发上”、“红色沙发”、“摆着室内植物的茶几”、“她的右脚抬起”、“窗外有霸王龙的窗户”、“手拿可乐罐”以及“墙上的火影忍者海报”。运行后,模型精准地将所有元素放置在指定区域,甚至可乐罐上的中文标识也正确生成。这种布局控制能力为需要精确构图的场景(如海报设计、插画分镜)提供了实用工具。
用LoRA提升风格与画质
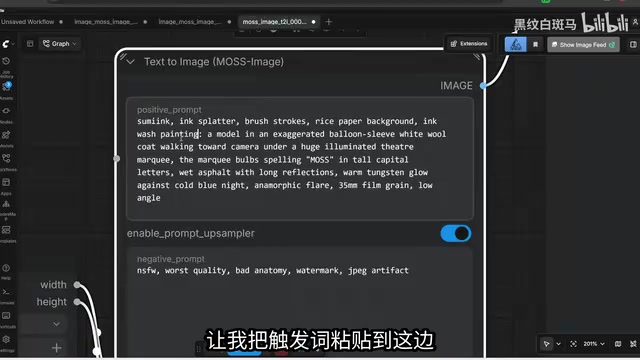
MOS Image支持加载LoRA,以扩展风格或角色表现。UP主以水墨风格LoRA为例,展示了在文生图和布局控制工作流中的加载方法:在KSampler的模型输入端前插入“加载LoRA”节点,选择LoRA文件并设置强度(通常为100%),同时需要在提示词中加入触发词。
除了风格LoRA,社区已经开始微调完整的MOS Checkpoint。例如名为Chromos的新模型,据UP主展示,其画质和一致性明显优于基础版MOS Image。使用方式很简单:下载Chromos的Checkpoint文件放入Models/Diffusion_Models,在UNet模型处直接选择即可。
提速技巧:8步DMD LoRA
默认设置下,MOS Image生成一张图约需25-30秒。通过加载8步DMD LoRA,可将速度提升3-4倍。UP主演示了具体操作:下载DMD LoRA文件放入Models/Loras,在KSampler前插入LoRA节点,强度设为1,同时将采样步数改为8,CFG设为1。需要注意的是,CFG为1时负面提示词失效,若需负面提示词,可略微提高CFG值(如1.5)。
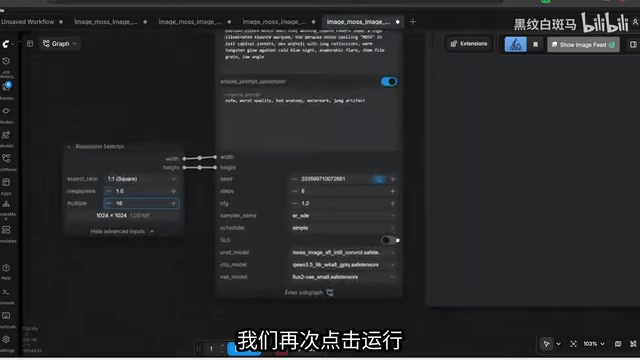
DMD(Distribution Matching Distillation,分布匹配蒸馏) 是一种把多步扩散模型蒸馏为极少步数(通常 4–8 步)生成器的加速技术:它让少步学生模型的输出分布去逼近真实数据分布,从而在几乎不损失画质的前提下大幅减少采样步数。传统扩散模型通常需要 20–30 步甚至更多才能收敛,而加载 DMD LoRA 后只需 8 步,单张图耗时随之成比例下降,这正是文中“提速 3–4 倍”的来源。由于蒸馏目标是让模型在极低步数下直接输出最终结果,采样器往往需要配合较低的 CFG(Classifier-Free Guidance)值,CFG 为 1 时等于关闭无分类器引导,负面提示词不再参与计算而失效;略微提高 CFG 可恢复部分负面提示效果,但过高会引入过饱和与伪影。
图像编辑:传统局部重绘
MOS Image本身是文生图模型,不支持像One Image 2.1或Nano Banana那样的自然语言语义编辑,但可以通过传统的局部重绘(Inpainting)实现编辑。UP主演示了将图片中的笔记本替换为熟睡的猫:在ComfyUI中加载图像、绘制蒙版,使用VAE Encode for Inpainting节点将图像和蒙版编码为潜空间,连接至KSampler,输入提示词“睡觉的猫”即可。效果虽不如专用编辑模型灵活,但足以应对简单替换需求。
局部重绘(Inpainting)与语义编辑的区别:传统局部重绘的流程是用户手绘蒙版标出待修改区域,VAE Encode for Inpainting 节点把原图与蒙版一起编码进潜空间,并在采样时只对蒙版内区域重新去噪,蒙版外像素保持不变,因此它能精准替换局部内容,但需要人工圈定范围,且模型并不“理解”整张图的语义关系。相比之下,One Image 2.1、Nano Banana 这类指令式编辑模型接收“把笔记本换成一只睡觉的猫”这样的自然语言即可自动定位并修改,灵活度更高,但可控性和局部保真度有时不如手动蒙版。MOS Image 作为纯文生图模型,只能走前一条路线,适合简单替换与元素增删;若要做大幅改构图或跨区域联动修改,仍需借助专用编辑模型。
微调与未来展望
对于想要训练专属LoRA的用户,Ostrich AI Toolkit已添加对MOS Image的支持,提供详细说明并兼容macOS。UP主认为,MOS Image在同体量级别中是目前最优秀的图像生成器,而现在的表现只是“下限”。他预测未来几天内就会出现更出色的模型权重或微调版本,“这感觉就像是SDXL时代的辉煌重演”。
综合来看,MOS Image以极低的硬件门槛和出色的知识密度,为低显存用户提供了一个高质量的开源生图选择。虽然画质不及更大模型,但其布局控制、文字渲染和活跃的微调生态,让它成为当前小参数模型中的有力竞争者。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。