4核CPU实测:相机Agent小模型选型,大模型为何翻车?
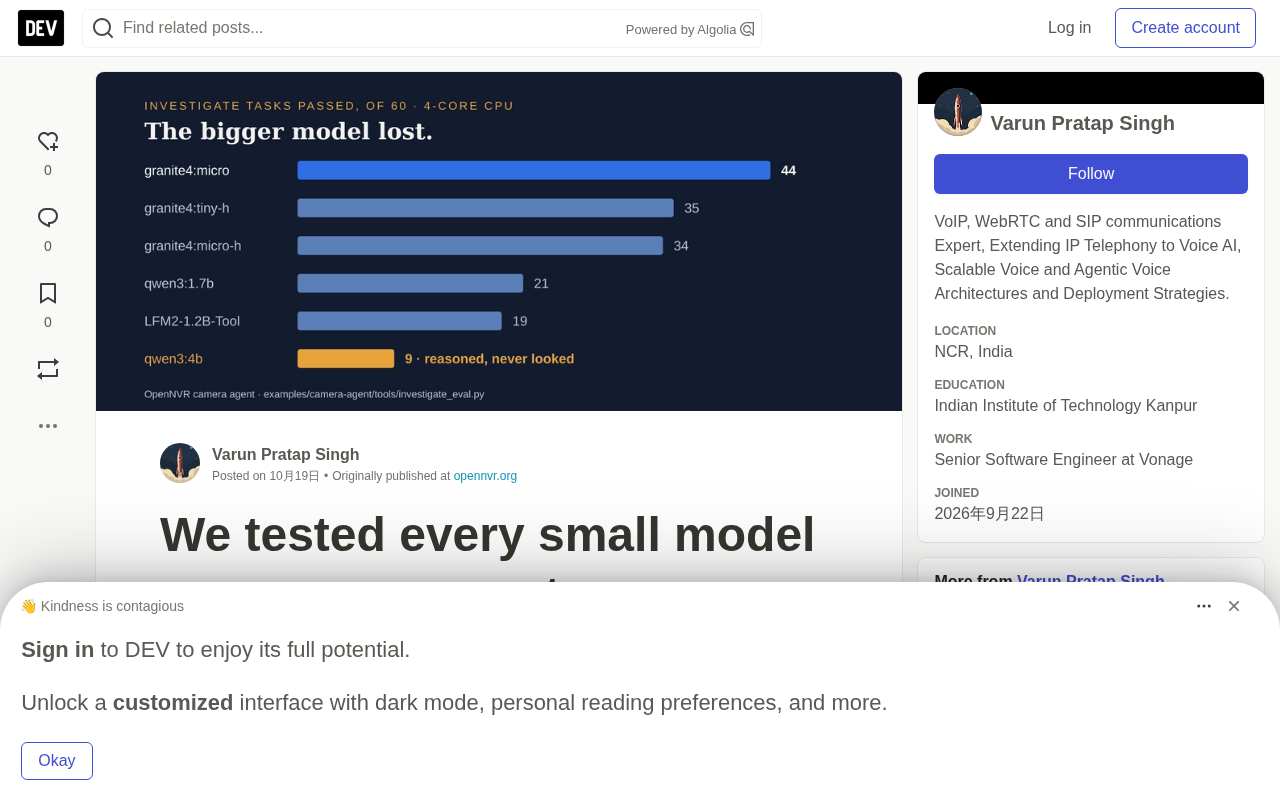
OpenNVR在4核无GPU机器上实测相机Agent各模型,用数据推翻模型声誉选型。
OpenNVR团队在4 vCPU、无GPU的硬件上,对相机Agent依赖的语言、视觉、语音识别、语音合成与搜索模型进行了标准化基准测试,并公开全部脚本与数据。结果显示:语言模型的任务通过率取决于是否在决策前调用工具,granite4:micro以44/60远超参数量更大的qwen3:4b(9/60);视觉模型Qwen3-VL准确率最高但CPU读一帧需18秒,故CPU环境保留7.6秒的Moondream;Parakeet在语音识别上错误率减半且快4倍,取代Whisper;Piper因实时率0.23x优于Kokoro的1.9x而保留;搜索改用质量更高的SigLIP 2。文章提炼出三条经验:工具调用比参数量重要、慢答案等于坏答案、必须在用户实际硬件上测试。
在边缘设备上部署AI,模型选型往往靠猜。OpenNVR维护者做了一次硬核测试:在无GPU的4核CPU上跑遍相机Agent依赖的所有模型,结果颠覆了不少常识。
测试背景:当Agent没有GPU
OpenNVR是一个内置相机Agent的开源视频录像机,支持查询摄像头状态、布防报警、检索历史录像等功能。大多数用户没有GPU,只有一台4核小型PC。过去团队像许多开源项目一样,依赖模型声誉做选择。这次他们决定用数据说话:在4 vCPU、无GPU的机器上,对Agent涉及的每个模型进行标准化测试,所有脚本和原始数据都公开在代码库中。
测试覆盖五类任务:语言模型(工具调用与多步调查)、视觉模型(标注图像问答)、语音转文字(词错误率)、文本转语音(实时率与可懂度)、搜索(文本描述找图像)。所有计时均基于4个CPU线程。
语言模型:工具调用比参数量更重要
团队设计了20个调查案例(如“凌晨1:14装卸区有人”),模型需检查摄像头、历史记录和现场规则后做出判断。每个案例运行3次,共60次。
| 模型 | 通过数 | 决策前检查工具的次数 |
|---|---|---|
| granite4:micro | 44/60 | 56/60 |
| granite4:tiny-h (7B MoE, 1B active) | 35/60 | 49/60 |
| qwen3:1.7b (旧默认) | 21/60 | 36/60 |
| LFM2-1.2B-Tool | 19/60 | 37/60 |
| qwen3:4b | 9/60 | 9/60 |
最令人意外的是qwen3:4b:参数量更大,通过数却不到qwen3:1.7b的一半。查看轨迹后发现原因简单:它思考很久却几乎不调用工具,完全凭猜测决策。相比之下,Granite 4 micro每次回答前平均调用约两个工具,仅此一点就让通过率翻倍有余。虽然它每轮响应速度约慢一倍,但调查任务在后台运行,延迟可接受,因此团队将其设为新默认。
测试还暴露了Agent自身的一个bug:此前要求模型描述前必须查看,导致用户说“谢谢,就这样”时,Granite也去检查摄像头。修复后,闲聊不再触发工具调用,这一改进对所有模型都有效。
MoE(混合专家)与小激活参数:granite4:tiny-h 标注的“7B MoE, 1B active”指该模型总参数量为70亿,但采用混合专家架构——每次前向推理只激活其中约10亿参数(路由到少数“专家”子网络)。这意味着它的计算量和显存占用接近1B级稠密模型,而知识容量接近7B级模型。在CPU场景下,决定延迟的是实际参与计算的激活参数而非总参数量,这正是MoE适合边缘部署的原因。不过MoE对内存带宽更敏感,权重仍需全部载入,因此7B权重在4核小机器上的加载与内存占用仍不可忽视。
工具调用(Tool Calling):指LLM在生成回答前,按约定格式输出结构化请求(如JSON),调用外部函数(查摄像头状态、检索录像)并读取返回结果,再继续推理。Agent能否可靠地“先查后答”,取决于模型是否被工具调用数据微调过、是否支持函数调用模板。参数规模并不直接决定这一能力——小模型若经过针对性训练,可以在多步调查中稳定触发工具,而大模型若未对齐该行为,可能倾向于凭内部知识直接作答。这也解释了为何参数量与任务通过率在本测试中并非正相关。
视觉模型:准确性 vs. 延迟的权衡
使用128张标注图像,每张问3个问题:一个关于图中存在的事物,一个关于不存在的事物(答“是”即为幻觉),一个要求数人数。
| 模型 | 错误“是”数(共126) | 人数误差≤1(共61) | 每新帧CPU耗时 |
|---|---|---|---|
| qwen3-vl:2b-instruct | 0 | 50 | 18秒(后续问题免费) |
| gemma3:4b | 8 | 48 | 17秒 |
| moondream 0.5b | 22 | 42 | 7.6秒 |
Qwen3-VL从未对不存在的事物说“是”,在GPU上约3秒即可回答,因此成为有GPU时的默认。但在4核CPU上,仅读取一帧就需要18秒——若有人出现在门口,18秒后的答案已失去意义。因此CPU环境保留Moondream。
使用Ollama时需注意:qwen3-vl:2b标签是思考版,会忽略think: false,应使用-instruct标签。
词错误率(WER):语音识别的标准评价指标,计算为(替换词数+删除词数+插入词数)÷ 参考文本总词数,越低越好。1.4% 与 3.3% 看似差距不大,但在实际体验中意味着每100个词分别约1.4个和3.3个错误,对短指令(如“打开前门灯”)而言,错误率翻倍会显著提高误解概率。需注意 WER 对专有名词、数字和口音敏感,测试集的构成会直接影响结论,因此跨模型比较应尽量使用同一测试集。
实时率(RTF):文本转语音中衡量速度的指标,RTF=生成音频所需时间÷音频时长。RTF<1 表示合成速度快于播放速度,可实时输出;RTF>1 则生成跟不上播放,会造成中途卡顿。Kokoro 的 1.9 倍实时意味着生成10秒语音需约19秒计算,在对话式Agent中不可接受;Piper 的 0.23 倍则留有充足余量。RTF 与硬件强相关,GPU上结论可能完全相反,这也是文章强调在目标硬件实测的原因。
语音识别与合成:速度决定选择
语音转文字结果毫无悬念:Parakeet TDT 0.6B v3(onnx-asr, int8)词错误率仅1.4%,每句耗时0.31秒;而faster-whisper base.en(int8)错误率3.3%,耗时1.42秒。Parakeet错误率减半、速度快4倍多,语音识别从最慢步骤变为仅需三分之一秒。但Parakeet不支持翻译和印地语,需要这些功能的站点仍保留Whisper。
文本转语音方面,Kokoro-82M音质优于Piper,但在4核上运行速度为实时的1.9倍——生成音频比播放还慢,回复会中途停顿。Piper仅需0.23倍实时,因此保留Piper。
搜索与检测:质量优先
对于“码头上的红色卡车”这类描述搜索,SigLIP 2 B/16的mAP为0.672,高于CLIP ViT-B/32的0.571。虽然每图耗时57ms(CLIP为26ms),但搜索质量更重要,因此设为默认。升级后OpenNVR会自动重新嵌入旧录像。
常开检测器从YOLOv8n升级到YOLO26n:每帧62ms(原75ms),精度略有提升,输出格式不变。
关键发现:硬件决定选型
这次测试揭示了边缘AI部署的三条经验:
- 对Agent而言,工具调用比模型大小更重要。 是否在决策前检查工具,比参数数量影响更大。
- 在摄像头上,慢答案等于坏答案。 8秒的好答案胜过18秒的最佳答案。
- 在用户实际拥有的硬件上测试。 许多排名在GPU上会翻转,而大多数用户没有GPU。
团队还留下一个未解难题:寻找参数小于2B、在CPU上5秒内读完一帧且不产生幻觉的视觉模型。所有测试脚本和原始数据已公开在OpenNVR仓库,欢迎其他硬件上的测试结果以PR形式提交。
这次测试的价值不仅在于四个默认模型的更换,更在于示范了一种方法论:开源项目应基于可复现的基准做技术选型,而非盲目追随模型声誉。对于资源受限的边缘AI应用,这种务实态度尤为可贵。
背景补充
mAP(平均精度均值):图像检索中常用的排序质量指标,先对每张图计算精度-召回曲线下的面积(AP),再对所有查询取平均。它同时考量“正确图像是否排在前面”和“召回是否充分”,比单纯的Top-1命中率更全面。SigLIP 2 的 0.672 与 CLIP 的 0.571 差距约0.1,在检索任务中属于明显可感知的提升——意味着用户用自然语言描述查找录像时,目标片段更靠前出现。此外,更换嵌入模型后旧录像的向量需重新计算(文章提到自动重新嵌入),因为不同模型的向量空间不兼容,混用会导致检索结果错乱。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。