445字节绘制世界地图:deflate压缩与浏览器原生API的极致运用

用445字节生成一张世界地图
在追求数据规模越来越大的时代,一个反其道而行之的项目引发了技术社区的热议。开发者 Iwo Kadziela(在 Codex 辅助下)用仅仅 445 字节的数据,生成了一张相当逼真的 ASCII 世界地图。整幅地图由黑色星号(*)字符渲染而成,虽然是纯文本,但大陆轮廓清晰可辨,可信度出人意料地高。
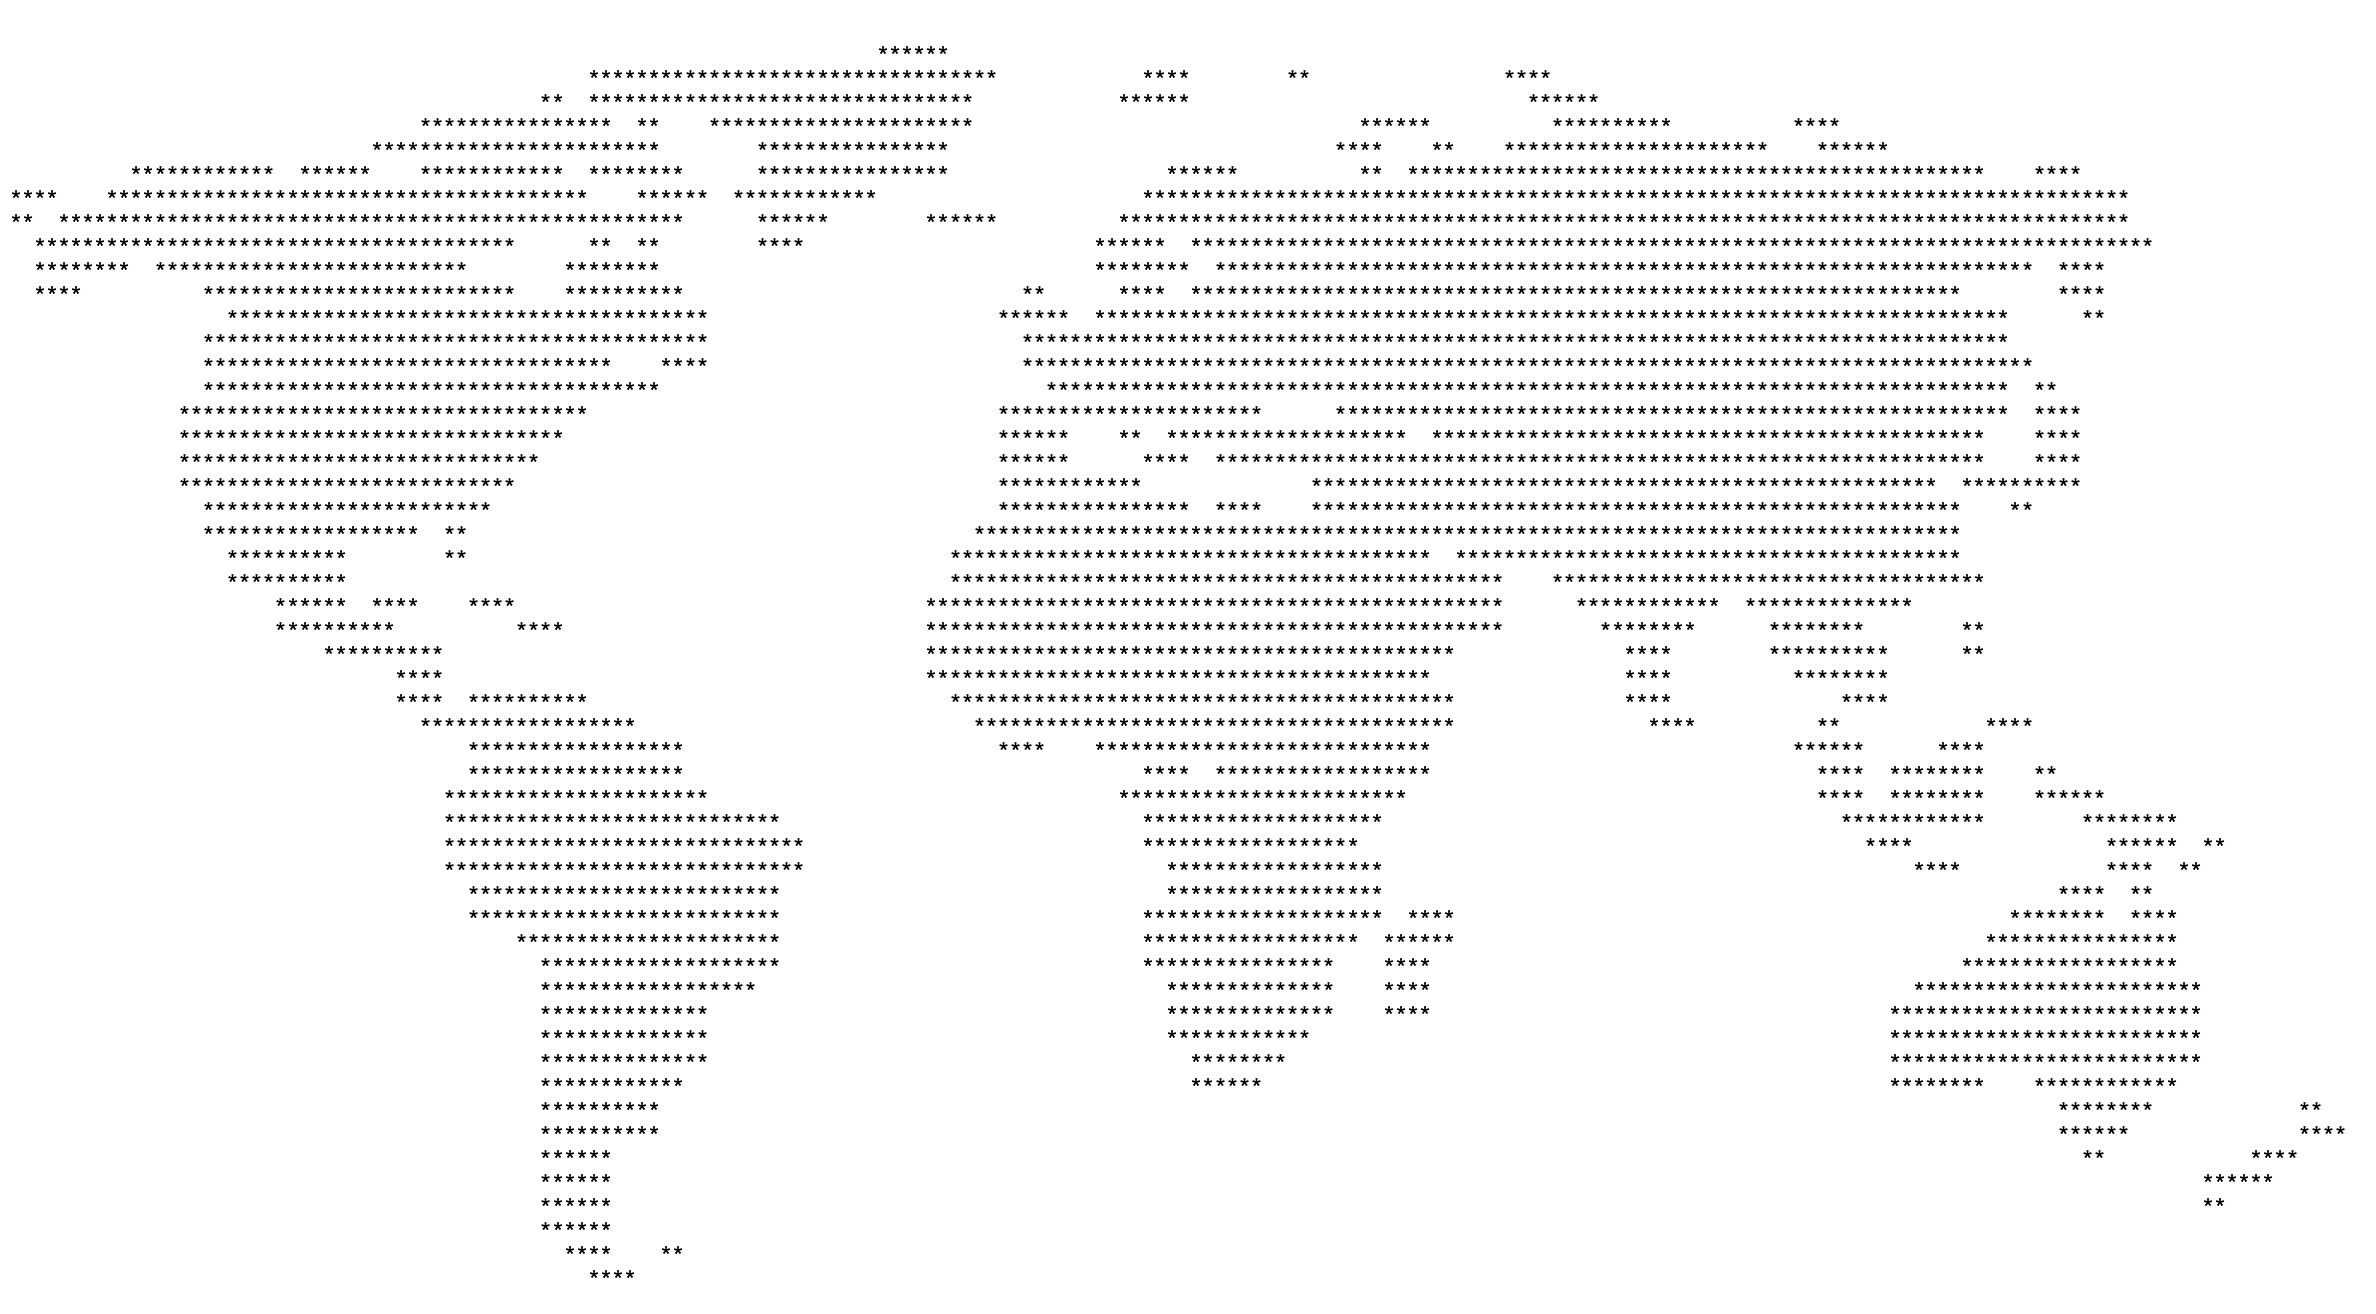
这个项目的价值不在于解决了什么实际业务问题,而在于它展示了一种极致的工程思维:当你把"最小化数据体积"作为唯一目标时,究竟能压榨出多少信息密度?445 字节大约相当于一小段文字的长度,却承载了整个地球陆地分布的空间信息。值得注意的是,445 字节是经过 base64 编码之后的最终大小——base64 会引入约 33% 的体积膨胀(每 3 个原始字节被编码为 4 个 ASCII 字符),这意味着实际压缩后的二进制数据仅约 333 字节,信息密度更为惊人。
这一膨胀率并非偶然,而是有精确的信息论根据:原始二进制数据使用完整的8位字节空间(256个符号),而 base64 将数据限定在64个可打印 ASCII 字符的子集内(log₂64=6位有效信息),因此每个字节只携带6位有效信息而非8位,膨胀比恰好为 8/6≈1.333。这一代价换来的是「任意二进制数据均可安全嵌入文本协议」的能力——在 JSON 字段、HTML 属性、JavaScript 字符串等纯文本环境中传递二进制数据时,base64 几乎是唯一的标准化选择。RFC 4648 还定义了 base64url 变体,将 + 和 / 替换为 - 和 _,使编码结果可直接用于 URL 参数,在 JWT(JSON Web Token)等现代认证方案中被广泛采用。
deflate 压缩:核心技术原理
实现这一效果的关键,是 deflate 压缩算法的巧妙运用。deflate 由 Phil Katz 于 1989 年设计,并在 RFC 1951 中正式规范,是互联网基础设施中应用最广泛的无损压缩算法之一——PNG 图片格式、HTTP/1.1 的 gzip 传输压缩、ZIP 文件均以它为核心。它组合了两种经典技术:LZ77 滑动窗口算法与哈夫曼编码。
LZ77 由 Abraham Lempel 和 Jacob Ziv 于1977年提出,是现代无损压缩的奠基性算法。其核心思想是维护一个「滑动窗口」,在已处理的数据中查找与当前待编码序列匹配的最长子串,用「偏移量+长度」的紧凑引用替代原始字节,从而消除重复字节序列。这一机制之所以有效,根源在于 Shannon 信息论的核心洞见:真实世界的数据分布远非均匀,存在大量统计冗余。
Claude Shannon 在其1948年的奠基性论文《通信的数学理论》中证明,任何无损压缩算法都无法将数据压缩至其信息熵以下——这是一个数学上可证明的绝对限制,而非工程上的经验约束。信息熵公式 H=-Σp(x)log₂p(x) 精确描述了一个随机变量的平均信息量,为所有压缩算法划定了不可逾越的理论下界。Shannon定理的另一重要推论是:对于真正的随机数据(如加密后的密文),任何压缩算法都无法减小其体积,这也是为什么正确的处理顺序应当是先压缩后加密——LZ77 正是通过识别并消除这些统计冗余来逼近该理论极限。哈夫曼编码则由 David Huffman 于1952年在 MIT 读博期间发明,通过构建最优前缀树,将高频符号映射到更短的位串,理论上逼近信息熵下界。
Phil Katz 将两者结合设计出 deflate 时,创造了一个在压缩率与计算复杂度之间取得绝佳平衡的算法——LZ77 负责消除长程重复(字典式压缩),哈夫曼编码负责消除局部符号频率不均匀性(熵编码),两个维度的冗余被同时攻克。这也是它在资源受限的1980年代末能够迅速普及,并沿用至今三十余年的根本原因。值得一提的是,Lempel 和 Ziv 后来还在1978年发表了 LZ78 算法,并由此衍生出 LZW(Lempel–Ziv–Welch)算法,被用于早期 GIF 图片格式——但因专利纠纷在1990年代引发了著名的"GIF专利危机",最终推动了 PNG 格式的诞生,而 PNG 正是基于无专利纠纷的 deflate 算法。
本项目使用的是其变体 deflate-raw——即去除 zlib 包装头的纯压缩流。这里有一个细节值得关注:zlib 格式(RFC 1950)在 deflate 压缩数据外额外包裹了2字节的头部(用于标识压缩方法与窗口大小等标志位)和4字节的 Adler-32 校验和尾部,总计引入6字节的格式开销。Adler-32 是一种滚动校验算法,由 Mark Adler 设计,计算速度比 CRC-32 更快,但检错能力略弱——对于网络传输场景已足够可靠。然而对于本项目333字节量级的核心数据而言,6字节的额外开销占比接近2%,在追求极限压缩的场景下完全值得规避。浏览器的 DecompressionStream API 对 deflate-raw 单独提供了支持,正是为了覆盖这类需要操作原始压缩流而不需要 zlib 包装语义的使用场景。
为什么 ASCII 艺术特别适合压缩
压缩算法的本质是消除冗余。一张 ASCII 地图中,海洋区域是大片空白,陆地边缘也存在大量重复图案。deflate 的 LZ77 阶段能够精准识别这些重复模式,用极短的"向前引用"替代冗长的原始序列;哈夫曼编码阶段再对高频字符(如大量出现的空格)进一步压缩。两者叠加,使得视觉上信息量丰富的地图,压缩后可以缩小到几百字节量级。
从信息论角度量化这一直觉:一张典型 ASCII 地图中,若空格占全部字符的70%以上,则该字符集的实际信息熵远低于理论上限(若字符均匀分布,每字符携带 log₂N 位信息)。哈夫曼编码能将空格编码为仅需1-2位的符号,非空格字符则接受较长编码,整体平均码长大幅缩短。这正是"数据的统计特性越不均匀,压缩效果越显著"这一信息论原理的具体体现——对于真正均匀随机的数据(如加密密文),这种方法将完全失效,任何压缩尝试反而会轻微增大体积。
原始未压缩文本可能有数千字节,经过 deflate 处理后再做 base64 编码(RFC 4648 定义的标准方案,将任意二进制数据转为可打印 ASCII 字符),整个数据 payload 变得极其紧凑,可以直接内联到一段 JavaScript 代码中。虽然 base64 编码带来约三分之一的体积代价,但换来了可直接写入字符串的便利性,无需处理二进制文件加载问题。
巧妙的浏览器端解压方案
这个项目最令人眼前一亮的,是它在浏览器端的实现方式。整个解压与渲染逻辑浓缩在一小段简洁的 JavaScript 中:
fetch('data:;base64,1ZpLsgIxCEXnrM...==').then(
  r => r.body.pipeThrough(new DecompressionStream('deflate-raw'))
).then(
  s => new Response(s).text()
).then(
  t => b.innerHTML = '<pre style=font-size:.65vw>' + t
)
三个值得深挖的技术细节
第一,用 fetch() 请求 data: URI。 连资深开发者 Simon Willison 都坦言此前不知道可以这样用。data: URI 由 RFC 2397 于 1998 年定义,格式为 data:[<mediatype>][;base64],<data>,最初被设计用于在 HTML 中内嵌小图片以避免额外 HTTP 请求——在 HTTP/1.1 时代,浏览器对同一域名的并发连接数有严格限制(通常为6个),每个额外请求都有显著代价,data: URI 因此成为前端性能优化的常用手段。
然而随着 Web 安全意识的提升,各浏览器厂商逐步收紧了 data: URI 的使用范围。现代浏览器已禁止从 data: URI 导航到顶级浏览上下文(即禁止在地址栏直接输入 data:text/html,... 来加载页面),Firefox 和 Chrome 在2017-2019年间陆续实施了这一限制,原因是攻击者曾利用 data: URI 构造钓鱼页面绕过域名检查。与 fetch() 结合使用,则是一个真正的「边界用法」——fetch 规范并未明确禁止,浏览器实现者选择了将其视为立即可用的同步虚拟响应,从而意外地开启了这条将内联数据无缝接入 Streams 管道的通路。浏览器会将其当作同步可用的"虚拟响应"处理,返回标准的 Response 对象,可完整接入 Streams API 管道。这里将 base64 编码的压缩数据直接嵌入 URI,无需发起任何真实网络请求,数据完全内联在代码中。
第二,DecompressionStream 原生解压。 这是基于 WHATWG Compression Streams 规范实现的现代浏览器内置 API,属于 Web Streams API 生态的一部分。Web Streams API 的标准化历程颇为漫长——Node.js 在2009年引入了自己的流模型(基于 EventEmitter 的回调式架构),但浏览器端长期缺乏对应的原生抽象,两种环境之间的碎片化割裂长期困扰着跨平台代码复用。WHATWG 从2014年开始起草 Streams 规范,核心争议集中在背压机制的 API 形态和 TransformStream 的接口设计上,历经多年迭代才在主流浏览器中全面落地。直到2018-2020年间,随着 Fetch API 和 Service Worker 的普及,Streams API 才真正获得广泛采用的生态基础。
该生态为浏览器引入了类似 Node.js 流的处理模型,核心概念包括 ReadableStream、WritableStream 与 TransformStream;其中 TransformStream 的背压(backpressure)机制尤为重要——它确保即使处理大型流时,内存占用也保持可控,不会因为生产者速度远超消费者而导致缓冲区爆炸。背压机制通过内部队列(internal queue)和所谓的"期望字节数"(desiredSize)信号实现:当下游消费者处理速度变慢时,ReadableStream 会向上游传递信号,主动暂停数据的读取或生产。这一设计的实际意义在于,同样的 pipeThrough(new DecompressionStream(...)) 代码模式,既能无缝处理本项目中仅333字节的微型压缩包,也能在不修改任何代码的情况下安全解压数百MB的大型压缩文件,而不会因全量载入内存而引发 OOM(内存溢出)。DecompressionStream 本质上是一个内置 TransformStream,支持 deflate、deflate-raw 和 gzip 三种格式,Chrome 80+、Firefox 113+、Safari 16.4+ 均已原生支持。在此之前,前端若需浏览器端解压,通常要引入 pako 等第三方库(体积约 50KB+)。通过 pipeThrough(new DecompressionStream('deflate-raw')) 将响应体导入解压流,全程零依赖,运行时开销几乎为零。
第三,Streams API 的优雅链式管道。 从 fetch 获取响应,到 pipeThrough 解压,再用 new Response(s).text() 将解压后的流转回文本,最后写入 DOM——整个过程是一条干净的 Promise 链,充分展现了现代浏览器 Streams API 的组合能力。这里有一个值得关注的技巧:new Response(s).text() 利用了 Response 构造函数能接受 ReadableStream 作为 body 参数这一特性,将流式数据优雅地转换为 Promise<string>,避免了手动拼接 Uint8Array 分块的繁琐操作。这种"以标准 Web API 互相组合"的编程风格,正是平台原生能力成熟的标志。
从这个项目能学到什么
浏览器原生能力已今非昔比
这个 445 字节世界地图最深刻的启示,是现代 Web 平台原生 API 的能力已相当强大。DecompressionStream、fetch 对 data: URI 的支持、Streams API 的管道机制——这些过去往往需要引入数十 KB 第三方库才能实现的功能,如今浏览器已原生内置。开发者只需几行代码,就能完成压缩数据的内联传输与解压渲染。这也提醒我们,在引入新依赖之前,不妨先查阅一遍平台的原生 API 清单——答案可能已经内置其中。
AI 辅助催生"工程玩具"新范式
值得一提的是,这个项目在 Codex 的辅助下完成。OpenAI Codex 于2021年8月正式发布,基于 GPT-3 架构,在 GitHub 公开代码库上进行了专项微调,训练数据涵盖数十种编程语言的数十亿行代码——与通用语言模型相比,Codex 在理解 API 调用约定、识别非主流但合法的语言特性方面具有独特优势,因为这些「边缘知识」在技术博客、Stack Overflow 答案和规范文档中大量存在,恰好是预训练语料的密集覆盖区域。2022年 GitHub Copilot 正式商业化后,Codex 逐渐被更新一代的专用代码模型取代,但其作为「AI辅助编程」商业化先驱的历史地位已经确立。在本项目中,Codex 扮演的角色更像一位「API百科全书」:它能在人类开发者尚未意识到某个原生 API 存在的情况下,直接给出利用该 API 的最优实现路径。这种"人类提出极限约束、AI 探索实现空间"的协作模式,体现了一种有趣的创作范式。这类"工程玩具"虽无直接商业价值,却是激发创造力、探索平台边界的绝佳方式,也正在技术社区中形成一种新兴的创意表达形式。
约束驱动的工程美学
从更宏观的角度看,这个项目提醒我们重新审视"数据体积"与"信息价值"的关系。在存储和带宽日益廉价的今天,很少有人会为几百字节精雕细琢。但正是这种约束驱动的思考,往往能催生最优雅的解决方案——当限制足够严苛时,工程师会被迫回归问题本质,找到所有可以消除冗余的角落。
这一工程哲学在计算机历史上有着鲜明的传承:demoscene(演示场景)文化自1980年代兴起于欧洲地下软件破解社区,程序员们最初在破解游戏时会附加自己的"签名演示"以展示技术实力,随后逐渐演化为一种专注于极限字节约束下创作实时图形与音乐的独立亚文化。在严格的字节限制下(4KB、64KB 乃至1KB),参赛作品必须是可独立运行的可执行文件,却能实时渲染出媲美专业3D动画的视觉效果。这一社区在技术方法论上形成了独特的积累:程序化内容生成(procedural generation)用数学公式替代预存资产,使同样的字节预算能描述无限复杂的视觉内容;可执行文件紧凑打包技术(executable packing)则将自定义引导解压器与压缩内容捆绑为单一可执行文件。
这与本项目将 deflate 数据内联至 JavaScript 的思路高度同构——本质上都是"将解压器与数据共同交付,在运行时还原完整内容"的架构模式。两者的区别仅在于执行环境:demoscene 作品以本机 CPU 指令集为目标平台,而本项目以浏览器 JavaScript 引擎为目标平台;前者的"解压器"是手工优化的汇编引导程序,后者的"解压器"则是浏览器内置的 DecompressionStream。demoscene 文化孕育了程序化纹理生成、早期实时光线追踪探索乃至现代GPU着色器编程的若干先驱思路,并在2020年被联合国教科文组织列入芬兰非物质文化遗产名录。deflate 算法本身也是这种精神的产物:在 1980 年代末存储极度昂贵的年代,对每一个字节的极致珍视,孕育出了沿用至今三十余年的压缩标准。
小结
用 445 字节画出可辨识的世界地图,本质上是一次对压缩算法、编码技巧与浏览器原生能力的综合展示。它没有解决宏大的问题,却以极简的方式揭示了 Web 技术栈中常被忽视的精妙之处。对开发者而言,这个项目留下了几个立即可用的知识点:fetch() 能直接消费 data: URI 并返回标准 Response 对象;DecompressionStream 让浏览器端 deflate 解压触手可及且零依赖,且其基于背压机制的流式架构使同一套代码模式既能处理333字节的微型数据也能驾驭数百MB的大型压缩文件;deflate-raw 相较于 zlib 格式省去了6字节的头部与校验和开销,在极限压缩场景下每一字节都值得计较;base64 的 33% 膨胀代价(源自6位有效信息对8位字节空间的利用率差异)换来了二进制数据的字符串内联能力;LZ77 与哈夫曼编码自1970-80年代奠定的理论基础,至今仍是互联网压缩基础设施的核心——而它们的理论上限,早在1948年就已被 Shannon 的信息熵公式划定,且该上界对随机数据具有不可突破性,这也正是加密应先于压缩执行的工程原则的数学根源。有时候,最小的项目反而能教会我们最多。
核心要点
相关推荐

NFL为何重金押注旗帜橄榄球?安全与商业的双重博弈
NFL为何重金投资没有擒抱对抗的旗帜橄榄球?本文解析CTE脑病争议、女子体育数十亿美元市场与奥运机遇如何共同驱动联盟布局橄榄球的未来。

Asana浏览器智能体成本降76倍:GPT-6模型优化实测
Asana借助OpenAI的GPT-6 Astra模型与Codex工具,在浏览器智能体测试中将模型成本降低76倍、速度提升5倍。本文解读这一工程优化案例对企业AI落地的成本与性能启示。

@ai-sdk/vue 3.0.303 发布:依赖更新的补丁版本
@ai-sdk/vue 3.0.303 补丁版本发布,核心为依赖项同步升级,核心包 ai 升级至 6.0.303。本文解析该 Vue AI SDK 更新内容及对开发者的意义。