5B参数Moss Image实测:低显存本地生图新王者
5B 参数的 Moss Image 以高知识密度、边界框布局控制和低显存门槛,成为轻量开源文生图的新选择。
Moss Image 是一款 50 亿参数的开源文生图模型,在同参数量级中理解力与灵活度领先,开箱即可生成名人、动漫角色、品牌 Logo 和复杂信息图,量化版可在 4GB 显存运行。它支持边界框布局控制,能精确执行多元素空间约束,这是其区别于小模型的核心能力。通过 ComfyUI 部署时按显存选择 BF16 或 Int8 扩散模型、相应量化的文本编码器和精简 VAE;叠加 8 步 DMD LoRA 可提速三到四倍,代价是负面提示词失效。短板是不支持自然语言语义编辑,只能靠遮罩局部重绘变通。社区微调 checkpoint 已显著提升画质。
开源文生图模型又迎来一位轻量级选手。Moss Image 以 5B 参数实现了对复杂图表、名人知识、动漫角色乃至品牌 Logo 的精准生成,量化版本甚至能在 4GB 显存下运行。本文基于实测视频,梳理它的能力边界、ComfyUI 安装流程,以及提速与编辑的实用技巧。
轻量级定位:5B 参数的能力天花板在哪
Moss Image 是一款纯文本到图像生成器,参数规模 50 亿。与当前开源阵营的头部模型相比,它明显更小——视频作者指出,领先的 CREA 2 体积超过它的两倍,质量确实更好,但 Moss Image 在同等参数量级里没有对手,理解力和灵活度都优于 6B 的 Z-Image。
真正让人意外的是知识密度。无需挂载 LoRA 或参考图,模型开箱即可生成名人肖像、动漫角色、游戏人物,甚至对汽车型号和品牌名有不错的还原度。文字渲染同样出色,复杂信息图和带标注的示意图都能一次成型,这也是它区别于多数小模型的差异点。
安装与模型选择:显存决定配置
官方推荐通过 ComfyUI 本地部署。更新到最新版后,在模板栏搜索 Moss 即可看到两套工作流:SFT 版面向图像生成,Base 版面向训练与微调,普通用户直接选 SFT 即可。
模型下载有三个关键组件,选择逻辑都围绕显存展开:
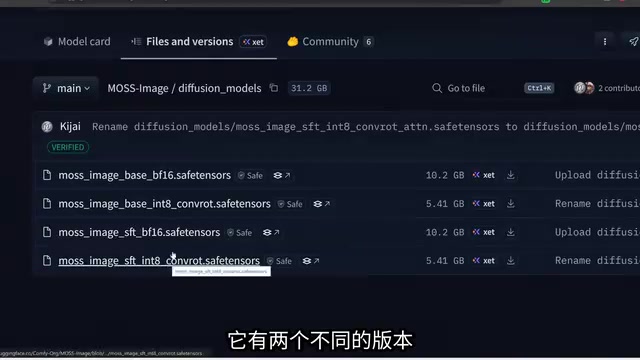
- 扩散模型:完整 BF16 版约 10GB,质量更高,建议 8GB 以上显存使用;Int8 ConvRot 压缩版体积减半,适合低显存设备。
- 文本编码器:提供 BF16、Int8、W4A8 三档,显存紧张时选最小的 W4A8,画质损失可接受。
- VAE:完整版与 250MB 精简版,后者足以应对日常生成。
下载完成后按 R 刷新模型列表,依次选择扩散模型、Qwen 3.5 9B 文本编码器和 Flux 2 Small VAE 即可开跑。作者在 16GB 显存的 RTX 5000 Ada 上测试,1024×1024 单图生成约 25 秒。
关于文本编码器与 VAE 的作用
在扩散模型工作流中,文本编码器负责将用户输入的提示词转换为模型可理解的语义向量,其规模与精度直接影响对复杂描述的理解能力。Moss Image 采用 Qwen 3.5 9B 作为文本编码器,参数量远大于扩散模型本身,这正是它能理解名人、品牌、动漫角色等长尾知识的關鍵。Int8 与 W4A8 量化通过降低权重位宽来压缩显存占用,W4A8 表示权重 4 位、激活 8 位,画质损失通常在可接受范围内。
VAE(变分自编码器)则负责在像素空间与潜空间之间转换:生成时把扩散模型输出的潜变量解码为最终图像,编辑时把输入图像编码回潜空间。精简版 VAE 通过剪枝或蒸馏减小体积,日常生成几乎看不出差异,但在高分辨率或精细纹理场景下完整版更稳。
布局控制:用边界框精确指挥构图
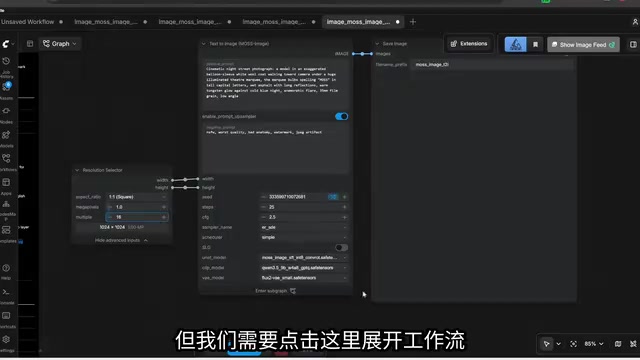
Moss Image 支持基于边界框的布局控制,这是它拉开与小模型差距的功能。在画布上画出区域并分别填写描述,模型会严格按照空间关系组织画面。
实测案例中,作者同时指定了穿比基尼的女性、红色沙发、带绿植的咖啡桌、抬起的右脚、窗外霸王龙、手持可乐罐以及墙上的火影海报。生成结果里所有元素各就各位,可乐 Logo 甚至拼写正确——只是自动变成了中文版本。这种多元素、多空间约束的稳定执行能力,在 5B 量级相当罕见。
需要提醒的是,若界面提示节点版本不兼容,需在设置中开启 Nodes 2.0 才能正常显示边界框编辑器。
边界框布局控制的原理
边界框(bounding box)布局控制本质上是一种空间条件注入:用户在画布上划定的每个矩形区域及其文本描述,会被编码为区域掩码与位置嵌入,与全局提示词一同送入扩散模型,在去噪过程中约束对应区域的语义归属。这与 ControlNet 的深度图、边缘图引导不同,它不依赖参考图像,而是直接用文本加坐标描述构图,因此更适合需要精确排布多个主体的信息图、海报和示意图。
该能力对模型的注意力机制和训练数据标注质量要求很高,小参数量模型往往难以稳定执行多区域约束。Moss Image 能在 5B 规模下做到多元素各就各位,说明其训练阶段引入了大量带空间标注的图文对。使用时要确保 ComfyUI 前端版本支持节点 2.0,否则边界框编辑器不会渲染。
LoRA 扩展与社区微调
模型本身的知识储备已足够丰富,但叠加 LoRA 能进一步定制风格。视频演示了墨绘风格 LoRA 的接入方式:在采样器前的模型输入链路中插入 Load LoRA 节点,选择权重后填入触发词,写实类关键词要相应移除,否则风格会被抵消。布局控制工作流的挂载方式完全相同。
社区已经开始产出全量微调 checkpoint。例如 CrowMoss 在一致性和观感上明显优于原始版本,替换扩散模型下拉选项即可启用。作者判断,随着微调生态铺开,Moss Image 的画质上限还会持续抬升,当前版本只是起点。
三倍提速与图像编辑的变通方案
速度优化靠一个 8 步 DMD LoRA。挂载后将采样步数从默认的 25 降到 8,CFG 设为 1,速度提升约三到四倍。代价是 CFG 为 1 时负面提示词完全失效,若仍需排除某些元素,可以把 CFG 略微上调几个小数位。
编辑能力是 Moss Image 的短板。它不支持自然语言语义编辑,无法像 Qwen Image 2.1 那样直接说"把笔记本换成猫"。变通做法是传统局部重绘:加载图片并手绘遮罩,用 VAE Encode for Inpainting 节点将图像与遮罩送入潜空间,替换采样器的宽度高度输入,再填写遮罩区域的生成描述。实测能把笔记本替换为睡猫,但灵活度与语义编辑模型有本质差距。
DMD LoRA 与 CFG 的取舍
DMD(Distribution Matching Distillation,分布匹配蒸馏)是一种将多步扩散采样蒸馏为少步采样的加速技术:它训练一个学生模型去匹配教师模型多步采样的输出分布,从而用 4 到 8 步复现原本 25 步以上的效果。以 LoRA 形式挂载的 DMD 适配器体积小、即插即用,不需要重新训练整个模型。
CFG(Classifier-Free Guidance)控制生成结果对提示词的贴合强度,通常取值 4 到 7。CFG 为 1 时,模型不再同时计算无条件分支,负面提示词因此完全失效,但采样速度最快。若仍需排除某些元素,可将 CFG 上调至 1.5 到 2 左右,在速度与可控性之间取得折中。
局部重绘的工作流要点
Inpainting 依赖遮罩告诉模型哪些像素需要重新生成。VAE Encode for Inpainting 节点会把原图、遮罩和遮罩羽化一并编码进潜空间,采样器只在该区域去噪,其余部分保持原样。将采样器的宽高输入替换为原图尺寸,是为了避免潜空间尺度不匹配导致的接缝或变形。
适合谁用
低显存用户、需要快速批量出图的创作者、以及想研究小模型知识压缩能力的技术人员,都能从 Moss Image 中获得价值。追求极致画质且显存充裕的用户,CREA 2 仍是更优解。但在这个参数量级上,Moss Image 目前没有真正的对手,而微调生态的展开会让它变得更强。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。