5分钟本地部署开源视频模型MiniMax H3,省下云端生成费

UP主演示用ComfyUI三步本地部署MiniMax H3,成本归零、速度翻倍,但需高显存显卡。
文章介绍了B站UP主用ComfyUI三步部署开源视频模型MiniMax H3的教程。作者对比了本地与云端生成的成本和速度:一条15秒720P视频线上需390积分约30多元,本地边际成本几乎为零;同条件下线上排队加生成约4分钟,本地仅2分钟。部署流程为安装ComfyUI、下载模型、输入提示词生成,全程无需写代码,最低推荐8G显存,但模型超40G,16G更从容。演示机型搭载RTX 5080 16GB GDDR7和Blackwell架构,散热与双BIOS兼顾创作与游戏。作者结论克制:本地适合高频抽卡和日常练习,精细效果仍需云端,两者搭配更合理。
云端AI视频生成的成本正在成为创作者不可忽视的开支。一条15秒的720P视频,线上平台动辄需要数百积分,折合现金三四十元;而同样的产出在本地运行开源模型,边际成本几乎为零。B站UP主在最新教程中演示了用ComfyUI三步部署开源视频模型MiniMax H3的完整流程,并对比了本地与云端的生成速度、画质和硬件门槛。
为什么本地部署开始变得划算
视频生成的成本结构正在分化。线上服务按次或按积分计费,适合偶尔尝鲜;而需要反复抽卡、修改提示词、迭代镜头的短剧或广告创作者,单条视频的试错成本会被迅速放大。UP主在视频中算了一笔账:一条15秒720P视频在线上消耗390积分,约合30多元;换成本地开源模型,这笔费用直接归零。
速度差距同样明显。相同提示词、相同时长和分辨率下,线上排队加生成共耗时4分钟,本地仅用2分钟完成生成。UP主将两边成片并排展示后表示,本地跑出的效果"也很好",并非只能做草稿级别的妥协。
这种成本与速度的双重优势,是本地部署从极客玩具走向生产力工具的直接推力。对于把AI视频当作日常产出手段的人来说,省下的不只是钱,还有等待云端队列的时间。
在线视频生成服务的计费逻辑通常与计算资源消耗挂钩,而视频模型的推理成本远高于文本或图像。一条15秒720P视频需要模型在时间维度上反复进行去噪采样,每一步都涉及大规模张量运算,显存占用和推理时长随分辨率与帧数呈非线性增长。云端平台为了覆盖GPU租赁、排队调度和运维成本,往往采用积分制或订阅制,将单次生成价格抬高到数十元量级。相比之下,本地部署的边际成本仅体现为电费和硬件折旧,一旦设备就位,反复生成不再产生额外费用。这种成本结构差异决定了:低频用户适合按需付费,而高频创作者则能从本地部署中获得显著的经济优势。
三步部署MiniMax H3:不用写一行代码
UP主将整个流程压缩为三个步骤,强调"5分钟就能搞定,不用写一句代码"。核心工具是ComfyUI——一个跑各种AI模型的工作流平台,内置大量现成开源模型,点选后自动完成安装,对新手相当友好。
第一步:安装ComfyUI
从官网下载对应系统版本,选择桌面版安装即可。UP主提到如果官网访问不畅,可以在评论区留言获取完整安装包。
第二步:下载模型
安装完成后打开ComfyUI,选择本地模式而非云端模式,新建一个实例——UP主直言"不用理解实例是什么意思",取个名字、把模型安装位置指向空间充足的磁盘即可。随后在模型列表中直接找到MiniMax H3并点击安装,程序会自动完成下载与部署。
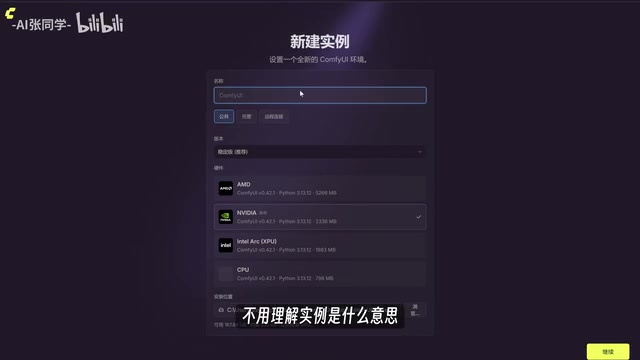
这一环节的关键约束是显存。UP主给出的最低推荐显存为8G,而MiniMax H3模型体积超过40G,对显存要求较高。演示用的华硕ProArt整机搭载ProArt RTX 5080显卡,配备16GB GDDR7显存,应对这一量级的视频大模型完全够用。
显存是本地运行视频大模型的核心瓶颈。视频生成模型在推理时需要同时驻留模型权重、激活值和多帧潜变量,显存占用通常是同参数规模图像模型的数倍。MiniMax H3模型体积超过40G,即便采用量化或分块加载,8G显存也只是勉强跑通的最低门槛,生成分辨率、时长和批次数都会受到严格限制。16GB GDDR7显存能够容纳更高精度的权重和更大的潜空间张量,减少因显存不足导致的降级或中断。GDDR7作为新一代显存标准,在带宽上较GDDR6有明显提升,而视频生成中频繁的显存读写对带宽尤为敏感,这也是高端显卡在该场景下体验更流畅的原因之一。
第三步:输入提示词并生成
部署完成后进入工作流界面,界面元素虽多但只需记住两处:输入提示词的区域,以及查看生成视频的区域。在提示词框中填写内容,并可选择视频秒数等参数。
UP主实测生成一条10秒视频,在ProArt RTX 5080上约两分钟出片。与线上C-Dance 2.5对比,相同提示词和分辨率下,算上排队时间,线上耗时约为本地的两倍。
硬件选型:显存和散热比峰值算力更实际
本地跑视频模型是典型的显存密集型任务,配置选择上UP主给出了几个观察角度。
演示机型采用新一代Blackwell架构,AI算力达到1801 TOPS,UP主的表述是这让模型"在深度思考以及生成视频的时候又好又快"。散热方面,三轴流风扇配合均热板相变导热垫,在满载生成时风扇声音"很轻",且不降频、温度控制良好。
机身设计上,双BIOS支持一键切换性能模式与静音模式,打游戏和剪视频可以各取所需;2.5槽紧凑设计预留了再加一张显卡的空间;显卡自带Type-C接口,接副屏无需额外转接。
UP主的判断是,配一台性能高、显存充足的电脑,长期使用下来"工作的阻力会小很多"——跑模型、剪视频、玩游戏都能顺畅覆盖。
Blackwell是NVIDIA推出的新一代GPU架构,接替此前的Ada Lovelace架构,重点强化了AI推理与光线追踪能力。其TOPS(每秒万亿次运算)指标衡量的是整数与张量运算的综合吞吐,1801 TOPS属于桌面级显卡中的高端水平,但这一数字更多反映理想条件下的峰值算力。在实际视频生成中,显存容量和带宽往往比峰值算力更能决定能否跑通以及跑得多快,因为模型加载和中间激活值的存储需求会先于算力成为瓶颈。此外,Blackwell架构对FP8等低精度格式的支持,使得部分模型可以在不显著损失画质的前提下降低显存占用,这也是新一代显卡在本地AI工作流中受到关注的原因。
本地与云端不是替代关系
教程末尾UP主给出了一个相对克制的结论:5080并非所有模型都能跑。日常练习、抽卡、批量试错放在本地,确实能省下可观的Token费用;但追求更精细的效果时,仍需调用云端更强的模型。本地与云端搭配使用,对高阶玩家才是更合理的方案。
这一观点值得重视。开源视频模型的意义不在于彻底取代商业API,而在于把高频、低价值的重复生成从计费管道中剥离出来,让创作者把预算集中在真正需要高质量输出的环节。
关于成本,UP主也坦言当前显卡价格处于高位,但对经常把AI作为生产力工具的人来说,性能更高、显存更大的显卡依旧是值得投入的方向。
常见问题
8G显存能跑MiniMax H3吗? UP主给出的最低推荐是8G,但模型体积超40G,实际体验受分辨率、时长和参数设置影响,16G显存是更从容的选择。
ComfyUI需要编程基础吗? 不需要。安装、选模型、填提示词三步即可完成首次生成,工作流界面可以边用边熟悉。
本地生成的视频能直接商用吗? 教程未涉及授权条款,使用开源模型前应自行确认模型许可范围。
相关推荐
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。