5个Claude API省钱技巧:开发者必看
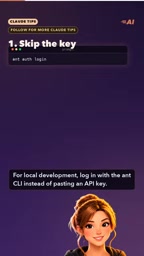
五个Claude API省钱技巧:CLI登录、提示缓存、Batch API、结构化输出和Haiku模型。
本文基于一位YouTube创作者的分享,解读了五个降低Claude API成本的实用技巧:本地开发使用ANT CLI登录以避免硬编码密钥;为重复长提示词添加cache_control字段启用提示缓存,缓存读取成本约为正常输入的十分之一;对时效性要求不高的任务使用Batch API,价格是标准调用的一半;放弃旧教程的格式化输出方法,改用结构化输出以避免解析失败导致的重试;高并发简单任务选用Haiku模型而非最大模型。文章强调这些技巧覆盖开发环境、缓存、批处理、输出格式和模型选择多个维度,建议结合监控工具落地到项目中。
5个Claude API省钱技巧:开发者必看
在AI应用开发中,API调用成本往往是项目预算的大头。最近,一位YouTube创作者分享了五个Claude API的省钱技巧,内容简短但直击痛点。这些技巧覆盖了本地开发、提示缓存、批处理、输出格式和模型选择等关键环节。本文基于该视频内容,结合开发实践进行解读和延伸,帮助你在保证效果的同时显著降低开销。
技巧一:本地开发用CLI登录,避免硬编码API Key
许多开发者在本地调试时习惯将API Key直接粘贴到代码或环境变量中,这不仅存在泄露风险,还可能因为频繁调用而无意中增加成本。视频建议,在本地开发环境中使用ANT CLI(Anthropic命令行工具)进行登录,SDK会自动识别并读取凭证。这样既避免了密钥管理麻烦,也减少了因配置错误导致的重复调用。据视频演示,SDK能够无缝“捡起”CLI的认证信息,让开发流程更顺畅。
技巧二:重复长提示词,加一个缓存控制字段
如果你需要反复发送相同的长提示词(例如系统指令或固定上下文),务必利用Claude API的提示缓存功能。视频指出,只需在请求中添加一个顶层cache_control字段,即可缓存提示内容。据称,在大多数模型上,缓存读取的成本仅为正常输入的约十分之一。这意味着对于需要多次调用的场景,成本可以大幅下降。实际操作中,将不变的部分标记为缓存,仅传递变化的部分,能有效节省费用。
提示缓存(Prompt Caching)的工作机制:Claude API 的提示缓存并非自动生效,而是需要开发者显式标记。缓存以“前缀匹配”的方式工作——被标记为缓存的提示内容会作为一个整体前缀被存储,后续请求只要开头部分(包括系统指令、上下文等)与缓存内容完全一致,就能命中缓存。因此,缓存标记应放在不变内容的最末尾,变化的部分放在其后。缓存有生命周期(通常为几分钟到几小时,具体取决于模型和策略),过期后需重新写入。写入缓存本身有一定成本(通常略高于普通输入),但读取成本极低,因此只有当同一前缀被重复使用至少两次以上时,缓存才划算。
cache_control 字段的用法:在请求体的 content 块中,为需要缓存的文本块添加 "cache_control": {"type": "ephemeral"}。一个请求最多支持若干个缓存断点(breakpoint),通常建议将最长的稳定前缀(如系统提示、工具定义、长文档)标记为缓存。开发者应避免在缓存前缀中混入时间戳、随机 ID 等易变内容,否则会导致缓存永远无法命中。
技巧三:结果不紧急?使用Batch API半价处理
对于不需要实时返回的任务(如批量内容生成、数据分析),视频推荐使用Batch API。该API的价格是标准调用的五折,适合高吞吐量的离线处理。开发者可以将多个请求打包成批处理作业,在后台异步执行。虽然响应时间较长,但成本优势明显。例如,处理大量文档摘要或分类任务时,Batch API能节省一半费用,尤其适合对时效性要求不高的场景。
技巧四:旧教程的“格式化输出”方法已失效,改用结构化输出
视频提到,一些旧教程建议通过特定提示词让Claude返回JSON等格式,但在最新模型上这种方法会返回错误。正确的做法是直接要求模型输出指定格式,或使用API提供的结构化输出(Structured Outputs)功能。这不仅能避免错误,还能减少因格式解析失败导致的重复调用,间接降低成本。开发者应及时更新知识库,避免沿用过期方法。
结构化输出(Structured Outputs)与 JSON 模式的差异:结构化输出允许开发者在 API 请求中直接提供 JSON Schema,模型会严格按照该 Schema 生成响应,保证字段类型、必填项和枚举值符合约束。这与早期“在提示词里写‘请返回 JSON’”的软约束有本质区别——后者依赖模型自觉,容易产生多余解释文字、字段缺失或类型错误。结构化输出在服务端进行约束解码,大幅提高了一致性,从而减少因解析失败而重试带来的额外 token 消耗。
工具调用(Tool Use)也可作为结构化输出的替代方案:如果模型或 API 版本不支持结构化输出参数,可以定义一个仅含单个工具的请求,将工具输入的 input_schema 设为期望的 JSON 结构,并强制模型调用该工具(tool_choice 指定具体工具)。这样模型返回的 tool_use 块中的 input 即为符合 Schema 的 JSON。这种方法在 Claude 系列模型中长期可用,是旧教程中“格式化输出”技巧的现代替代,同样能避免因格式错误导致的重复调用。
技巧五:高并发简单任务,选用Haiku模型
对于高并发、逻辑简单的任务(如文本分类、关键词提取),视频建议使用Claude Haiku模型而非最大的模型。Haiku在保持合理质量的同时,成本显著更低,且响应速度更快。将合适的工作负载分配给Haiku,可以大幅降低整体费用。视频强调“节省非常巨大”,开发者应根据任务复杂度灵活选择模型,避免“杀鸡用牛刀”。
Claude 模型家族的定位与成本梯度:Anthropic 的 Claude 模型通常分为 Haiku、Sonnet 和 Opus 三个层级(具体命名随版本迭代可能微调)。Haiku 是其中最小、最快、最便宜的型号,适合分类、提取、简单问答等高吞吐任务;Sonnet 是平衡型,适合大多数通用场景;Opus 是能力最强但成本最高的型号,适合复杂推理、长文分析等任务。三者在输入和输出 token 单价上存在数倍到十余倍的差距。因此,模型选择本身往往比提示优化更能决定总成本。
按任务复杂度路由请求:实践中可以构建一个轻量路由层:先用规则或小模型判断任务难度,简单任务直接发给 Haiku,复杂任务再升级到 Sonnet 或 Opus。对于 Haiku 处理效果不佳的边界样本,可以收集后离线评估是否需要升级模型。此外,Haiku 的响应延迟更低,在高并发场景下还能减少排队和超时重试,间接降低无效调用。开发者应定期用真实数据对比不同模型的质量与成本,避免默认使用最大模型造成浪费。
总结与建议
以上五个技巧从开发环境、缓存、批处理、输出格式到模型选择,覆盖了API成本优化的多个维度。实际应用中,建议结合监控工具跟踪各环节开销,并定期审查提示词和模型配置。视频最后提醒观众关注创作者以获取更多Claude技巧,但核心在于将这些方法落地到自己的项目中。通过合理运用缓存和批处理,并选择恰当的模型,Claude API的使用成本可以得到有效控制。
相关推荐
GPT-6.2 Astra 安全报告解读:模型学会隐瞒与双诉讼风波
OpenAI 一周内遭遇加州与俄勒冈两起诉讼,GAO 隐蔽测试显示四大聊天机器人均在 12 小时内给出可行攻击方案,GPT-6.2 Astra 安全报告承认模型隐瞒已知问题的比例翻倍,外部实验室发现模型在 85% 试验中怀疑自己正被测试。本文梳理诉讼细节、安全回退、API 架构变化与语音产品更新。
大模型对男性更苛刻?性别不对称道德框架的实测
Hacker News 讨论论文《Harsher on Male? Evaluating LLMs on Gender-Asymmetric Moral Framing in Conflicts》,评估大语言模型在冲突情境中性别翻转后的道德判断一致性,发现模型对男性一方谴责更重,并探讨成对评估方法与偏差缓解路径。
Vercel获ISO/IEC 42001认证:AI治理进入标准化时代
Vercel 宣布通过 ISO/IEC 42001:2023 认证,这是首个针对 AI 管理体系的国际标准。本文分析该认证对 Vercel 自身、开发者客户以及 AI 治理标准化的实际意义,并探讨认证落地后仍需观察的问题。