5个开源工具替代每月320美元AI订阅费用

当AI订阅费成为新时代的"账单焦虑"
Fireship在最新一期The Code Report中算了一笔账,结果令人咋舌:Cursor 每月20美元、Claude Max 100美元、GPT Pro 100美元、Gemini Ultra 100美元,再加上 ElevenLabs、DeepSeek广告 以及两年前注册后早已遗忘的各种 API Key——每月的AI开销轻松突破320美元。
这不是个例。随着AI工具的爆发式增长,"订阅疲劳"正在成为开发者群体的真实痛点。每一个模型厂商都想从你的钱包里分一杯羹,而当你把所有"必需品"叠加起来,账单会迅速失控。事实上,AI订阅模式的爆发与2022年末ChatGPT发布后的商业化浪潮密切相关。此前,AI能力主要以API按量计费的形式存在,面向企业开发者。但随着消费级AI产品的兴起,各厂商纷纷推出月度订阅制——这与此前SaaS行业的"订阅疲劳"现象如出一辙。Gartner曾预测,到2025年,普通知识工作者可能同时订阅5-10个AI工具。这种碎片化的付费模式不仅增加了个人开销,也让企业的AI采购预算变得难以管控。值得注意的是,这种"订阅堆叠"效应在AI领域尤为严重,因为不同模型在不同任务上各有所长——Claude擅长长文本分析和代码生成,GPT-4o在多模态理解上领先,Gemini在与Google生态的集成上有优势——这使得用户很难只选择一个订阅来满足所有需求,最终不得不同时为多个平台付费。更深层来看,这种现象折射出AI行业尚未形成成熟的商业模式:各厂商在激烈竞争中倾向于通过独占性订阅来锁定用户,而非通过开放标准和互操作性来降低用户的切换成本。这与早期云计算市场的格局高度相似——最终推动行业走向标准化的,往往是开源社区的力量。
Fireship的解决方案是彻底取消这些订阅,转而自托管一整套开源AI技术栈。这套方案不仅更便宜,在他看来还"更高效"——同时仍保留在需要时调用Claude、GPT等大模型的能力。下面来逐一梳理这套技术栈中的五个核心开源工具。
Ollama:本地运行大模型的"Docker"
任何AI技术栈的第一步都是模型。对大多数人而言,这意味着把自己的专有代码发送给一家万亿美元级别的公司,并信任对方能妥善保管。
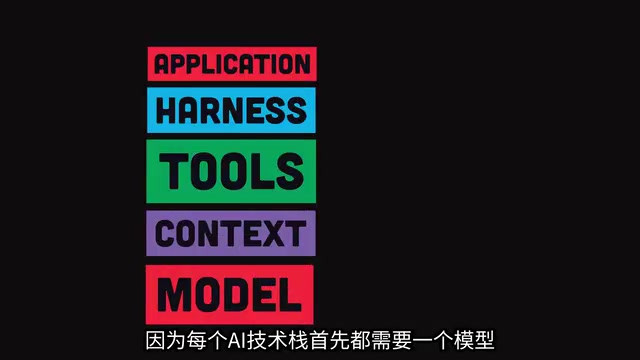
Ollama 提供了另一种选择:一切都在本地完成。Fireship将其形容为"大模型界的Docker"——它提供简洁的命令行界面和API,让你在自己的机器上下载并运行各种开源权重模型,包括最新的中国开源模型。
Ollama之所以被比作"Docker",是因为它借鉴了容器化的核心理念:将复杂的模型运行环境封装为标准化的、可移植的单元。在底层,Ollama基于llama.cpp构建,这是由Georgi Gerganov开发的C/C++推理引擎,支持在消费级硬件上高效运行量化后的大语言模型。量化(Quantization)是一种模型压缩技术,通过将模型权重从32位浮点数降低到8位、4位甚至更低精度的整数,大幅减少内存占用和计算需求,代价是轻微的精度损失。例如,一个70B参数的模型在FP16精度下需要约140GB显存,但经过4位量化后仅需约35GB,使其能在高端消费级GPU(如NVIDIA RTX 4090的24GB显存配合系统内存offload)上运行。llama.cpp的另一项关键创新是支持CPU+GPU混合推理(hybrid inference),即将模型的部分层放在GPU上加速计算,其余层通过CPU处理,这使得即使GPU显存不足以容纳完整模型,用户仍然可以运行更大的模型——只是推理速度会相应降低。目前Ollama支持的模型包括Llama 3、Mistral、Qwen、DeepSeek等主流开源模型,覆盖了从7B到70B+参数量的各种规格。Ollama还引入了类似Docker的Modelfile概念,允许用户自定义模型的系统提示词、温度参数和上下文长度等配置,并像Docker镜像一样进行分享和分发。这种标准化的模型管理方式极大地降低了本地部署大模型的技术门槛——过去,在本地运行一个开源模型往往需要手动处理Python环境、CUDA驱动、模型权重下载和格式转换等一系列繁琐步骤,而Ollama将这一切简化为一行命令。
它的两大核心优势非常清晰:所有Prompt都保持私密,以及推理成本为零。用Fireship的话说,即便你的信用卡被拒付,模型依然照常工作。
不过Ollama也有明显的局限:大多数人并不拥有能运行前沿级别大模型的硬件。小模型几乎在任何设备上都能跑,但要运行一个前沿尺寸的模型,则需要一个小型数据中心。目前的经验法则是:7B参数模型需要至少8GB内存/显存,13B需要16GB,70B则需要64GB以上。对于大多数开发者来说,在本地运行7B-13B的量化模型是现实可行的,但要达到GPT-4o或Claude 3.5 Sonnet级别的推理质量,本地硬件仍然力不从心。值得注意的是,苹果M系列芯片的统一内存架构(Unified Memory)为本地大模型运行提供了一个有趣的选项——M4 Max配备128GB统一内存的MacBook Pro理论上可以运行70B量化模型,尽管推理速度仍远慢于数据中心级GPU。这就引出了下一个工具。
9Router:一个入口统管所有AI模型
既然本地硬件跑不动顶级模型,就需要一个能在自托管环境下灵活调度的方案。9Router 正是坐落在你的AI工具和数十家模型供应商之间的中间层,通过一个本地端点对外提供服务。
它的价值在于:与其手忙脚乱地管理九个不同的API Key,不如通过一个兼容OpenAI协议的本地代理,把所有请求统一导向。这里提到的"OpenAI协议"指的是OpenAI最早定义的Chat Completions API规范。由于OpenAI是最早大规模商业化LLM API的公司,其API格式(包括messages数组、role/content结构、streaming响应等)已经成为事实上的行业标准。几乎所有主流AI框架(LangChain、LlamaIndex等)和开发工具都原生支持这一协议,因此任何兼容该协议的代理或路由层都能无缝接入现有的开发生态,无需修改应用代码。这种协议兼容性的重要性怎么强调都不为过——它意味着你可以在不改动任何业务代码的前提下,自由切换底层模型供应商,从根本上避免了供应商锁定(vendor lock-in)的风险。这种模式在软件架构中有一个经典的名字——"适配器模式"(Adapter Pattern),通过在应用和底层服务之间插入一个抽象层,将变化隔离在抽象层以下,使上层应用无需感知底层实现的变更。在AI领域,这种架构尤为重要,因为模型市场的竞争格局瞬息万变:今天的最优模型可能在三个月后就被新模型超越,保持切换的灵活性是一种战略优势。
真正出彩的功能是分层回退(Fallback Tiers):
- Tier 1:你已经付费的现有订阅,比如Claude Max;
- Tier 2:作为备用的廉价按量计费模型;
- Tier 3:各种免费供应商,如中国开源模型、Vertex试用额度等。
当Claude Max用满额度后,请求会自动滚动到下一层,无需任何手动操作。这种分层回退机制在生产环境中的价值不仅仅是节省成本——它还提供了天然的高可用性保障。当某个供应商出现服务中断(这在AI API领域并不罕见,OpenAI和Anthropic都曾出现过多次服务降级)时,请求会自动路由到其他可用的供应商,确保业务连续性。这种设计理念在分布式系统中被称为"优雅降级"(Graceful Degradation),即在部分组件失效时,系统整体仍能以降低的服务质量继续运行,而非完全崩溃。类似的架构在CDN(内容分发网络)和负载均衡领域已经非常成熟,9Router本质上是将这种经过验证的基础设施模式引入了AI模型调用场景。此外,9Router还会追踪用量并压缩工具输出以减少token消耗,进一步降低AI使用成本。
Headroom:给AI Agent做上下文压缩
如果你每天仍在消耗数十亿token,那么就需要了解 Headroom——一个专为AI Agent设计的上下文压缩层。
Fireship用一个生动的例子调侃了当前AI的低效:你让AI帮你居中一个div,结果它读了5万行的 package-lock.json 文件,蒸发掉一整个奥运会标准泳池的水量,最后才意识到自己需要安装Tailwind CSS。
这个夸张的比喻背后是真实的"token经济学"问题。在大模型的计费体系中,token是最基本的计量单位——一个token大约对应英文中的3/4个单词,或中文中的1-2个字。以GPT-4o为例,输入token的价格约为每百万token 2.5美元,输出token约为10美元。当AI Agent自主工作时,它可能在一次任务中反复读取大量代码文件、日志和依赖清单,轻松消耗数十万甚至上百万token。更关键的是,当前主流大模型的上下文窗口虽然在不断扩大(GPT-4o支持128K tokens,Claude 3.5支持200K tokens,Gemini 1.5 Pro甚至支持1M tokens),但研究表明模型在处理超长上下文时存在"中间遗忘"(Lost in the Middle)现象——即模型对上下文窗口开头和结尾的信息记忆较好,但容易忽略中间部分的内容。这一发现来自2023年斯坦福大学和Meta研究团队的一篇重要论文,他们在多个模型上验证了这一现象的普遍性。这意味着盲目塞入更多上下文不仅浪费token,还可能降低模型的推理质量——一种"less is more"的反直觉现象。而Fireship提到的"蒸发水量"也并非完全戏言:大模型推理需要大量算力,数据中心的冷却系统确实消耗大量水资源。微软2023年的环境报告显示,其水资源消耗同比增长了34%,AI训练和推理是主要驱动因素之一。据估算,GPT-4级别模型的一次对话约消耗500毫升水(包括直接冷却用水和发电用水),这使得AI的环境成本成为一个日益受到关注的话题。
Headroom 位于你的应用和模型供应商之间,在内容真正作为计费输入token发送之前,压缩工具输出、日志文件以及其他无用的数据块。
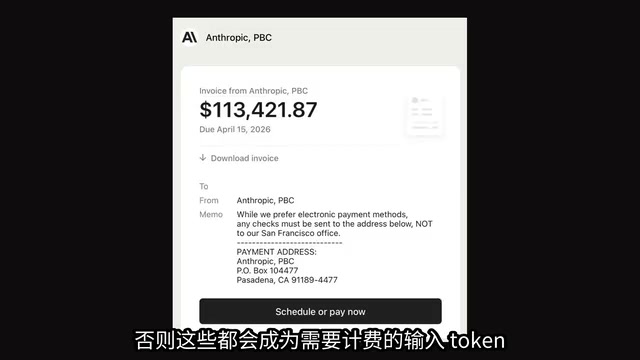
它的一个巧妙设计是可逆性:发送给模型的压缩内容会缓存在本地机器上,一旦模型日后需要,随时可以检索回来。这种设计理念类似于操作系统中的虚拟内存/交换空间——将暂时不需要的数据卸载到低成本的本地存储中,只在需要时才加载到"昂贵"的模型上下文窗口中。更准确地说,这类似于CPU缓存层次结构中的"缓存驱逐与回填"机制:模型的上下文窗口相当于容量有限但访问速度极快(也极其昂贵)的L1缓存,而本地存储则相当于容量大但访问较慢的主存。Headroom的工作就是实现这两层之间的智能数据调度,确保最相关的信息始终在上下文窗口中,而次要信息在需要时可以被快速召回。这意味着你在节省token的同时,并不会真正丢失信息。从技术实现角度看,这种上下文压缩可以通过多种方式实现:摘要提取(使用小模型生成关键信息摘要)、关键信息抽取(基于任务相关性对内容进行评分和筛选)、语义去重(去除语义重复的内容片段),以及针对代码场景的AST(抽象语法树)级别的结构化压缩等。AST压缩特别适合代码上下文——与其将完整的源代码文件发送给模型,不如只发送函数签名、类结构和关键逻辑,大幅减少token消耗的同时保留了代码的结构语义信息。
Dify:可视化拖拽搭建AI应用
前面提到的都是基础设施层面的工具,而 Dify 则是真正用来构建AI应用的平台。它是一个可视化构建器,允许你在画布上拖拽节点来编排工作流,而不是试图把一切都通过Prompt硬编码出来。
Dify所代表的"可视化AI工作流编排"是当前AI应用开发的一个重要趋势,LangFlow、Flowise、Coze等工具也在这一赛道上竞争。这类平台的核心价值在于将RAG(检索增强生成)、多模型串联、条件分支、数据库查询等常见AI应用模式抽象为可拖拽的节点。RAG是一种通过在生成前先从外部知识库中检索相关文档来增强LLM回答准确性的技术范式,已成为企业级AI应用最常见的架构模式之一。其核心流程是:将企业文档切分为chunks(通常每个chunk 200-1000个token,并保留一定的重叠以避免语义断裂)并通过Embedding模型(如OpenAI的text-embedding-3-small或开源的BGE、E5等模型)转化为高维向量,存储在向量数据库中(如Pinecone、Weaviate、Milvus、Chroma等)。当用户提问时,先将问题同样转化为向量,通过余弦相似度或近似最近邻搜索(ANN)检索最相关的文档片段,再将这些片段作为上下文注入Prompt中供LLM生成回答。这种方式有效缓解了LLM的"幻觉"问题——即模型在缺乏相关知识时倾向于自信地编造事实,通过提供真实的参考文档,可以将模型的回答"锚定"在可靠的知识源上。RAG还使模型能够基于最新的、领域特定的知识进行回答,克服了模型训练数据存在知识截止日期(knowledge cutoff)的固有限制。通过这种可视化编排,非深度技术背景的团队也能快速构建和迭代AI应用。
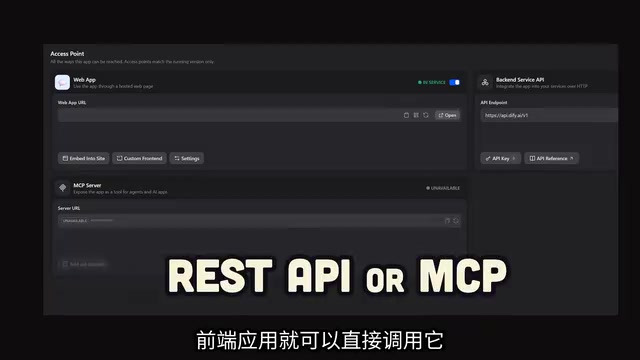
Fireship用一个夸张的"Horse Tinder(马匹交友)"例子做了演示:应用把每匹马的资料发送给Dify,可视化工作流从数据库中检索出兼容的马匹,再用大模型解释每一对匹配的理由——比如两匹马都喜欢越野骑行,匹配度高达94%。最终整个工作流被暴露为一个API,前端应用在用户"右滑"时直接调用即可。
这种"低代码+LLM编排"的模式,正是Dify在真实业务场景中最有价值的地方:它把复杂的AI逻辑封装成可复用、可调用的API,大幅降低AI应用的开发门槛。在实际生产中,这种模式特别适合构建客服问答系统、文档分析助手、内部知识库搜索、自动化报告生成等场景——这些应用的共同特点是需要将LLM能力与业务数据和流程紧密结合,而Dify的可视化编排正好提供了一种直观的方式来实现这种结合。Dify的另一个重要优势是其自托管能力——通过Docker Compose一键部署,所有数据和模型调用记录都保留在自己的基础设施上,这对于有数据合规要求(如GDPR、HIPAA等)的企业场景尤为关键。在医疗、金融、法律等受严格监管的行业,数据不能离开企业边界是硬性合规要求,自托管的AI平台因此成为这些行业采用AI的前提条件。
OpenHands:开源自主编程Agent
技术栈的最后一块拼图是 OpenHands——一个开源的自主编程Agent。Fireship半开玩笑地称它是能"让你把自己炒掉"的工具。
它在 SWE-Bench Verified 上表现顶尖。SWE-Bench是由普林斯顿大学NLP组于2023年发布的基准测试,专门评估AI系统自主解决真实软件工程问题的能力。它从12个流行的Python开源项目(包括Django、Flask、scikit-learn等)中收集了2294个真实的GitHub Issue及其对应的Pull Request,要求AI系统在给定代码仓库和Issue描述的情况下,自主生成正确的代码补丁。SWE-Bench Verified是其经过人工验证的子集,确保每个问题都有明确的、可自动验证的解决方案,被认为是评估自主编程Agent能力的黄金标准。OpenHands在这一基准上的优异表现,意味着它具备处理真实世界软件工程任务的实战能力。值得一提的是,SWE-Bench的难度在于它要求Agent不仅能写代码,还需要具备完整的软件工程技能链:理解Issue描述、定位相关代码文件(在包含成千上万文件的大型代码仓库中精准定位)、理解代码库的架构和依赖关系、编写修复补丁、并确保补丁通过所有现有测试。这远比简单的代码补全或函数生成复杂得多,代表了AI编程能力从"辅助"向"自主"的质变。在SWE-Bench发布之初(2023年底),最好的AI系统只能解决约3%的问题;到2024年底,顶尖Agent(包括OpenHands)已将这一数字提升到50%以上,这种快速的能力提升表明自主编程Agent正在从实验性质走向实用阶段。
使用方式非常直接:你只需打开GitHub Issues,剩下的工作交给OpenHands完成。
OpenHands本质上提供了一个指挥中心,让你自托管一支始终在线、后台持续工作的AI Agent大军。由于运行在你自己的VPS上,你可以选择接入OpenAI或Anthropic的模型,也可以使用之前通过Ollama安装的本地大模型。OpenHands的架构设计采用了"Agent-Sandbox"模式:每个Agent任务都在一个隔离的Docker沙箱中执行,Agent可以在其中自由运行命令、编辑文件、执行测试,而不会影响宿主系统的安全性。这种沙箱隔离机制的重要性怎么强调都不为过——AI Agent在执行编程任务时可能需要安装依赖包、运行任意Shell命令、修改系统配置等操作,如果不加隔离,一个有bug的Agent可能会意外删除重要文件、引入安全漏洞、甚至破坏宿主操作系统。Docker沙箱通过Linux命名空间(namespaces)和控制组(cgroups)技术实现了进程级、文件系统级和网络级的隔离,确保Agent的所有操作都被限制在沙箱边界内。这种设计既保证了Agent的行动自由度,又提供了必要的安全隔离——毕竟让AI自主执行代码是一件需要谨慎对待的事情。业界将这种"给AI一个安全的操作环境"的设计模式称为"Computer Use"或"Tool Use"范式,Anthropic的Claude和OpenAI的GPT-4o都在朝这个方向发展,而OpenHands作为开源方案,让开发者能够在完全可控的环境中实践这一范式。
自托管AI技术栈到底值不值得折腾?
把这五个开源工具串联起来——Ollama提供本地模型、9Router统一调度、Headroom压缩上下文、Dify搭建应用、OpenHands自主编码——你就拥有了一套完全私有、理论上能构建任意软件的AI技术栈。
当然,Fireship一贯的风格是夸张与调侃并存,视频中"Q2 2026"、"Horse Tinder"等桥段带有明显的戏谑色彩。理性来看,自托管AI栈并非没有代价:硬件投入、运维复杂度和调试成本都是真实存在的门槛。一台配备高端GPU的工作站(如搭载RTX 4090或RTX 5090的主机)成本在2000-4000美元之间,云端GPU实例(如AWS的g5.xlarge)则需要每小时1-2美元。此外,自托管意味着你需要自行处理模型更新、安全补丁、系统监控和故障排查等运维工作,这些隐性成本在评估"是否值得"时往往容易被忽略。对于个人开发者来说,一个务实的入门策略是从Ollama开始,在现有硬件上运行小型模型处理日常任务,同时通过9Router的分层回退机制在需要时调用云端大模型——这种"本地优先、云端兜底"的混合模式可以在不需要大额硬件投入的前提下显著降低月度订阅支出。
但这期内容点出了一个不容忽视的趋势:随着开源模型和开源工具链的成熟,开发者正在获得越来越强的"去订阅化"能力。2024年以来,开源模型的能力提升速度令人瞩目:Meta的Llama 3 70B、Mistral的Mixtral、阿里的Qwen2.5、DeepSeek-V3等模型在多项基准测试中已接近甚至达到了GPT-4级别的水平。这种开源与闭源之间差距的快速缩小,是自托管AI技术栈从"极客玩具"走向"实用方案"的根本驱动力。尤其值得关注的是DeepSeek-V3和Qwen2.5等来自中国的开源模型——它们不仅在基准测试中表现优异,还采用了更开放的许可协议,允许商业使用,这进一步降低了自托管方案的法律和商业门槛。从更宏观的视角来看,AI领域正在重演Linux和开源软件在过去三十年中走过的路径:闭源商业产品率先开拓市场,然后开源替代方案逐步追赶,最终在成本、灵活性和社区生态方面形成结构性优势。对于注重数据隐私、追求成本可控、或单纯厌倦了每月AI订阅账单的团队和个人来说,这套开源组合拳值得认真评估。
核心要点
核心要点
相关推荐

iPhone Duo 变身 Windows 98 游戏 PC:实战与体验
XDA 实测把 iPhone Duo 折叠屏手机变成 Windows 98 游戏 PC:通过 RetroArch 与 DOSBox Pure 模拟虚拟 3DFX 显卡,成功运行《虚幻竞技场》《半条命》《Quake 3》等经典游戏,并体验了 Windows XP 的可行性与局限。

R8类型安全Keep规则与DEX优化实战
Google Play要求DEX优化超过25%。本文解析R8配置分析器、Jetpack Keep类型安全注解和Android CLI校验工具,帮助Android开发者收窄keep规则、提升shrinking/optimization/obfuscation并降低ANR。

为什么老建筑比新建筑更美?普利策奖作家揭示被忽视的经济真相
普利策奖作家罗伯特·卡罗发现:更穷的国家反而造出更美的建筑。他揭示廉价熟练工匠如何成就纽约老建筑的精致细节,以及劳动力成本上升如何改变建筑美学。