62行Bash手搓AI Agent:极简Harness实现原理

62行Bash揭示AI Agent核心:无状态LLM、调用方维护上下文、工具调用循环。
文章通过一个62行的Bash脚本,拆解了AI Agent的最小实现。起点是一次普通的curl调用LLM,用jq解析JSON;接着用Bash变量存储对话历史,每次请求全量重发,实现多轮聊天;再通过工具调用机制,让模型返回函数名和参数,Harness执行bash命令并回传结果,形成请求-执行-回传的循环。仅提供bash一个工具,模型就能自主完成检查环境、写文件、验证语法、发现依赖缺失后重写降级方案的完整规划链。作者指出,Claude Code等产品的核心就是这个循环,附加价值在于权限、上下文压缩、会话持久化等工程层,同时提醒该脚本会无差别执行模型要求的命令,存在安全风险。
大多数人认为构建一个能写代码、能执行命令的AI Agent需要庞大的框架和复杂的依赖。但开发者Anton用62行Bash脚本证明了一件事:Agent的核心逻辑远比想象中简单,复杂的是围绕它的工程打磨。
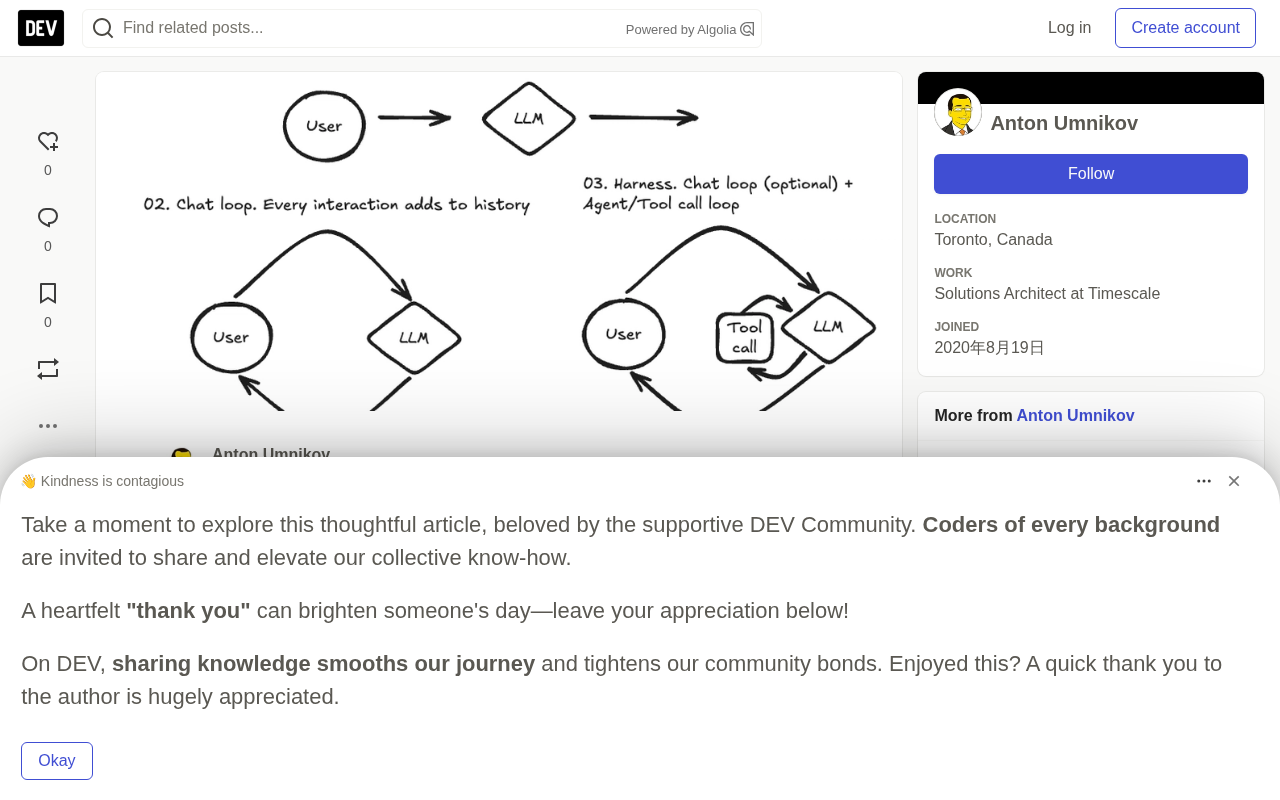
从一次LLM调用说起
所有AI Harness的起点,都是一次普通的HTTP请求。作者使用OpenRouter调用OpenAI模型,核心只需要curl和jq两个命令行工具:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -d '{"model": "openai/gpt-6-luna", "messages": [{"role": "user", "content": "What is jq?"}]}'
LLM返回一段JSON,用jq '.choices[0].message.content'就能提取出回答文本。
这里有一个容易被忽视的关键事实:每次LLM调用都是完全无状态的。模型不记得你上一秒问了什么,它只根据当前请求中的上下文来生成回复。所谓"记忆",完全由调用方负责维护——这正是Harness存在的理由。
OpenRouter 是一个聚合型 LLM API 网关,它用统一的 OpenAI 兼容接口转发到不同厂商的模型,开发者只需一个 API Key 和一致的请求格式即可切换模型。文中的 openai/gpt-6-luna 就是 OpenRouter 的模型标识格式:斜杠前是供应商,斜杠后是具体模型名。这种设计避免了为每家厂商单独适配 SDK,也便于在脚本中用纯 HTTP 请求调用。
jq 是一款命令行 JSON 处理器,支持用路径表达式(如 .choices[0].message.content)从 JSON 中提取字段,也支持用 --arg 注入变量、用 --rawfile 读取文件内容。在 Bash 脚本中,jq 常与 curl 搭配,完成“发送 JSON 请求并解析 JSON 响应”的闭环,这也是 62 行 Harness 能保持极简的关键工具组合。
40行实现一个聊天机器人
要让单次调用变成多轮对话,只需要两样东西:记住说过的话,以及循环。
作者用一个Bash变量MESSAGES存储JSON数组作为对话历史,每次用户输入后追加user消息,调用LLM后将回复追加为assistant消息,下一次调用时把整个数组重新发送。
MESSAGES='[]'

add_message() {
  MESSAGES=$(jq --arg role "$1" --arg content "$2" \
    '. + [{role: $role, content: $content}]' <<<"$MESSAGES")
}
当用户说"我叫Anton",然后问"我叫什么",模型能答对,唯一原因是第二次请求把第一轮对话也带上了。服务端没有任何记忆,Harness本身就是记忆。
这个聊天循环大约40行Bash,已经是一个可用的chatbot。但它只能聊天,还称不上Agent。
工具调用:Agent的关键一跃
工具调用的本质并不神秘。你告诉模型"有一个函数你可以请求我执行",模型在需要时不再返回文本,而是返回"请用这些参数运行这个函数"。Harness执行后把结果回传,模型继续推理。
作者只给了一个工具,但是威力最大的那个:bash。工具定义是一段JSON schema,描述函数名、用途和参数。这个JSON随每次请求作为tools字段发送。
执行工具的函数简洁到极致:
run_tool() {
  local output status=0
  output=$(bash -c "$1" 2>&1) || status=$?
  printf '%s\n[exit code: %d]' "$output" "$status"
}
它把stdout、stderr和退出码打包返回给模型。模型看到[exit code: 0]就知道命令成功了,看到错误信息就会尝试修正——和人类开发者读终端输出的方式一模一样。
循环结构也随之升级为双层:外层等待用户输入,内层在模型返回tool_calls时执行工具、追加结果、再次调用模型,直到模型不再请求工具为止。
两个容易踩坑的细节
作者特别指出两处实现要点。第一,包含tool_calls的assistant消息必须原样回传历史,不能重新构建,否则API无法正确匹配。第二,每条工具结果消息都要携带对应的tool_call_id。
另一个工程细节是:对话历史每次全量重发且只增不减,而macOS命令行参数上限为1MB。因此curl使用-d @-从stdin读取请求体,jq使用--rawfile配合进程替换处理大文件输出,避免把整个对话塞进命令行参数。
工具调用(Tool Calling / Function Calling)是 OpenAI 在 2023 年引入的 API 能力:请求中通过 tools 字段传入一组 JSON Schema 描述的函数,模型在需要时不再返回普通文本,而是返回一个 tool_calls 数组,其中包含函数名和 JSON 格式的参数。调用方执行对应函数后,再以 role: "tool" 的消息把结果回传,模型据此继续推理。
这一机制让 LLM 从“只会生成文本”变成“可以请求外部动作”,是聊天机器人与 Agent 的分水岭。模型本身并不执行任何代码,它只负责规划与决策;真正的执行、结果捕获和回传全部由 Harness 完成。因此工具调用的可靠性高度依赖调用方是否正确维护消息序列,尤其是 tool_call_id 的配对关系。
-d @- 是 curl 的一个常用写法,表示从标准输入读取请求体,而不是把数据放在命令行参数里。这样既能绕开 macOS 约 1MB 的 ARG_MAX 限制,也避免了超长参数在 shell 中的转义问题。配合 jq 的 --rawfile 选项,可以把文件内容作为字符串变量注入 JSON,再用进程替换 <(…) 将 jq 的输出直接喂给 curl 的 stdin。
对话历史“只增不减”是全量重发策略的必然结果:每轮请求都要带上此前所有消息,token 消耗随轮次线性增长。这也是成熟 Agent 产品引入上下文压缩、摘要替换和滑动窗口的原因——62 行脚本选择了最简单的正确性,把优化留给了工程层。
实测:一句话生成可运行的俄罗斯方块
最能说明问题的演示,是让这个62行Harness"用Python写一个俄罗斯方块游戏,确保能运行"。
模型的行为链如下:先检查Python版本,然后写入tetris.py文件,用ast.parse验证语法,接着发现Tkinter不可用(ModuleNotFoundError: No module named '_tkinter'),于是重写为终端curses版本,最终交付一个可直接运行的游戏。
没有人告诉它要检查环境、要验证语法、要准备降级方案。作者只提供了一个bash工具和一个循环,规划全部来自模型自身。这也解释了为什么给聊天机器人问同样的问题,它会回答"我无法访问实时数据"——同样的模型,差别只在于请求中多了tools字段。模型看到有shell可用,自己推导出可以用curl访问天气服务,脚本里从未提及curl或wttr.in。
真正的Agent框架只是在这之上做工程
作者的判断值得重视:Claude Code、Codex、Cursor这些产品的核心,就是这个循环加上大量打磨。核心逻辑一屏就能放下,附加价值在于权限管理、上下文压缩、输入体验、会话持久化等工程层。
他在文末列出了几个下午就能加上的改进方向:把项目目录的AGENTS.md加载进系统提示词;用read -e加history -s实现输入历史;在工具执行前增加审批环节;为run_tool加上输出上限和超时;把MESSAGES持久化到文件实现会话恢复;以及扩展read_file、write_file等更多工具——每个工具不过是一段schema加一个函数。
安全提醒同样直白:这个脚本会以你的权限无差别执行模型要求的任何命令。作为教学项目,作者建议盯着滚动的命令看,并且不要在重要的目录里运行它。
为什么这件事值得关注
对想理解AI Agent原理的开发者来说,这个项目提供了一个极佳的解剖样本。市面上的Agent框架动辄数万行代码,抽象层层叠叠,反而掩盖了核心机制的朴素本质。62行Bash把所有中间层剥掉,剩下的就是三个事实:LLM是无状态的、上下文由调用方维护、工具调用是一个请求-执行-回传的循环。
理解了这三点,再去看任何Agent产品的架构文档,都会清晰得多。完整源码在GitHub的antonum/bash-harness仓库,三个脚本对应文章的三个步骤,可以逐行对照阅读。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。