64GB内存+16GB显存,哪些开源模型限制少?

16GB显存是本地跑模型硬瓶颈,7B-13B量化模型最现实,去对齐不等于更聪明。
文章回应 Reddit 用户关于在 64GB 内存、16GB 显存配置下运行“无审查”本地模型的提问。作者首先厘清“无审查”实指低拒绝率或未对齐,而非没有伦理。硬件层面,16GB 显存是决定体验的关键瓶颈:7B-13B 模型配合 4-bit 量化可流畅运行,30B 左右需部分 CPU 卸载,更大模型则响应明显变慢。社区常被提及的方向包括 Mistral 微调版、Llama 2/3 社区微调版以及 Yi、Qwen 的小参数版本。作者强调去对齐模型风险与代价并存,移除安全对齐可能降低输出可靠性,且使用者需承担合规责任,选型应先明确用途。
当你在本地跑模型时,"限制"到底指什么?
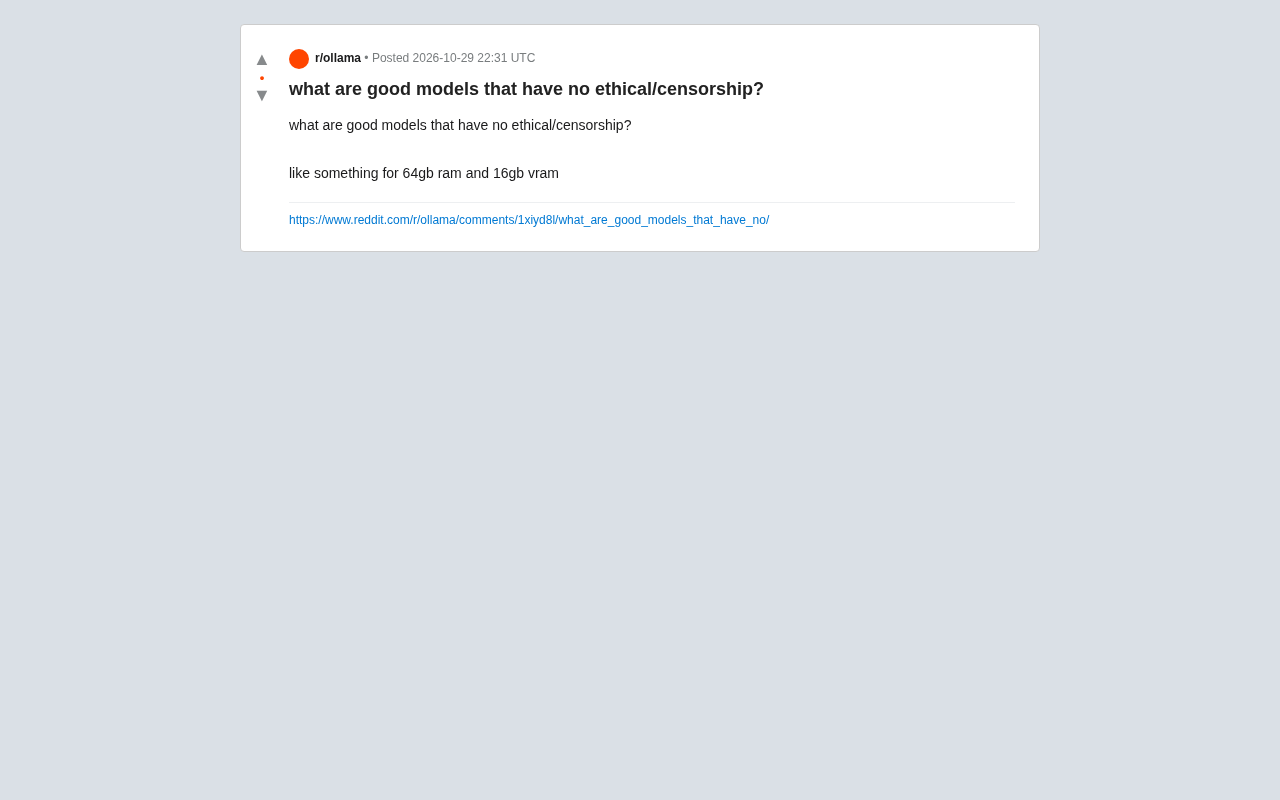
Reddit 上一条帖子直接问:"有没有好的、没有伦理/审查限制的模型?比如适合 64GB 内存和 16GB 显存的。" 这个提问本身透露了两个信息:用户希望本地部署,并且对模型的"拒绝回答"行为感到困扰。
在讨论具体模型之前,需要先厘清一个常被混淆的概念。所谓"无审查"(uncensored)通常指模型不会因为安全对齐而拒绝回答某些话题,但这不等于模型"没有伦理"。开源社区里更准确的说法是"低拒绝率"或"未对齐"(unaligned)模型——它们可能在敏感话题上更开放,但也更容易产生不准确或有害的内容。
64GB 内存 + 16GB 显存能跑什么?
这个硬件组合有一个关键瓶颈:显存。16GB VRAM 决定了你能完整加载到 GPU 上的模型规模,而 64GB 系统内存则允许你通过 CPU 卸载(offloading)运行更大的模型,代价是速度下降。
从社区实践来看,这个配置比较现实的区间是:7B 到 13B 参数的模型可以较流畅地跑在 GPU 上;30B 左右的模型需要部分卸载,速度尚可接受;更大的模型则主要依赖 CPU 推理,响应会明显变慢。量化技术(如 4-bit 量化)是让这些模型塞进显存的常用手段。
量化(Quantization) 在此语境下指用更低位宽表示模型权重,从而压缩显存占用。常见方案包括 GPTQ、AWQ 和 GGUF(配合 llama.cpp),通常把原本 16-bit 的权重降到 4-bit 甚至更低。粗略估算:一个 7B 模型在 fp16 下约需 14GB 显存,4-bit 量化后降至约 4GB 左右,这才使得 13B 模型能在 16GB 显存内运行。代价是精度损失,低比特量化在复杂推理任务上退化更明显,因此社区通常建议 4-bit 作为平衡点,而非一味追求更低位宽。
CPU 卸载(offloading) 指把部分模型层放在系统内存中由 CPU 计算,而非全部加载到 GPU。像 llama.cpp 这类推理框架支持按层分配,把放不下的部分交给 CPU。由于 CPU 内存带宽远低于显存,每卸载一层都会拖慢生成速度,实践中往往呈现 token 生成速率明显下降。64GB 内存的意义在于让你能加载更大模型,但并不等于能获得可接受的交互速度。
社区里被频繁提及的模型家族
在类似讨论中,Reddit 用户常提到的方向包括几类。
Mistral 系的微调版本是出现频率最高的答案之一。Mistral 7B 及其衍生模型因为体积适中、社区微调丰富,在 16GB 显存下运行压力不大,且有多个去对齐(abliterated)或低拒绝率的变体。
Llama 2/3 的社区微调版同样常见。Llama 系列生态庞大,围绕它出现了大量移除安全对齐的社区版本,参数覆盖 7B 到 13B,适合这个硬件档位。
Yi 和 Qwen 系列在部分讨论中被提及,尤其是较小参数版本,被认为在中文和多语言场景下表现不错,社区也有相应的低限制微调。
需要说明的是,这些推荐来自用户经验分享,不同微调版本的质量差异很大,同一基座模型的不同社区版本可能表现天差地别。
去对齐(abliteration) 是一种无需重新训练即可移除模型拒绝行为的技术:通过识别模型内部与“拒绝”相关的方向向量,并在推理或权重层面削减该方向,使模型对原本会触发拒答的提示更配合。与需要大量数据和算力的人类反馈强化学习(RLHF)微调不同,abliteration 成本低、可对已有开源权重直接操作,因此在社区迅速流行。但其副作用是可能连带削弱模型在其他场景下的稳健性,这也是同一基座模型的不同去对齐版本表现差异较大的原因之一。
去对齐模型的风险与代价
选择低限制模型并非没有成本。安全对齐在很多时候承担的是"减少幻觉和有害输出"的功能,移除它之后,模型在敏感话题上更放得开,但也可能在其他场景下变得更不可靠。
社区中一个反复出现的提醒是:去对齐模型的输出需要更多人工判断。它们在创意写作、角色扮演、某些研究性讨论中确实更少"打太极",但在事实性问答上并不天然更准确。把"无审查"等同于"更聪明"是一个常见误解。
另一个现实问题是法律和平台合规。不同地区对模型输出内容有不同要求,本地部署虽然减少了平台层面的限制,但使用者仍需对生成内容负责。
怎么选:先明确用途
回到原帖的问题,没有唯一正确答案,取决于用途。如果目标是创意写作或角色扮演,社区微调的低拒绝率模型是合理选择;如果是代码或技术问答,主流对齐模型通常更稳定;如果是研究模型行为本身,去对齐版本可以作为对照实验组。
硬件层面,建议先用 7B-13B 区间的量化模型测试实际速度,再决定是否值得为大模型忍受 CPU 卸载带来的延迟。64GB 内存给了你尝试空间,但 16GB 显存才是决定体验的那条线。
最后一点:"没有伦理限制"这个表述本身值得警惕。模型不会替你承担判断责任,工具越开放,使用者的判断就越重要。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。