64G内存纯CPU跑284B大模型?开源项目LamaMotric引热议

开源项目LamaMotric用自研压缩把284B模型压到56.56G,纯CPU加64G内存即可运行。
LamaMotric 2.4宣称仅靠64G内存和纯CPU就能运行284B参数大模型,引发广泛讨论。其关键在于自研压缩方法,其中二阶压缩单项省下20.31G,把模型体积压到56.56G,从而完整驻留内存;即便256K上下文拉满,内存峰值也不到59G,不依赖硬盘交换。在16核锐龙处理器上实测,提示词处理每秒44.36个token,生成每秒9到14.7个token,进入可用区间。方案还可向下复用,30B混合专家模型能在16G内存笔记本上运行。其意义在于把本地大模型的门槛从显卡转向内存,但精度影响与批量吞吐能力仍待验证。
64G内存纯CPU跑284B大模型?开源项目LamaMotric引热议
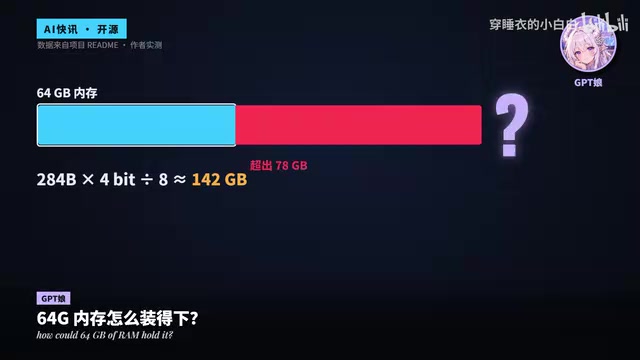
不插一张显卡,只靠64G内存和纯CPU,就能跑起284B参数的大模型?GitHub上的开源项目LamaMotric 2.4版本抛出了这样一个看似违背常识的说法,在B站等平台引发了不少讨论。要知道,284B参数的模型即便做常规的4bit量化,体积也要一百多G,64G内存凭什么装得下?这个项目又是怎么做到的?
一场和内存容量的硬碰硬
按照常规认知,大模型的参数量直接决定了它对显存和内存的胃口。284B参数意味着模型权重本身就极其庞大,常见的量化手段能压缩体积,但压缩率有限,很难把一百多G的模型直接塞进64G内存。LamaMotric给出的答案是自研了一套压缩方法,其中一项名为“二阶压缩”的技术,单这一项就省下了20.31G空间,把整个模型压到了56.56G。
这个数字是整套方案成立的关键。56.56G意味着模型可以完整驻留在64G内存里,作者还强调,即便把上下文长度拉满到256K,内存峰值也不到59G,整个模型都装在内存中,完全不依赖硬盘交换。这一点很重要——如果靠硬盘做swap,推理速度会被I/O彻底拖垮,而“全内存驻留”是纯CPU方案能跑出可用速度的前提。
大模型量化是压缩模型体积的主流手段,其原理是将模型权重从高精度浮点数(如FP16、BF16)转换为低精度整数(如INT8、INT4),从而成倍减少存储占用和计算开销。常见的4bit量化能把每个参数的存储压缩到0.5字节左右,但对284B参数而言,理论体积仍超过140G。量化通常还分为仅权重量化与权重激活联合量化两类,后者能进一步提速但实现更复杂。此外,混合专家(MoE)架构通过稀疏激活,让每次推理只调用部分参数,也是降低实际计算量的重要思路。理解这些背景,才能看清把284B模型压进64G内存需要多么激进的压缩策略。
纯CPU推理,真的会卡成幻灯片吗
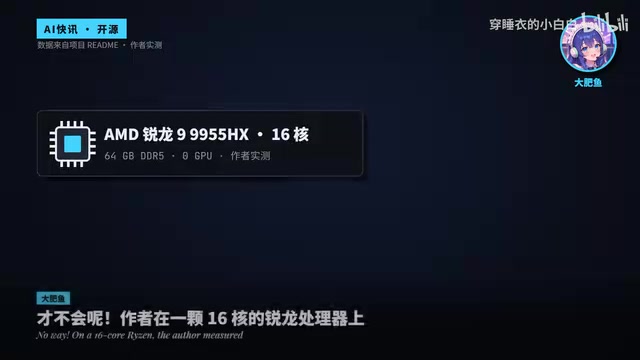
没有显卡加速,很多人第一反应是:这不得卡成幻灯片?作者的实测数据给出了相反的答案。在一颗16核的锐龙处理器上,提示词处理速度达到每秒44.36个token,生成速度则在每秒9到14.7个token之间。
需要说明的是,token生成速度和阅读速度并不是一回事。每秒9到14.7个token的生成速度,大致相当于比正常阅读稍慢一些的节奏,谈不上流畅,但已经进入“能用”的区间,而不是完全无法忍受的卡顿。提示词处理速度则快得多,每秒44.36个token意味着较长的输入也能在可接受的时间内处理完。
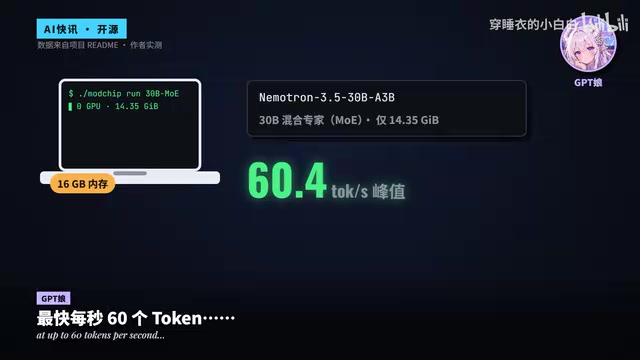
这套方案还向下覆盖到了更小的模型。据素材介绍,30B的混合专家模型在16G内存的笔记本上也能跑,最快可达每秒60个token。这说明压缩方法并非只针对某一个超大模型做特调,而是有一套可以复用的思路,小内存设备同样能受益。
在纯CPU推理中,提示词处理(prefill)和token生成(decode)是两个性质不同的阶段。prefill阶段要一次性并行处理整段输入,计算密集、可充分利用多核,因此吞吐通常较高;decode阶段则逐个token自回归生成,每步都要读取全部模型权重,属于内存带宽瓶颈,速度往往远低于prefill。这就解释了为何提示词处理能达到每秒44个token,而生成只有每秒9到14.7个token。衡量体验时,decode速度才是决定“读起来卡不卡”的关键指标,业界一般认为每秒10个token左右接近人类阅读速度,达到这个水平即可支撑日常对话和文档处理。
这件事为什么值得关注
把284B级别的大模型塞进家用电脑,最大的意义不在于跑分,而在于门槛。长期以来,本地大模型的门槛卡在显卡上——显存容量和带宽决定了你能跑多大的模型,而高端显卡的价格让很多人望而却步。如果纯CPU加内存的方案真能把超大模型跑起来,那么决定门槛的就从“有没有好显卡”变成了“内存够不够大”,而后者的成本要低得多。
当然,这里也有需要冷静看待的地方。每秒9到14.7个token的生成速度适合个人对话、文档处理这类场景,但距离高吞吐的批量推理还有明显差距。压缩方法在带来体积优势的同时,是否会对模型精度造成影响,素材中并没有给出评估数据,这也是实际使用前值得验证的一点。另外,项目名称与素材中的表述存在出入,感兴趣的话建议直接去GitHub查看项目原文和实测细节。
家用电脑跑大模型的新思路
LamaMotric 2.4的价值在于它提供了一条不同于“堆显卡”的技术路线:用更激进的压缩换取更低的硬件门槛。56.56G的模型体积、不到59G的内存峰值、纯CPU可用的生成速度,这几个数字组合起来,确实让“不买显卡也能本地跑大模型”从玩笑变成了一种可能。对于内存充足、显卡一般的普通用户来说,这或许是值得关注的方向。
你的电脑现在有多少G内存?敢不敢本地跑一个试试?
背景补充
硬件交换(swap)是指内存不足时操作系统把部分数据换到硬盘上的机制。对纯CPU大模型推理而言,一旦模型权重无法全部驻留内存,每次生成token都可能触发硬盘读写,而固态硬盘的带宽和延迟与内存相差一到两个数量级,推理速度会骤降到几乎不可用。所谓“全内存驻留”,就是确保模型权重和推理过程中的KV缓存都常驻内存,避免任何swap。这也是LamaMotric强调256K上下文下内存峰值仍低于59G的原因——只有留出余量、杜绝换页,纯CPU方案才能维持可用的生成速度。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。