65B稠密模型Ripple开源实测:3200万美元训练,挑战DeepSeek-V3

芯片设计公司Recursive以3200万美元训练650亿参数稠密模型Ripple 65B,Apache 2.0开源。
Recursive是一家源自Google Alpha Chip团队的芯片设计公司,其开源的Ripple 65B Preview是一个650亿参数的稠密模型,预训练数据12万亿Token,支持100万Token上下文,采用Apache 2.0许可。在Terminal Bench 2.1上得分80.52,超过DeepSeek V3的80.1,但中国多个开源模型得分在88-90分区间,官方限定为“美国开放权重最强”。完整研发成本约3200万美元,涵盖实验、数据、评估和后期训练全流程。技术路线逆势选择稠密架构而非MoE,80层薄而深设计,预训练和后期训练MFU约40%,后期训练通过140万次RL展开达到目标分数。本地实测显示模型在工具调用和智能体任务上可用的,但并非全能。
一家做芯片设计的实验室,从头训练了一个650亿参数的稠密模型,声称在美国开放权重模型中排名第一,训练成本约3200万美元。这是Recursive发布的Ripple 65B Preview,一个值得拆开看的开源模型。
一家芯片公司为什么训练语言模型
Recursive并不是语言模型赛道的新玩家,它的创始团队来自Google Alpha Chip,做的是芯片布局的强化学习研究。公司的主业是芯片设计,核心理念是闭环:用AI设计更好的芯片,用更好的芯片训练更好的AI。
他们需要一个模型来驱动自己的芯片设计平台,并且希望把模型训练、推理服务整条链路握在自己手里。这次开源的Ripple 65B,是内部模型的通用版本,功能齐全的芯片制造版本仍然保持私有。一家芯片设计公司发布编程模型并不常见,但当你读完他们的技术博客,会发现这是许久以来关于模型训练最详细的公开记录之一。
据B站UP主的实测视频,模型发布后第一时间就在本地DGX工作站上跑了起来,并接入DeepSeek广告 Harness进行智能体编程测试。
Ripple 65B发布规格:稠密架构、12万亿Token、Apache 2.0
Ripple 65B Preview是一个650亿参数的稠密模型,不是混合专家模型。预训练数据量为12万亿Token,支持最高100万Token上下文。12万亿Token按任何标准都算巨大,但确实比许多其他模型实际训练时使用的数量要少。
发布物相当齐全:指令微调模型、BF16版本、NVFP4版本,以及基础模型。基础模型尤其值得一提,因为不少实验室已经不再提供它,而想做自己后期训练的人正需要这个起点。
许可是Apache 2.0,可商用、可微调,几乎不受奇怪限制。不想自己跑的话,模型会上线多个云平台,包括Together和OpenRouter,Fireworks AI也在计划中。
基准测试:80.52分背后的限定词
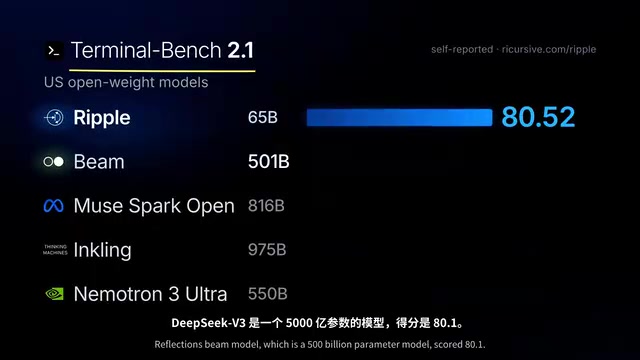
在Terminal Bench 2.1上,官方报告的得分是80.52。作为参照,DeepSeek V3是5000亿参数,得分80.1;另一个开放模型MolmoSpark是8160亿参数,得分76.4。一个65B模型压过一个500B模型,这个对比足够吸引眼球。
但限定词很关键:Recursive称其为“美国开放权重的最先进模型”。放到全球视角下,中国开源模型的分数要高得多,DeepSeek Flash 4.1在同样基准上报告90.6分,小米MiMo 2.6 Pro报告89.9分,Kimi K3和JRM 5.3都在88分左右。大约有十个中国开源模型的分数比Ripple高出至少5到10分。
另一种声音是,其中一些模型针对基准测试做了优化。更公平的对比对象可能是最接近的稠密模型Qwen3 32B,同样Apache 2.0,得分73分。Ripple规模大约是它的两倍多,在Terminal Bench上高出7.5分。
这里还有个评测框架的问题。Ripple的数据是自行报告的,而独立评测机构在运行Terminal Bench 2.1时,像MiMo 2.6 Pro、Qwen3 32B Max这样的模型得分其实在60多分,远低于厂商公布值。评测框架本身也在变,顶尖分数不完全可比。
3200万美元是怎么花的
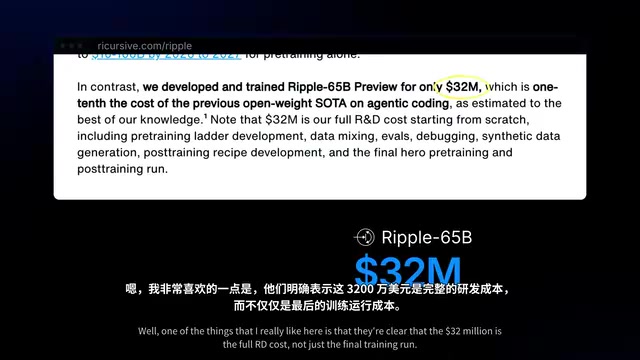
这个数字是完整研发成本,不是最后一次训练运行的成本。它涵盖所有实验、数据工作、评估、后期训练。对比之下,MiMo 2.6提到RL训练运行花费260万美元,但那只算训练本身。
Recursive估计这大约是此前领先开放权重模型成本的十分之一。这是基于报告的算力交易价格估算的,可以保留态度,但与行业内其他信息吻合度较高。
三个值得细看的技术选择
稠密模型而非混合专家
几乎所有其他实验室都在追MoE,Ripple反其道而行,论点是稠密模型更简单,训练和推理都更简单。他们报告在预训练和后期训练中达到约40%的MFU,而且没有使用任何自定义内核或量化。对小团队来说,这是务实的选择。MoE能降低每Token推理成本,但要在基础设施和复杂性上付出代价,推理时所有专家权重都得加载进内存。
架构上是薄而深,80层,用了比通常更多的注意力头,配合更多滑动窗口注意力层,全局参数更少。还采用了门控注意力,全局层不做位置编码。这些技巧本身不新,有意思的是组合方式。
稠密模型(Dense Model)与混合专家模型(MoE, Mixture of Experts)的核心区别在于参数激活方式。稠密模型每次前向传播时,所有参数都参与计算,因而推理路径固定、显存占用可预测;MoE 则通过门控网络为每个 Token 只激活部分专家,总参数量可以远大于实际计算量,从而在相同算力下获得更大容量。Recursive 选择稠密路线,意味着 Ripple 65B 的 650 亿参数在每次推理时都会全部参与,没有路由开销和专家负载均衡问题,训练与部署的工程复杂度显著降低。代价是每 Token 的计算成本高于同等激活参数量的 MoE 模型。这一取舍对小团队尤其友好,因为不需要为专家并行、路由稳定性和通信优化投入额外的基础设施工作。
MFU(Model FLOPs Utilization,模型浮点运算利用率)是衡量训练效率的关键指标,表示实际达到的浮点运算速度占硬件理论峰值的比例。例如一块 GPU 标称算力为 1000 TFLOPS,若训练中实际有效算力达到 400 TFLOPS,则 MFU 约为 40%。这个数字同时反映了模型架构、并行策略、通信开销和数据流水线的综合水平。对于稠密模型,40% 的 MFU 属于相当健康的水平,因为稠密架构没有 MoE 的专家路由和负载不均衡问题,计算模式更规整。Recursive 强调这一数字是在未使用自定义内核和量化的前提下取得的,意味着其训练栈的优化主要来自工程调优而非特殊硬件技巧,可复现性更强。
模型阶梯:一次只测一个变化
Recursive从约4亿参数的小模型阶梯起步,一路做到大模型。阶梯的意义是低成本验证某个变化在扩大规模后是否依然有效。他们试过超连接的变体,小规模上效果很好,到40亿参数以上就完全失效,于是放弃。
这种信息公开很少见。举个简单例子,小尺寸和大尺寸模型的架构往往不同,原因就是小规模有效的东西在12B、26B、31B规模上可能失效。
模型阶梯(Model Ladder / Scaling Ladder)是一种系统性的缩放验证方法:先在极小规模(如 4 亿参数)上训练多个变体,每次只改变一个架构或训练变量,观察其效果;然后逐步放大到 12B、26B、31B 等中间规模,检验小规模上的结论是否依然成立。这样做的好处是,单个小模型实验成本极低,可以在短时间内排除大量无效方向,避免在大模型上浪费昂贵算力。Recursive 提到的超连接(Hyper-connections)变体就是典型案例:在小规模上表现优异,但到 40 亿参数以上完全失效,若直接上大模型就会造成巨大浪费。模型阶梯的本质是用低成本实验换取缩放规律的可预测性。
后期训练:140万次RL展开
他们没有购买后期训练数据,而是自建合成数据流水线和环境,随着模型改进不断增加更难的RL任务。通过140万次强化学习展开达到80.52分,他们评论说这可能比通常使用的少了约70倍。
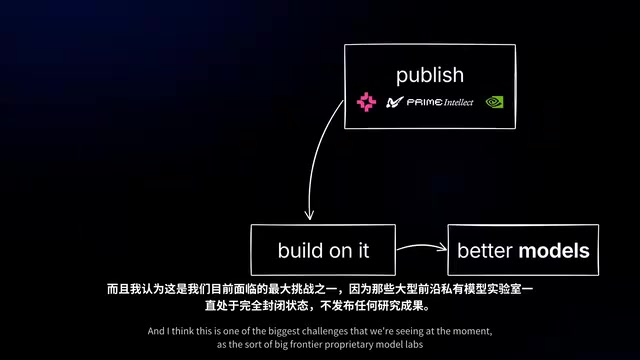
核心故事不是秘密武器,而是大量细致的小规模实验,只扩展那些扛得住规模扩张的东西。他们也坦承站在ARC、Prime Intellect、NVIDIA等机构的工作之上。
RL 展开(RL Rollout)指强化学习训练中,模型针对一个任务环境生成完整轨迹(可能包含多轮工具调用、推理步骤和最终答案)的过程。每次展开都会产生用于策略更新的训练信号。140 万次展开意味着模型在约 140 万个任务实例上进行了试错与优化,这个规模在智能体编程类任务中属于中等偏上。Recursive 称这比通常用量少约 70 倍,暗示许多前沿实验室在后期训练中使用了上亿次展开。展开次数直接决定 RL 训练的算力开销,而他们通过自建合成数据流水线和难度递进的任务环境,提高了每次展开的信息密度,从而用更少的数据达到目标分数。
本地实测:能干活,但别期待全能
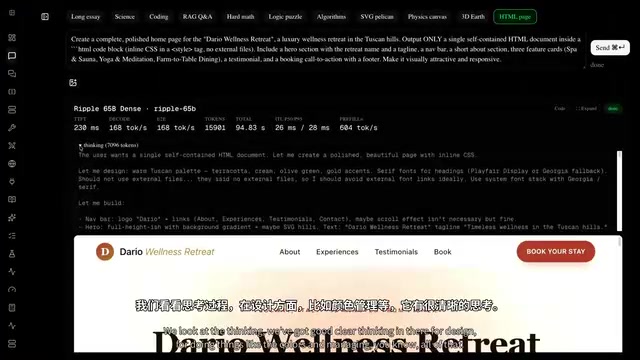
测试在DGX工作站上跑NVFP4版本,100%本地推理。配置正确之后,工具调用、智能体任务都能正常工作。初期在SGLang上遇到一些问题,修复后运行顺畅,简单任务生成速度很快。
有个有趣的发现:模型似乎不是在大众数据集上预训练的,输出带有自己的风格。在长论文写作测试里,它审视并批评自己生成的论文,找出几个错误且切中要害,而一些国产模型在此类任务上经常把好论文判成一堆错误。代价是思考过程消耗了约一万Token。
检索增强生成测试中答案简洁切中要害,思考约1700 Token。SVG生成任务上表现普通,风格独特但未必更好,明显不是优先优化的方向。Blender类任务给出基础渲染,但能坚持完成,消耗了数百万Token,成本峰值在70多。
这个模型适合谁
Ripple不是目前最强的开源代码模型,中国开源模型在基准上普遍更高。但它是美国实验室出品的开放权重模型中,最强的小型稠密模型,同时提供基础模型和公开训练配方,Apache 2.0许可对商用友好。
如果你需要能在本地跑、可微调、有完整训练细节可参考的模型,它值得关注。Recursive表示这是预览版,正在向更前沿水平扩展,后续可能有更强的产品。
对开源生态而言,更有价值的信号或许是:一家以芯片设计为主业的公司,用3200万美元和一份异常坦诚的技术报告,证明了非头部实验室也能从头训练出有竞争力的模型,并把过程摊开给所有人看。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。