6G显存跑8K图!复旦开源MOSS-Image生图模型实测

复旦OpenMouse与摩斯智能开源5亿参数文生图模型MOSS-Image,6G显存可跑,强文字与布局控制。
MOSS-Image是由复旦大学OpenMouse团队与上海摩斯智能联合开源的轻量文生图模型,参数仅5亿级别,采用DT(Diffusion Transformer类)架构,主打小显存、强文字与可控布局三项能力。据B站UP主演示,它可在6G显存、3060级别老显卡上本地流畅出图,并宣称支持8K分辨率输出。文字渲染是中英文精准、排版自然、无明显乱码错字,适合文字密集的促销海报与商品详情页;布局上通过结构化GSM指定元素坐标与大小,配合4K Tokens超长提示词实现一次成型。风格覆盖动漫与写实,适合电商运营与个人创作者低成本本地部署,但8K耗时与“零审查”等说法仍需读者自行验证与判断。
开源文生图领域最近出现了一个值得关注的选手——由复旦大学OpenMouse团队与上海摩斯智能联合开源的MOSS-Image(视频中口播为"Mouse Image")。它最吸引人的地方不是堆参数,而是把"小显存、强文字、可控布局"三件事同时做到了可用的程度。
据B站UP主的上手演示,这款模型参数只有5亿级别,采用DT架构,却能在6G显存的老显卡上本地流畅出图,甚至声称可生成8K分辨率图片。本文结合视频演示内容,梳理它的核心能力、适用场景与本地部署思路。
小参数为何能出好图:DT架构与工程取舍
5亿参数在今天的文生图模型里属于"轻量级",但它并不意味着画质妥协。视频作者多次强调"出图效果真的非常夸张",这句话背后其实是架构选择带来的效率红利。
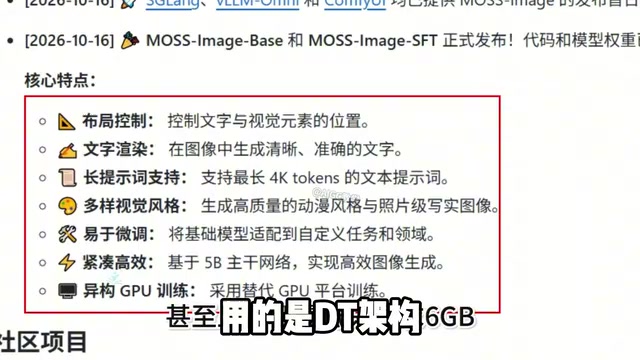
DT架构的价值在于用更紧凑的参数承载生成能力,把显存占用压到消费级显卡可以承受的区间。对个人创作者和小团队来说,这意味着不必租云算力、不必升级硬件,用一张3060级别的老卡就能把生图流程跑通。低成本本地推理带来的另一个好处是隐私与自由度——素材不出本机,生成节奏完全由自己掌控。
关于DT架构:DT通常指Diffusion Transformer(扩散Transformer),即用Transformer作为扩散模型的去噪主干网络,取代早期Stable Diffusion中常用的U-Net。Transformer的优点是scaling行为更清晰、对长序列建模更自然,也更容易与文本token、布局坐标等结构化条件做统一编码。相比U-Net依赖卷积与多尺度下采样,DiT类架构在参数利用效率上往往更高,这解释了为何5亿参数量级仍能保持可观画质。
关于“5亿参数”的量级参照:作为对比,SD 1.5约8.6亿参数(U-Net部分),SDXL约26亿,而主流闭源模型普遍在数十亿以上。5亿属于明显的轻量档,显存占用与推理延迟都会显著下降,但通常需要在训练数据质量、文本编码器选择与蒸馏策略上做补偿。
文字渲染:同级别开源模型里的短板补位
文字生成一直是开源文生图模型的软肋,常见问题是乱码、错字、字号忽大忽小。MOSS-Image在这方面的表现被视频作者形容为"直接吊打一众同级别开源模型"。
中英文都能精准渲染,字号与排版自然协调,即便是文字密集的促销海报、商品详情页,生成出来的文字也清晰锐利,全程无乱码无错字,甚至支持对字体风格做精准控制。
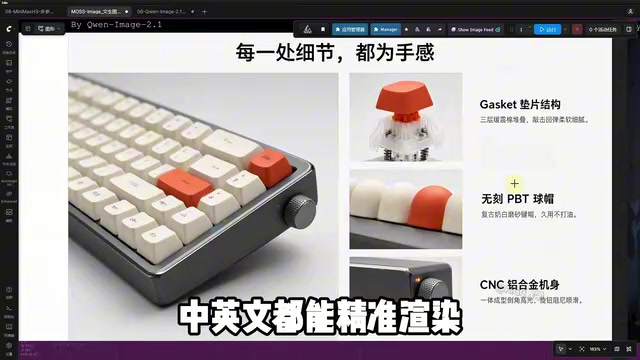
这一点对电商场景意义最大。传统流程里,AI生成背景后再用设计软件手动排版文字,是绕不开的一道工序;而文字能力可用的模型,可以把"出图"和"出字"合并成一步,海报初稿的产出效率会有明显提升。
结构化布局控制:一次成型,不用反复抽卡
除了文字,MOSS-Image另一个差异化能力是布局控制。它通过结构化GSM(视频中口播的表述)精准指定每个元素的坐标和大小,布局一次成型,不需要反复调试修改。
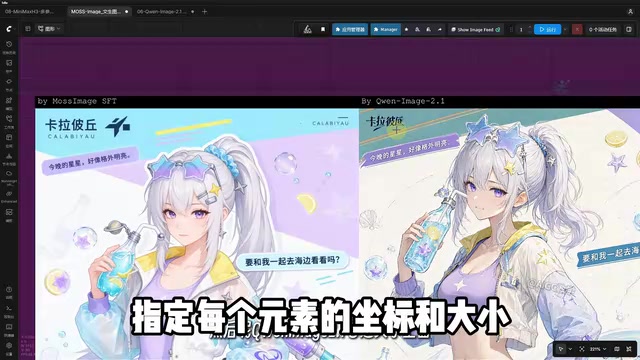
对做商品页、活动海报的创作者来说,这一点比单纯的画质提升更实用。常规文生图靠提示词"碰运气",构图不满意就重抽;而坐标级的布局约束把可控性交回到使用者手里,减少无效试错。配合4K Tokens的超长提示词支持,复杂的多元素画面也能用一段详细描述交代清楚。
关于“4K Tokens超长提示词”:这里的Token指文本编码器切分后的最小语义单元,4K Tokens大致相当于数千个英文单词或上万字的描述量级,远超多数文生图模型77或225 Tokens的常规上限。长提示词的实际价值在于可以把多个主体、各自的位置、属性、风格约束写成一份“规格说明”,而不必压缩成几句模糊形容词;但提示词越长,文本编码与注意力计算的开销也越高,需要配套的编码方案才能真正生效。
关于“结构化布局控制”与抽卡:常规文生图靠CFG与随机种子采样,构图由提示词语义隐式决定,结果不可复现;而坐标级布局约束相当于给扩散过程加入空间先验,常见实现方式包括将元素框编码为额外的条件token,或在注意力层施加区域掩码。这类方法能显著提升构图命中率,但对元素间的遮挡关系与光影一致性仍需模型自身能力兜底。
风格覆盖与硬件门槛
风格方面,动漫插画与写实风格都在覆盖范围内,属于"一模型多用"的思路。硬件门槛则被压得很低——视频里明确提到"3060老掉牙的显卡都能直接跑",6G显存即可本地流畅运行,并宣称能生成8K图片。
需要提醒的是,8K生成的具体耗时、显存峰值等细节,视频并未展开,实际体验会受显卡型号、驱动与推理配置影响。建议先用中等分辨率验证效果,再逐步拉高输出尺寸。至于"零审查"的说法,属于视频作者的宣传性表述,本地部署的模型行为仍取决于权重版本与使用方式,读者应自行判断合规边界。
关于“8K分辨率”的技术含义:扩散模型原生训练的通常只有512或1024分辨率,直接生成8K一般需要分块生成后拼接、潜空间超分(latent upscale)或多阶段级联放大,每一阶段都会引入额外显存与时间开销。因此“可生成8K”往往指支持高分辨率放大流程,而非单次前向推理直出。在6G显存下,高分辨率流程通常需要tiling(分块)与显存换出策略,实际耗时会明显高于1024级别出图。
本地部署思路与适用人群
视频本身以演示为主,未给出完整的环境配置步骤,但有几点可以确定:模型为开源权重,支持本地推理;对显存要求低,6G级别显卡即可起步;配合结构化布局与长提示词,工作流可以围绕"先定布局、再填内容"来组织。
适用人群比较清晰:电商运营需要批量产出带文字的商品图与促销海报;个人创作者希望在不增加硬件投入的前提下把AI生图纳入日常流程;以及需要布局精确可控的设计辅助场景。如果后续社区补齐部署脚本与工作流文件,这类小参数模型的实际落地速度会比想象中更快。
从趋势上看,MOSS-Image代表的是一条务实路线——不追求参数规模,而是在文字、布局、显存这几个真实痛点上做工程优化。对绝大多数内容生产者来说,能跑起来、能出可用的图,比榜单上的分数更有说服力。
相关推荐
Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。

Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。
谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。