74%独立店铺被AI购物忽略?开源工具CatalogPulse实测

AI购物代理依赖结构化数据,独立电商因目录缺陷面临新可见性鸿沟,开源工具CatalogPulse提供低成本审计修复方案。
文章指出,消费者越来越多地通过ChatGPT Search、Perplexity等AI代理直接提问购物,而AI代理依赖Schema.org JSON-LD等结构化数据读取商品信息。超过74%的独立电商店铺存在客户端渲染隐藏变体、缺失GTIN条码、Schema标记不完整等问题,导致商品难以被AI发现。企业级目录审计工具月费超2000美元,小商家无力承担。开发者为此构建了开源工具CatalogPulse,采用确定性DOM解析、SerpApi实时市场信号和Gemma 2开放权重模型三层架构,10秒内给出可发现性评分和修复代码。真实测试中,一家D2C店铺旗舰商品页从65分C级在两分钟内通过粘贴生成的JSON-LD完成修复。文章认为,这揭示了大品牌与独立商家之间正在形成的新AI可见性鸿沟。
当AI购物代理成为新入口,独立店铺正在"消失"
消费者正在改变购物习惯:不再逐一浏览搜索结果,而是直接向ChatGPT Search、Perplexity或Gemini提问——"帮我找一双US 10.5、120美元以内、有货的透气桉树纤维跑鞋"。这种方式对用户是效率提升,对商家却是一场无声的筛选。
大型品牌如Nike、Amazon的产品页包含完整的Schema.org JSON-LD结构化数据,AI代理可以顺畅读取。但独立Shopify店铺和D2C小商家经常遭遇三类问题:客户端JavaScript变体选择器隐藏了次要SKU,AI爬虫只能看到默认尺码;缺失GTIN/UPC条码导致商品无法被交叉验证;二手转售平台以过时或更低价格在搜索结果中压过官方店铺。
据开发者Meghana Shyam在DEV社区分享的数据,超过74%的独立电商店铺存在这类"静默目录掉队"问题。企业级目录可观测性平台月费超过2000美元,个人卖家和小型代运营团队根本无力承担。
Schema.org JSON-LD 是一种在网页中嵌入结构化数据的标准化格式,通过 <script type="application/ld+json"> 标签描述商品、价格、库存等实体信息。搜索引擎和AI代理无需理解页面视觉布局,即可直接读取这些机器可读的字段,从而准确判断商品属性。对于电商而言,完整的 Product 和 Offer 节点应包含名称、品牌、SKU、GTIN、价格、库存状态及变体列表。缺失这些字段,AI代理可能无法将商品纳入候选集,或在交叉验证时判定信息不可信。
GTIN/UPC 是全球贸易项目代码,用于唯一标识商品。在电商目录中,它充当商品身份锚点,使AI代理能将不同平台上的同一商品进行匹配和去重。缺失GTIN时,代理难以确认官方店铺与转售商列表是否指向同一实物,容易导致价格比较失真或推荐错误。
CatalogPulse:用开源方案填补AI可见性鸿沟
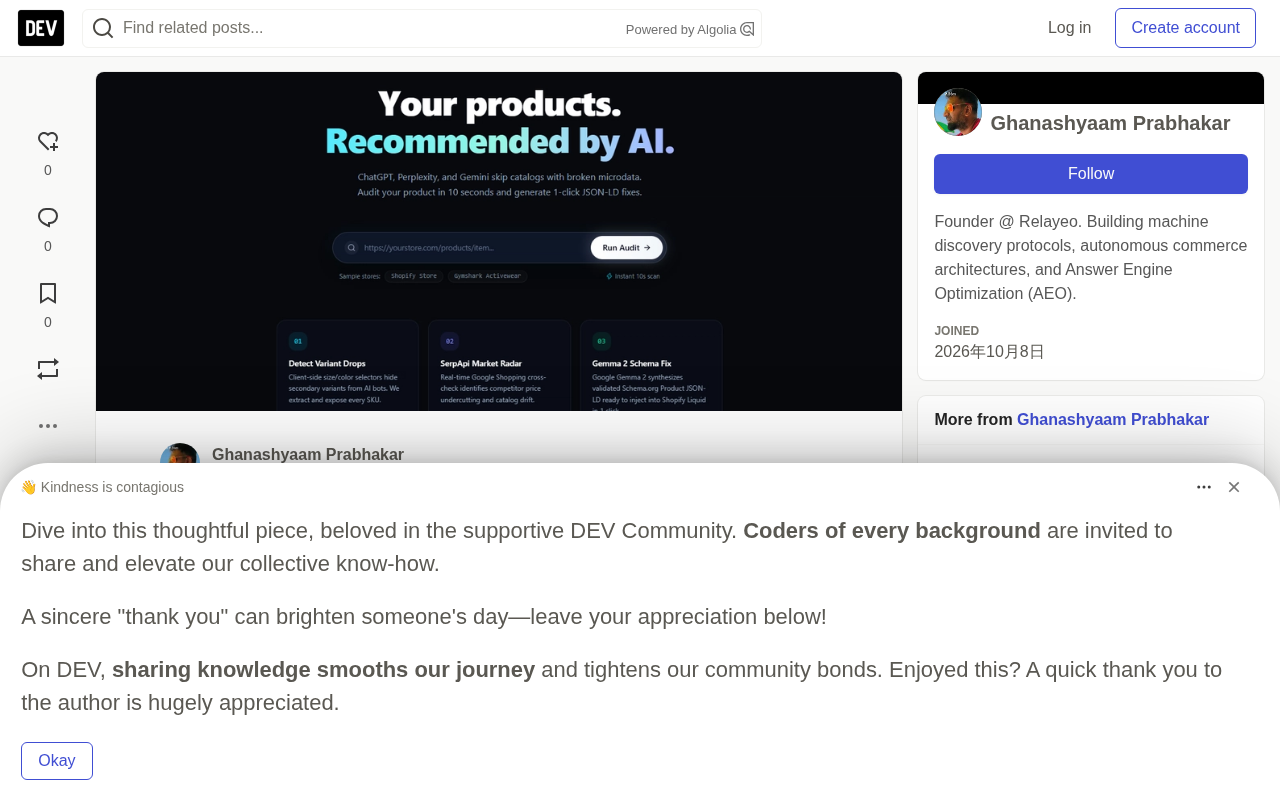
针对上述痛点,开发者构建了CatalogPulse——一个零安装、开源的AI电商Linter。商家输入商品URL,10秒内即可获得可发现性评分、具体缺陷清单,以及可直接粘贴使用的Schema.org Product JSON-LD修复代码。
该工具的技术路线值得关注:它没有让大模型"自由发挥",而是采用确定性解析与开放权重模型结合的架构,确保输出不会编造事实。
三层处理管线
第一层:确定性DOM解析(parser.ts)。 使用Cheerio在服务端抓取原始HTML,模拟非浏览器AI爬虫的读取方式,解析已有的JSON-LD Product/Offer节点和OpenGraph标签,标记缺失的GTIN、SKU以及变体遗漏问题。
第二层:实时市场信号(serpapi.ts)。 调用SerpApi的Google Shopping引擎,以"品牌+商品标题"构建查询,获取前5条市场列表和价格分布,用于发现转售商价格漂移和变体命名不一致。
第三层:开放权重AI审计(gemma.ts)。 基于Google Gemma 2(gemma-2-9b-it)模型,通过Groq或HuggingFace推理,将前两层提取的结构化遥测数据作为输入,输出严格JSON格式的评分、等级、关键缺陷、改进建议和生成的JSON-LD代码。

开放权重模型(Open-weight Model)指模型参数公开可下载、允许本地部署和修改的大语言模型,与仅提供API访问的闭源模型相对。Gemma 2是Google发布的开放权重模型系列,9B参数版本可在消费级GPU或通过Ollama、vLLM等推理框架运行。其优势在于边际调用成本极低、数据不出本地、行为版本可控;劣势是推理能力通常弱于前沿闭源模型,因此更适合执行结构化输出任务而非开放式推理。
为什么选择开放权重模型
作者在技术选型上给出了三条面向商业现实的理由。成本方面,一个独立商家可能拥有200到2000个SKU,如果每天对全部页面做结构化审计并调用前沿闭源API,9美元/月的微SaaS利润空间会被彻底吞噬。开放权重模型可以将边际成本压到接近于零,甚至完全在本地硬件上免费运行。
数据主权方面,代运营机构经常审计包含未发布产品、批发利润结构和内部SKU映射的测试店铺,Gemma权重开放意味着可以在本地Ollama或vLLM端点运行,客户目录数据不必经过第三方云服务。
可控性方面,闭源模型的行为可能悄然变化或端点被弃用,而确定性解析器加实时市场 grounding 加开放权重JSON合成的组合,给了小商家一个真正可控的工具链。
SerpApi 是一个实时搜索引擎结果抓取服务,通过API返回Google Shopping、Google搜索等页面的结构化结果。在CatalogPulse中,它用于获取商品在公开市场上的实际列表和价格分布,为审计提供外部校准信号。这种“市场 grounding”使工具不仅能检查页面自身声明是否完整,还能发现转售商价格漂移、变体命名不一致等跨平台问题。
真实测试:从65分到两分钟修复
作者用一位经营独立D2C鞋服店铺的朋友做了首轮测试。该店铺旗舰产品页在CatalogPulse中获得65分(C级)。店铺实际有6个尺码在售,但Shopify主题只在根Offer节点中输出了默认变体,且未声明gtin13属性。话说回来,SerpApi面板显示Poshmark上的二手转售商以半价列出同款商品。
修复过程并不复杂:将CatalogPulse生成的JSON-LD代码块粘贴到主题头部,两分钟内页面即通过验证,包含完整的Brand、SKU和Offer属性。整个过程没有聘请月费500美元的SEO顾问。
这位用户随后提出的需求是:"能不能每周日晚爬取我的整个sitemap.xml,如果主题更新破坏了结构化数据就发邮件通知我?"作者表示这已在路线图中。
独立电商的AI可见性需要新工具箱
CatalogPulse的意义不在于又一个SEO检查器。它揭示了一个正在成形的结构性差距:AI购物代理的抓取方式与传统搜索引擎不同,对结构化数据的完整性和机器可读性要求更高。大型品牌有预算购买企业级可观测性服务,独立商家则缺乏同等工具,而AI导购的推荐结果会直接转化为销量。
开源、低边际成本、可本地部署的组合,为这一群体提供了可行的中间路径。该项目的架构也提供了一个可复用的范式——确定性提取保证事实基础,实时市场数据提供外部校准,开放权重模型只负责结构化输出,三者各司其职。
对于运营Shopify店铺、为客户搭建电商站点或拥有产品副业的开发者而言,这个工具值得用实际商品URL跑一次评分。毕竟,当越来越多的消费者把"帮我买"交给AI代理时,商品能否被看见,首先取决于机器能否读懂它。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。