74M参数开源模型在测试中部分超越Jev AI

Fastino AI 的 7400 万参数 Glider 2.5 在部分防护栏测试中超越 Jev AI,展现小模型在特定任务上的竞争力。
文章介绍了 Fastino AI 推出的 Glider 2.5 系列模型,参数量覆盖 7400 万到 3 亿,可在消费级硬件上本地运行。据一档 YouTube 频道的实测分享,7400 万参数的版本在部分防护栏基准测试中表现优于被对比的 Jev AI,并被用于玩《Doom》游戏,体现其在实时闭环任务中的潜力。作者同时提醒,该测试为单一来源的初步观察,缺乏完整基准名称、分数差距与测试环境细节,结论应作为方向性参考。对开发者而言,案例说明模型规模并非唯一变量,在分类、过滤、规则判断等任务上,精调过的小模型具备高性价比,适合本地与边缘部署,但生产采用前仍需在自有数据上完整评测。
小模型的大能量:Glider 2.5 的实测表现
在大型语言模型动辄数百亿参数的今天,一个仅有 7400 万参数的模型却在部分测试中超越了被拿来对比的 Jev AI。据 YouTube 频道分享的测试内容,来自 Fastino AI 的最新模型 Glider 2.5 在防护栏(guardrail)基准测试中,至少在几个场景下表现优于 Jev AI。更令人意外的是,这个 7400 万参数的版本还被用来在测试中玩《Doom》游戏,这本身就说明了它在消费级硬件上的可运行性。
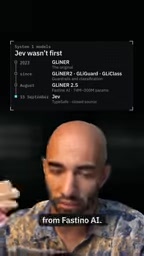
视频作者明确表示,Glider 系列并非全新概念,但 Glider 2.5 是最新迭代。他在测试中使用了这一版本,并给出了“表现非常好”的评价。真正引发讨论的,是模型规模与性能之间的反差——在特定任务上,小模型不必是“缩水版”,它可以有自己的优势场景。
从 74M 到 300M:消费级硬件上的可行性
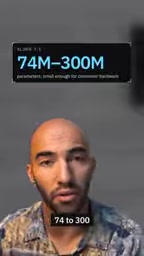
Glider 2.5 系列涵盖 7400 万到 3 亿参数的范围。据视频中的描述,这些模型“非常小,并且很容易在消费级硬件上运行”。7400 万参数的模型尤其突出,因为它小到可以在普通设备上流畅部署,同时又保留了可用的推理能力。
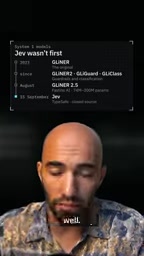
这一规模的模型意味着什么?对于开发者而言,本地运行、快速迭代和低延迟推理成为可能,而不必依赖云端 GPU 集群。对于研究者来说,它提供了一个研究“小模型能力边界”的实用样本。参数量的压缩并不必然导致能力归零,关键在于训练目标和架构设计是否与任务匹配。
防护栏测试中的交叉验证
视频作者提到,在防护栏基准测试中,Glider 在“至少几个”测试上超过了 Jev AI。这并非全面碾压,而是特定维度的领先。你可能没注意到,这种对比测试的结论需要谨慎看待:基准测试的选择、提示词的设计、评分标准都会影响最终排名。视频本身没有公布完整的测试方法和全部指标,因此“部分超越”的结论更适合作为方向性参考,而非定论。
从多源信息来看,目前关于 Glider 2.5 与 Jev AI 的对比主要来自这一 YouTube 频道的实测分享。原始内容中未提及具体的基准名称、分数差距或测试环境细节,因此无法进行更深入的交叉验证。可以确认的是,测试者本人对 Glider 2.5 的表现持正面评价,并认为其在防护栏任务上有竞争力。
什么是防护栏(Guardrail)基准测试?
防护栏(guardrail)在大模型应用中指一套用于约束模型输出的安全机制,典型目标是拦截有害内容、越狱提示、敏感信息泄露或偏离任务范围的回答。防护栏基准测试则通过构造大量对抗性提示(如越狱模板、诱导性提问、边界指令)来评估模型或过滤器的拦截率、误报率与响应延迟。与通用能力评测不同,防护栏任务本质上是分类与判定问题,对模型的参数规模要求不高,却高度依赖训练数据的覆盖面和指令微调的针对性。这正好解释了为何一个 7400 万参数的模型可能在这一维度上与更大模型持平甚至领先——任务越聚焦,规模红利越容易被数据质量和任务对齐所抵消。
玩《Doom》意味着什么
视频中提到,7400 万参数的 Glider 模型被用于在测试中玩《Doom》。这听起来像是一个趣味演示,但它背后反映的是模型作为智能体(agent)在实时决策场景中的潜力。游戏环境要求模型在连续帧中做出反应,这对推理速度和上下文处理提出了不同于静态问答的要求。小模型在这方面反而有优势——参数量小,推理延迟低,更容易满足实时交互的需求。
当然,玩《Doom》的表现不能直接等同于通用能力。它更多说明的是:小模型可以在特定闭环任务中发挥作用,而这类任务恰恰是许多实际应用(如自动化控制、实时过滤、边缘推理)的缩影。
小模型作为智能体(Agent)的实时约束
游戏智能体与静态问答的核心差异在于闭环时序:模型需要在每一帧或固定时间间隔内完成感知、决策与输出,任何一次推理延迟都会累积为动作滞后。以《Doom》为例,若模型单次推理耗时超过数十毫秒,智能体就可能错失射击或躲避窗口。7400 万参数的模型在消费级 CPU 上即可达到较高吞吐,这使得端到端的实时控制链路成为可能,而无需将推理卸载到云端。这也解释了为何小模型在边缘推理、实时内容过滤、自动化控制等场景中被反复提及——它们的能力上限或许有限,但延迟与部署成本的优势在闭环任务中往往比绝对能力更重要。
对开发者的启示
Glider 2.5 的案例指向一个务实的趋势:模型规模不是唯一变量,任务匹配度同样关键。7400 万参数的模型能在防护栏测试中与更大的模型掰手腕,说明在分类、过滤、规则判断这类任务上,精调过的小模型可以做到性价比极高。对于需要在本地或边缘设备部署 AI 能力的团队,这类模型值得纳入评估清单。
同时也要保持理性:视频测试是单一来源的初步观察,样本量和测试范围有限。如果要在生产环境中采用,仍需在自己的数据分布上做完整评测。小模型的上限在哪里,目前还没有系统性的答案,但 Glider 2.5 至少提供了一个值得关注的方向。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。