763B MoE 塞进两张 96GB 显卡:闲置专家丢进主机内存

两张 RTX PRO 6000 跑 763B MoE:用 per-expert offload 把专家放主机内存,量化后精度对齐官方 API。
文章复盘了在两张 RTX PRO 6000 Blackwell 上部署 763B MoE 模型(DeepSeek-V4.1-Flash)的完整过程。3-bit 量化后每卡仍需 102.1 GiB,超过 95.6 GiB 显存上限而 OOM。方案利用 MoE 每 token 仅激活 6/384 专家的特性,把 4,608 个闲置专家和查找表卸载到主机内存,经 UVA over PCIe 读取,每卡降至 72.4 GiB。vLLM 原生 UVA offload 看似等价却会崩溃,能跑通的是 EXL3 + ExLlamaV3 + vllm-exl3 + Diffbot per-expert plan 的组合栈。文章还强调 PCIe/NUMA 拓扑会带来 1.17 至 1.51 倍损失,应以每条流而非整机吞吐衡量容量,并给出量化后三项基准与官方 API 差异均在置信区间内的验证结果。
一张显卡 95.6 GiB 显存,模型压缩到 3 bit 后每张卡仍要 102.1 GiB——这个差值不算大,但足以让启动连续两次死在 OOM 上。整个方案的核心想法是:MoE 的专家大部分时间是闲置的,那就别让它们占着卡。
显存缺口从哪里来
DeepSeek广告-V4.1-Flash 有 763B 参数。BF16 权重约 1.5 TB,官方 FP4/FP8 checkpoint 是 475.2 GiB,coolbho3k 的 3-bit EXL3 包压到 309.3 GiB。两张 RTX PRO 6000 Blackwell 加起来 192 GB,压缩到这个程度还是差了一口气。
关键在于模型的 MoE 结构:40 层每层有 384 个路由专家,但每个 token 每层只走 6 个。也就是说绝大多数专家在任意时刻都是闲着的。Diffbot 的方案把 15,360 个路由专家中的 4,608 个,加上查找表(两张 Engram 表用 int4,以及 embedding),整体搬到主机内存。GPU 通过 UVA(统一虚拟寻址)经 PCIe 直接读取这些数据。每张卡占用降到 72.4 GiB,剩下的空间留给 KV cache。
这个数字值得记住:如果只关注“权重能不能装下”,很容易忽略 KV cache 才是多用户场景的真正瓶颈。
UVA(统一虚拟寻址) 是 NVIDIA CUDA 提供的一种机制,让 GPU 和 CPU 共享同一套虚拟地址空间。启用后,GPU kernel 可以直接解引用指向主机内存的指针,数据通过 PCIe(或 NVLink-C2C)按需传输,而不需要显式调用 cudaMemcpy 搬进显存。这带来两个后果:一是显存占用大幅下降,因为权重物理上留在主机 DRAM;二是每次访问都走 PCIe,带宽远低于 HBM(PCIe 5.0 x16 约 64 GB/s 单向,而单张 Blackwell 的 HBM 带宽在 TB/s 量级)。因此 UVA offload 是否划算,取决于被卸载的数据访问频率——这正是 MoE 专家适合被卸载的原因。
KV cache 是大模型推理时缓存历史 token 的 Key/Value 张量,用来避免每生成一个新 token 都重算整个上下文。它的体积随并发请求数 × 序列长度 × 层数线性增长。在长上下文多用户场景下,KV cache 常常和权重一样甚至更占显存。把权重卸载到主机内存,本质上是为 KV cache 腾出空间,从而支撑更高的并发和更长的上下文。
同一个思路,vLLM 原生方案反而跑不通
最有迷惑性的地方在这里。vLLM 本身也有 UVA offload,看起来做的是同一件事。但把同样的数据放到主机内存后,KV block size 设为 64 时初始化就崩溃,设为 128 虽然能启动,第一个请求就挂了。标准 vLLM 安装无法在这两张卡上服务这个模型。
能跑起来的是一套组合,每一层都有对应作者:DeepSeek 出权重,coolbho3k 做到 3-bit 量化,turboderp 写了 EXL3 格式和 ExLlamaV3 推理库,Victor Cruz 写了 vllm-exl3 作为接入 vLLM 的桥接层,Diffbot 在 vLLM 之上设计了按专家的拆分方案、启动流程和 kernel,InferenceKey 把这些拼起来并做了测量。
“看着等价但失败”这一点对自部署的人很重要:vLLM 原生 offload 和专用 per-expert plan 表面上都是把权重放主机内存,底层的数据布局和读取路径完全不同。
EXL3 是 ExLlamaV3 引入的一种 3-bit 量化格式,属于 EXL2 的后继。它用更激进的位宽和更精细的量化网格来压缩权重,目标是让大模型塞进消费级或多卡受限显存。ExLlamaV3 是 turboderp 维护的推理库,负责解释 EXL3 权重并执行前向计算。vllm-exl3 是 Victor Cruz 写的桥接层,把 ExLlamaV3 的量化 kernel 接入 vLLM 的调度和 PagedAttention 体系,使得 vLLM 能加载 EXL3 格式的模型。这套栈和 vLLM 原生量化路径(如 AWQ、GPTQ、FP8)是并行的两套实现,数据布局、kernel 选择、内存管理都不同,因此不能互换。
按专家拆分(per-expert plan) 指的是不把整个 MoE 层当成一个整体对待,而是以单个专家为单位决定它的驻留位置(显存或主机内存)和读取路径。每层 384 个专家中只有 6 个被激活,per-expert plan 允许只把常被路由到的专家留在 GPU 上,其余按需从主机内存拉取。这比 vLLM 原生的“整层或整块 offload”粒度更细,是这套方案能跑通而原生方案崩溃的关键差异之一。
PCIe 拓扑:容易被忽略的性能变量
专家放在主机内存后,GPU 到这块内存的路径直接决定了一部分速度。在一台租来的机器上,两张 GPU 挂在不同 NUMA 节点上,推理速度慢了 1.17 到 1.51 倍。动手测之前先跑一下:
nvidia-smi topo -m

**NUMA(非统一内存访问)** 描述的是多路 CPU 系统中,每个 CPU socket 拥有自己的本地内存,访问本地内存比访问另一颗 CPU 挂载的远程内存更快。GPU 通过 PCIe 插槽连接到特定 CPU 的 PCIe 根复合体上,因此天然归属于某个 NUMA 节点。当两张 GPU 分别挂在不同 NUMA 节点时,一张 GPU 访问另一节点上的主机内存,需要跨 socket 互联(如 Intel UPI 或 AMD Infinity Fabric)再走 PCIe,延迟和有效带宽都下降,实测造成 1.17 到 1.51 倍的速度损失。

**`nvidia-smi topo -m`** 会打印一张拓扑矩阵,标明每张 GPU 之间、以及 GPU 与 CPU/NUMA 节点之间的连接类型(如 `NODE`、`SYS`、`PHB`、`PIX`)。在读这张表时,`SYS` 表示跨 NUMA 节点,`NODE` 表示同节点。对于依赖主机内存 offload 的推理方案,应尽量让卸载到主机内存的专家数据所在的 NUMA 节点与访问它的 GPU 处于同一节点,否则性能损失会被误算到 offload 机制本身头上。
# Shows how each GPU connects to the other GPU and to the CPUs.
# GPUs on different NUMA nodes ran 1.17x to 1.51x slower here.
否则很容易把“机器本身跨 NUMA”这笔账算到 offload 头上。
该测的是每条流的速度,不是整机总量
开发者感受到的是自己会话的速度,不是整台机器的总吞吐。所以要测 tokens per second per stream——一条流就是一个 agent 会话。文章把标准定在每人 40 tok/s。agent 轮次上的中位数和第 5 百分位数据如下:
| 并发 agent 数 | 中位数 tok/s | p5 tok/s |
|---|---|---|
| 1 | 186 | 134 |
| 4 | 59 | 52 |
| 6 | 40 | 34 |
四条流并发、留 10% 余量,就是这台机器的容量。长上下文对生成速度影响很小:4K 上下文后每个输出 token 中位耗时 7.6 ms,256K 之后是 8.3 ms。真正贵的是第一次读长 prompt——128K token 要 18.33 秒——所以 prefix caching 很关键。256K 前缀已缓存、4 个用户的情况下,95% 的请求在 1.66 秒内拿到第一个 token。
座位模型也值得看一眼:某开发者用 Claude Code 一周,模型实际生成约 2.8 小时,占一周的 1.7%。按 8 小时窗口内每人独立地有 7.1% 概率活跃来算,19 人团队超过 4 条并发流的概率不超过 1%。但同事的作息并不独立,这个估算偏乐观,而且只基于一个人的使用数据。
prefix caching(前缀缓存) 是指对多个请求共有的 prompt 前缀只做一次 prefill,把对应的 KV cache 复用给后续请求。在 agent 场景里,系统提示、工具定义、历史对话往往被反复拼接进每次请求,前缀高度重合,因此 prefix caching 的收益极大。文章给出的 128K token 首次读取需 18.33 秒,正是 prefill 阶段的成本;一旦前缀被缓存,后续请求可直接从 KV cache 开始解码,95% 请求在 1.66 秒内拿到首 token。这也是为什么长上下文系统中,缓存命中率往往比单次 prefill 的绝对速度更能决定用户体验。
中位数与 p5 是评估服务质量的两种分位指标。中位数代表典型体验,p5(第 5 百分位)代表最慢的 5% 请求速度,反映尾端体验。对 agent 会话来说,单次极慢的响应会拖垮整轮交互,因此 p5 比平均值更有参考价值。表中 4 条并发流的中位数 59 tok/s、p5 52 tok/s,说明大多数时候体验稳定,但评估容量时应当以 p5 而非中位数为准,再留出余量。
量化之后,答案还对不对
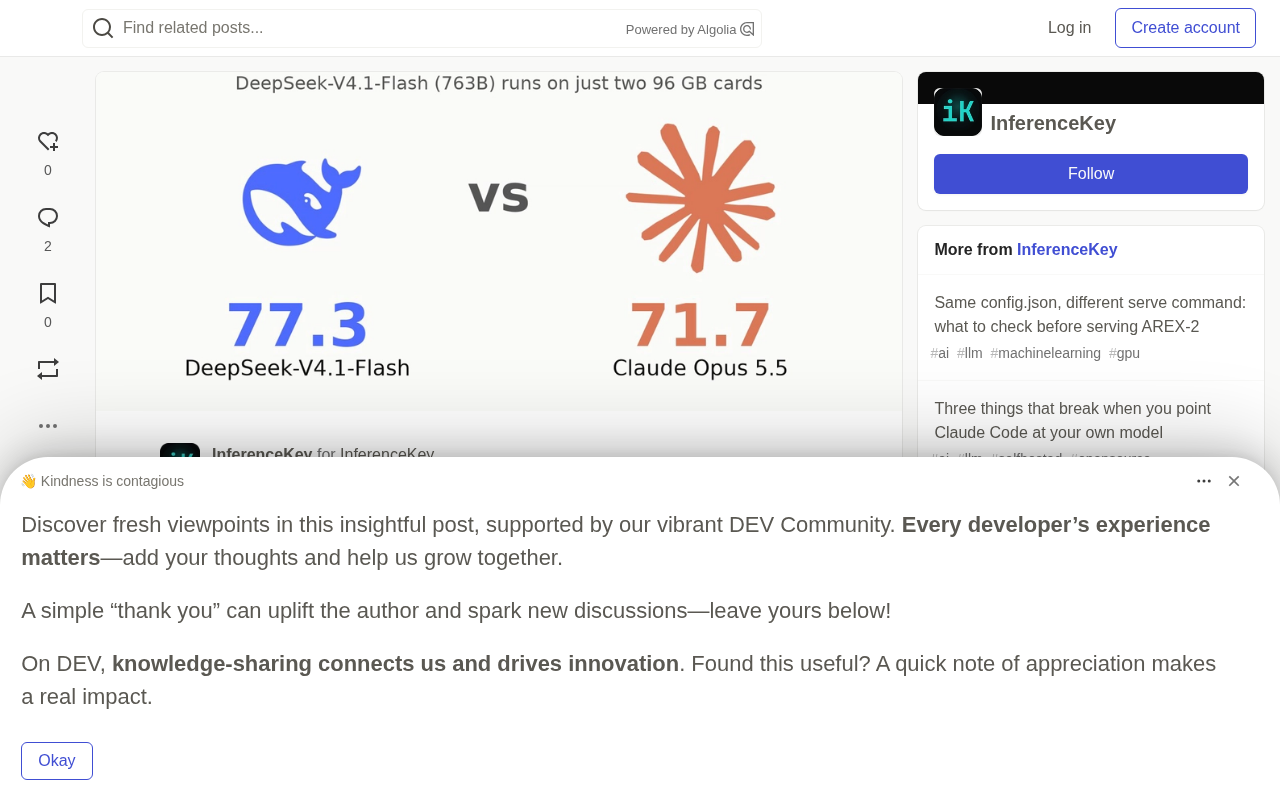
3 bit 会改变模型输出,所以必须和参考做对比:三个基准的固定子集,关闭 thinking,对照 DeepSeek 官方 API。GSM8K(数学)两边都是 0.960。IFEval(指令遵循)+0.013,区间 [-0.013, +0.047]。HumanEval(代码)-0.018,区间 [-0.049, +0.012]。两个区间都包含零,而在大约 150 道题上,一两个点的差异属于随机波动。LiveBench agentic coding 的 77.3 分(69 个模型中第一)是未量化模型在最大 effort 下的成绩,不是量化后的。
还没解决的问题
所有实验只跑了一次启动,agent 轮次是合成的而非真实会话采集。也还没有“整个模型放进大机器显存”的基线对照——那个实验已经写成 E9。方法细节在论文(PDF)里。
对打算给团队配 coding agent 机器的人来说,这套方案的意义不在于“两张卡跑 763B”这个标题,而在于它给出了一个可复用的判断路径:先看 MoE 的专家激活比例,再算主机内存和 PCIe 带宽的账,最后按每条流而不是整机来评估容量。
相关推荐

不写代码,用AI规划生产级应用系统架构
不写一行代码,如何用 AI 规划生产级应用系统架构?本文拆解 AI 私人教练应用的数据库建模、Agent 端点设计、聊天记录存储与分层记忆架构,讲清何时该用 AI、何时该提前生成,帮你从 vibe coding 迈向可维护的生产级开发。

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。